Saúde das sessões SMPP: como detetar degradação antes de perder mensagens
Um guia operacional para distinguir uma sessão SMPP ligada de uma sessão realmente saudável, interpretar sinais de transporte e agir sem confundir conectividade com entregabilidade.
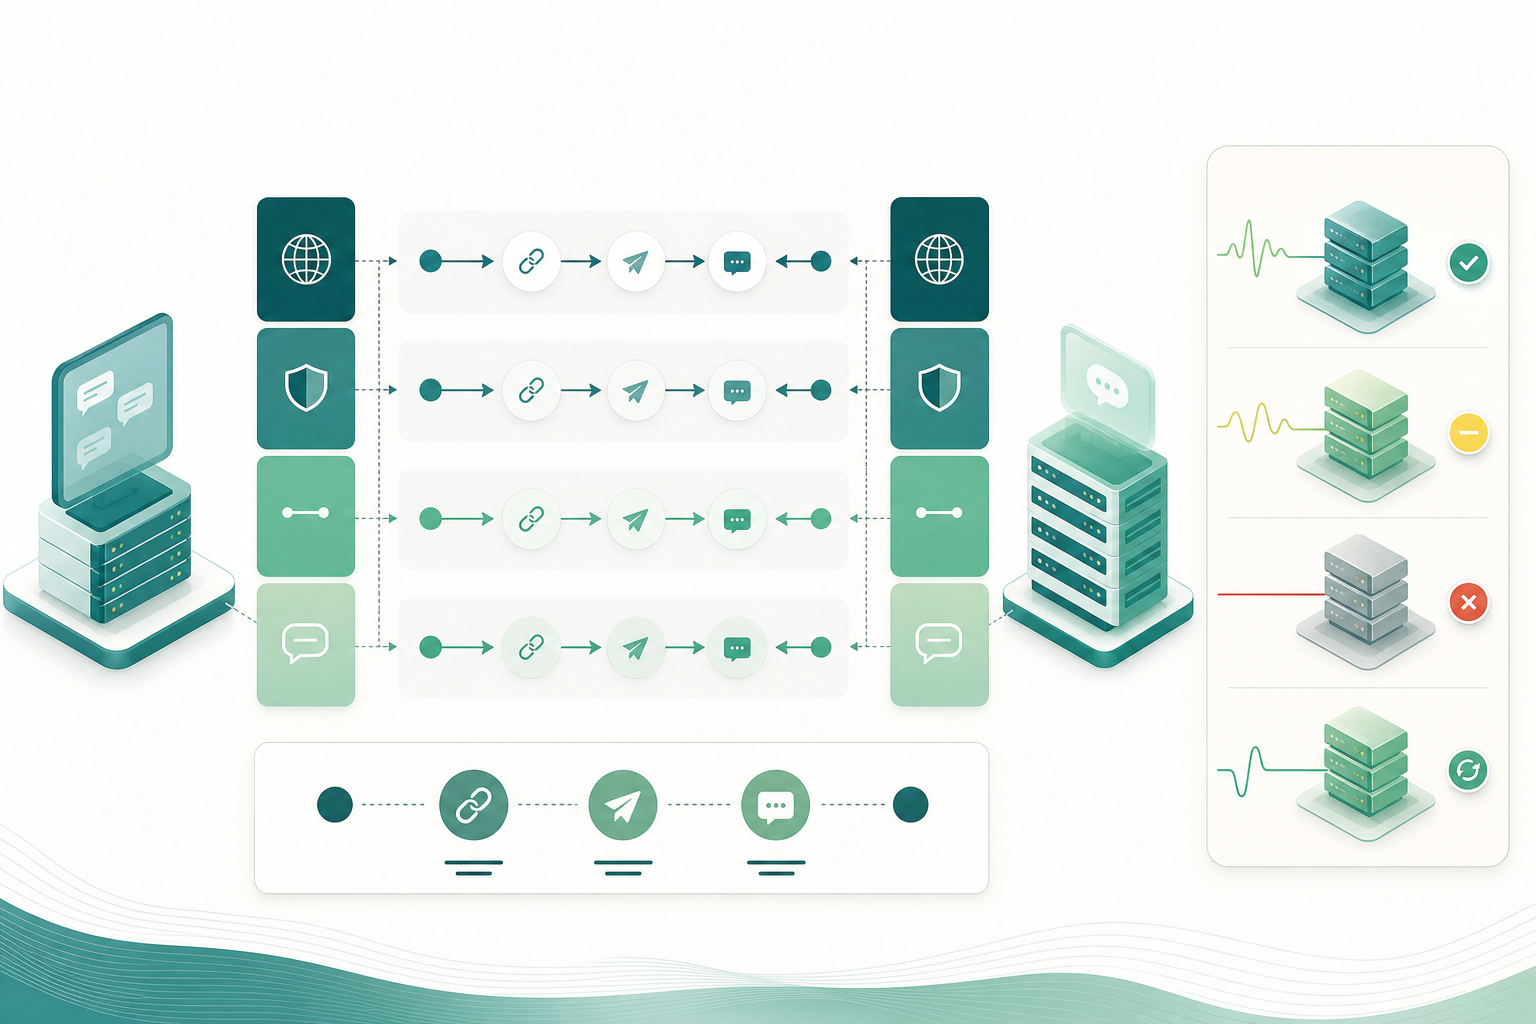
Uma sessão ligada nem sempre é uma sessão saudável
A saúde das sessões SMPP deve ser avaliada por camadas. Primeiro, existe uma ligação de rede, normalmente TCP/IP. Depois, o ESME envia um pedido Bind para abrir a sessão SMPP no modo necessário. O facto de o TCP estar estabelecido e de o Bind ter sido aceite confirma que essas duas etapas foram concluídas, mas não demonstra que a sessão responda normalmente sob carga nem que as mensagens futuras sejam aceites ou entregues.
Uma sessão pode manter um bind aparentemente ativo enquanto os tempos de resposta aumentam, os pedidos sem resposta se acumulam ou surgem encerramentos e resets de socket. Por isso, o sinal de “ligada” é necessário, mas insuficiente. A operação deve observar a capacidade real de trocar PDUs correlacionadas dentro dos tempos esperados.
Também não se deve equiparar a saúde da sessão ao resultado final de um SMS. A aceitação de um submit_sm é observada no respetivo submit_sm_resp e command_status. A fase posterior, caso seja solicitado um recibo de entrega, é observada através de DLR transportados em deliver_sm ou data_sm. Um bind correto, um socket aberto ou um enquire_link_resp não substituem essas evidências.
- TCP disponível: confirma a camada de transporte, não a abertura da sessão SMPP.
- Bind aceite: confirma que o SMSC aceitou a sessão e o modo solicitado.
- Respostas operacionais: mostram se as PDUs, incluindo submit_sm, recebem uma resposta correlacionada.
- DLR: fornecem informação posterior sobre o estado comunicado pelo SMSC; não devem ser confundidos com uma prova independente de receção no terminal.
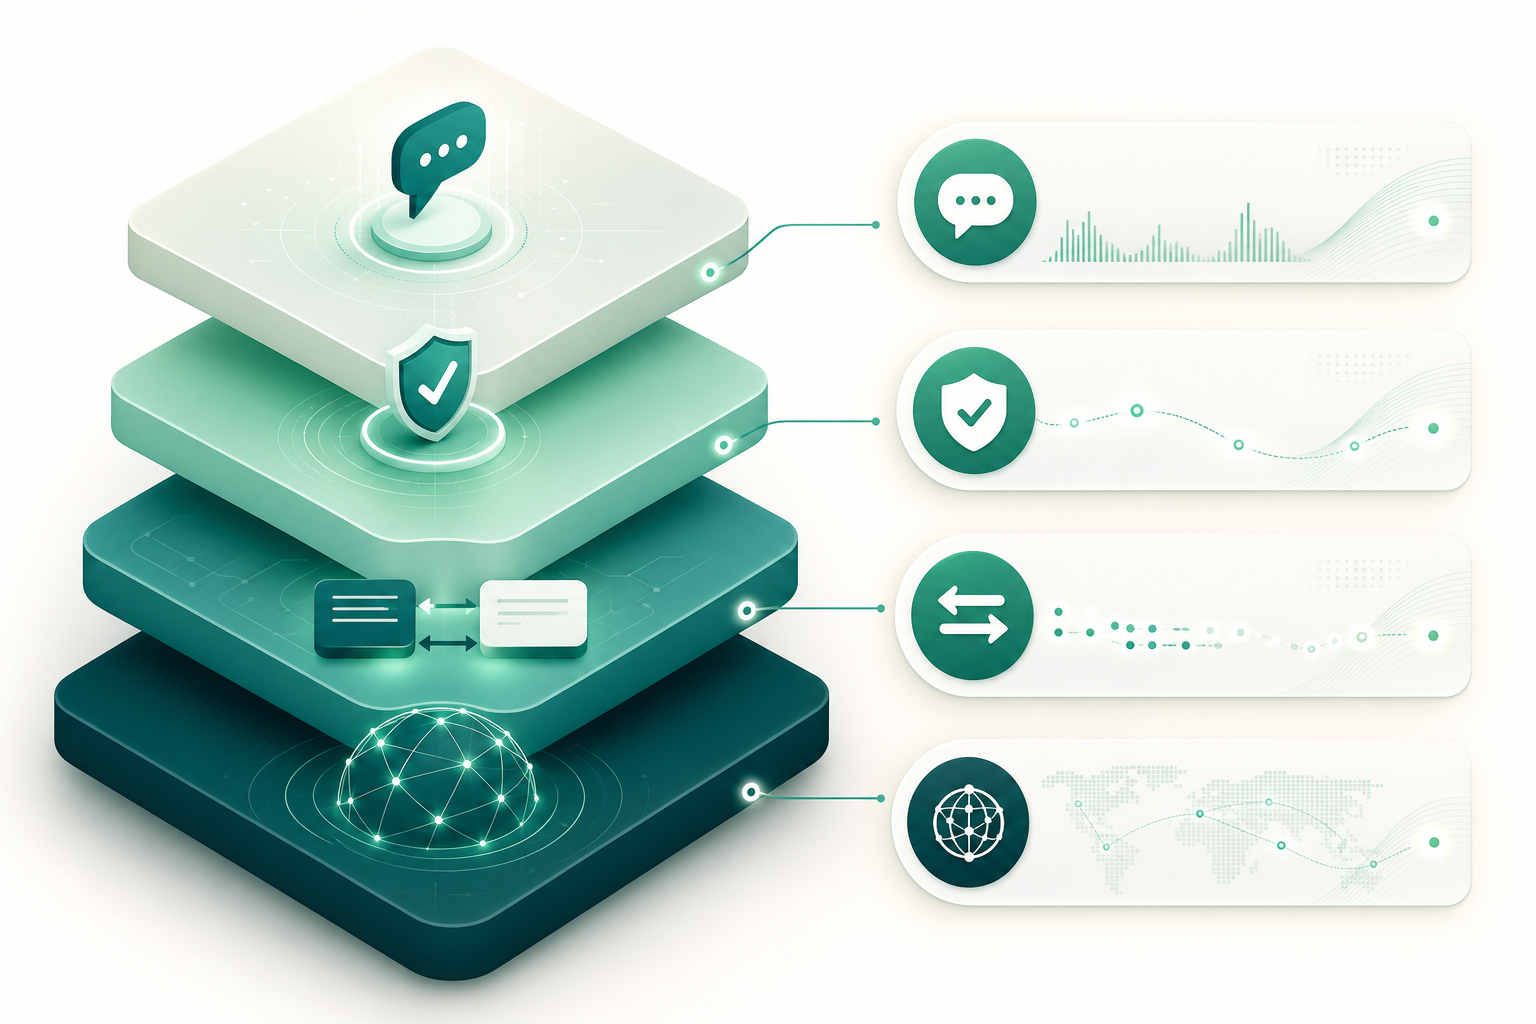
Componentes observáveis: transporte, bind, pedidos pendentes e respostas
O SMPP funciona através de PDUs de pedido e resposta. Com exceção de alert_notification, cada operação deve ter a sua resposta associada. O campo sequence_number permite correlacionar um pedido com a respetiva resposta e deve ser o identificador principal para medir o tempo de resposta e contabilizar operações pendentes.
Não convém associar respostas pela ordem de chegada. O SMPP permite que cheguem fora de ordem, pelo que uma implementação deve resolver a correlação por sequence_number. Esta precaução é especialmente importante em sessões com várias operações simultâneas.
O protocolo não define um máximo universal de operações pendentes. Esse limite depende da implementação do SMSC; a especificação indica, como orientação, não exceder dez operações simultâneas pendentes. Em produção, o limite operacional deve ser acordado com o fornecedor sempre que possível e validado face ao comportamento real de cada sessão.
- Identificador da sessão e endpoint remoto.
- Estado TCP: ligado, encerramento, erro ou reset.
- Resultado e duração do bind.
- sequence_number, command_id e command_status.
- Marca temporal de envio e receção de cada PDU.
- Número de pedidos pendentes por tipo de operação.
- RTT de enquire_link e RTT de submit_sm_resp, registados separadamente.
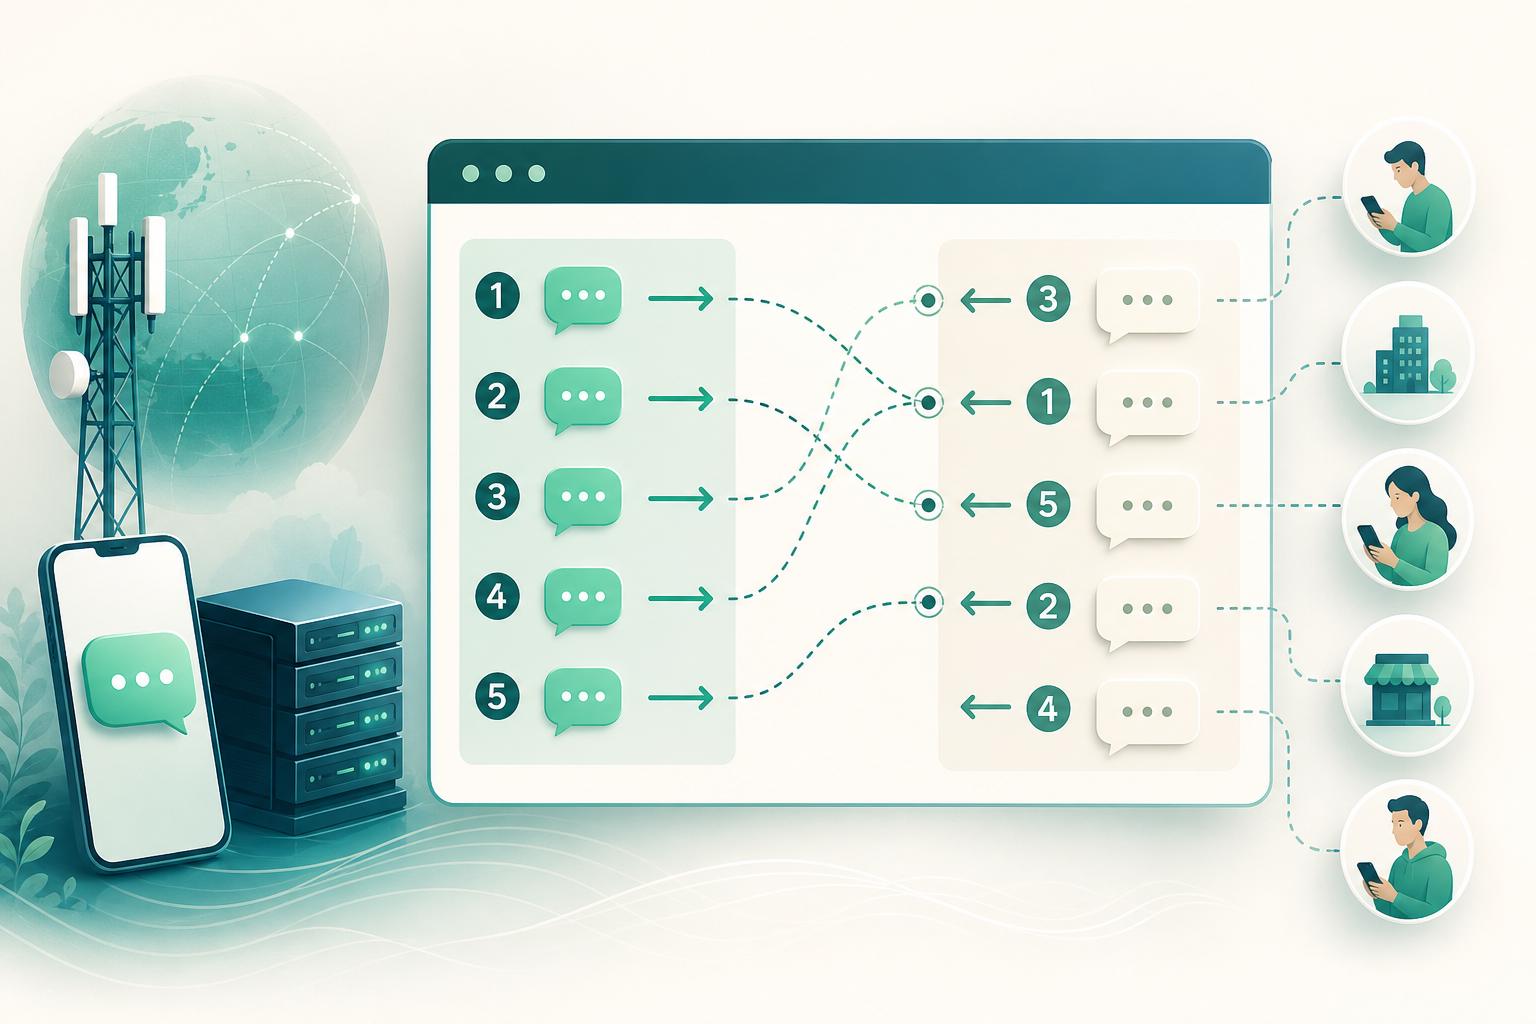
Modos de bind e as suas implicações operacionais
O modo de bind define a direção de tráfego permitida numa sessão. bind_transmitter é utilizado para tráfego do ESME para o SMSC. bind_receiver é utilizado para tráfego do SMSC para o ESME. bind_transceiver permite uma troca bidirecional numa única sessão.
Se um ESME utilizar sessões separadas para enviar e receber, necessita de duas ligações de rede e duas sessões SMPP: uma Transmitter e uma Receiver. Operacionalmente, ambas devem ser monitorizadas de forma independente. Uma sessão de envio saudável não confirma que a sessão recetora esteja disponível para receber DLR ou outras PDUs recebidas.
Numa sessão Transceiver, o facto de partilhar a ligação não elimina a necessidade de medir os dois sentidos. Devem ser observados separadamente os pedidos enviados, as respetivas respostas, as PDUs recebidas e as respostas que o ESME devolve a essas PDUs quando aplicável.
- Transmitter: monitorize submit_sm e os respetivos submit_sm_resp.
- Receiver: monitorize a receção de deliver_sm ou data_sm e a resposta devolvida pelo ESME.
- Transceiver: monitorize ambos os sentidos e não reduza a saúde a uma única métrica agregada.
- Verifique se o modo de bind corresponde à função operacional necessária para a rota ou ligação.
enquire_link: uma sonda de sessão, não uma prova de entregabilidade
O enquire_link permite que um ESME ou SMSC verifique o caminho de comunicação ao nível da aplicação SMPP. Quando chega um enquire_link_resp com o mesmo sequence_number, há evidência de que a sessão conseguiu trocar essa verificação naquele momento.
Este sinal é útil para monitorizar inatividade, detetar degradação do RTT e descobrir mais cedo uma ligação parcialmente aberta. Em TCP, uma extremidade pode fechar ou abortar uma ligação sem que a outra o saiba de imediato; o problema pode tornar-se visível ao tentar transmitir dados e receber um reset. Uma sonda SMPP ajuda a criar atividade na aplicação, mas não elimina toda a incerteza.
Não utilize enquire_link como substituto de submit_sm. Um enquire_link_resp não confirma que o SMSC aceite tráfego de envio, que consiga processá-lo numa determinada rota ou que um destinatário final receba uma mensagem. Meça o RTT de enquire_link separadamente do RTT de submit_sm_resp, para evitar que uma sonda saudável oculte degradação na aceitação de mensagens.
Além disso, uma única falha de sonda não deve transformar-se automaticamente na conclusão de que o par está indisponível. A decisão deve considerar recorrência, duração, sinais de socket, estado do bind e o comportamento de pedidos reais.
- O que verifica: troca SMPP ao nível da aplicação na sessão ativa.
- O que não verifica: aceitação de submit_sm, capacidade da rota, DLR ou entrega final.
- O que medir: envio, receção de enquire_link_resp, RTT, timeout e sequence_number.
- O que evitar: declarar indisponibilidade devido a uma única sonda falhada sem sinais adicionais.
Sinais de degradação precoce a monitorizar
O primeiro sinal costuma ser uma alteração persistente em relação à referência da própria sessão, e não necessariamente um erro explícito. Um aumento sustentado do RTT de enquire_link_resp pode indicar que a sessão responde pior. Um aumento sustentado do RTT de submit_sm_resp, ou dos erros refletidos em command_status, indica um problema mais próximo da aceitação de tráfego.
O crescimento do conjunto de sequence_number pendentes é outro sinal crítico. Enquanto não chegar a resposta correspondente, o originador deve assumir que a PDU não foi recebida no destino. No entanto, essa ausência de confirmação não deve ser tratada como prova de que uma ação remota nunca ocorreu: após uma queda ou perda de resposta, pode existir incerteza operacional que exige controlos contra duplicados.
Timeouts repetidos do temporizador de transação, erros de socket, encerramentos inesperados e resets TCP justificam aumentar a severidade. Um reset aborta a ligação TCP; por si só, não indica o resultado das PDUs que estavam pendentes. Essas PDUs devem ser marcadas como incertas para investigação e tratamento posterior.
Erros ou rejeições de bind são um sinal direto de que não existe uma sessão apta no modo solicitado. Mesmo com um bind correto, uma acumulação de pendentes ou uma degradação de submit_sm_resp pode justificar limitar a aceitação de novos envios antes de a sessão falhar completamente.
- Latência elevada de enquire_link_resp durante um período sustentado.
- Latência elevada ou erros em submit_sm_resp.
- Aumento persistente de pedidos pendentes.
- Timeouts de transação recorrentes.
- Encerramentos, erros e resets de socket.
- Falhas ou rejeições de bind.
- Ausência de respostas onde anteriormente existia um padrão normal de atividade.
Estados operacionais: saudável, degradada, indisponível e em recuperação
Definir estados explícitos evita que os alertas se traduzam em reações improvisadas. Os critérios exatos devem ser ajustados a cada fornecedor, sessão e padrão de tráfego, porque o SMPP não impõe valores universais de temporização nem um máximo fixo de operações pendentes.
Uma sessão saudável combina transporte disponível, bind ativo para a função necessária, respostas dentro da sua referência habitual e ausência de acumulação anómala de pedidos pendentes. Uma sessão degradada mantém alguma capacidade de comunicação, mas apresenta deterioração persistente: maior latência, mais timeouts, mais pendentes ou erros crescentes.
Uma sessão indisponível não pode ser utilizada com segurança para a função necessária. Pode resultar de falha ou rejeição de bind, encerramento ou reset do socket, ou expiração repetida de transações sem recuperação de respostas. A recuperação deve ser um estado distinto: o transporte e o bind podem ter sido restabelecidos, mas a aceitação de tráfego deve permanecer suspensa ou limitada até ser observada estabilidade.
- Saudável: TCP disponível, bind válido, respostas normais e pendentes controlados.
- Degradada: sessão ativa com sinais persistentes de deterioração.
- Indisponível: sem transporte ou bind utilizável, ou com falhas repetidas sem recuperação.
- Em recuperação: conectividade restaurada, mas sob observação antes do regresso à operação normal.
Como definir limites e alertas sem depender de um único evento
Os limites devem partir de uma referência própria por ligação e tipo de PDU. Compare, por exemplo, a distribuição habitual do RTT de enquire_link com a de submit_sm_resp, e observe alterações sustentadas em percentis elevados, não apenas médias. A média pode ocultar uma cauda de respostas lentas que já está a ocupar a janela de pedidos pendentes.
Acrescente uma dimensão temporal. Um alerta por um único timeout ou por uma única sonda perdida pode gerar ruído e ações desnecessárias. É mais seguro combinar intensidade, duração e recorrência: deterioração sustentada, vários vencimentos, crescimento contínuo de pendentes ou um evento de transporte acompanhado de ausência de recuperação.
Os alertas devem incluir contexto acionável: sessão afetada, modo de bind, endpoint remoto, tipo de PDU, evolução de latência, pendentes, último erro de socket e resultado do último bind. Sem esse contexto, a equipa pode confundir um problema de receção de DLR com um problema de aceitação de submit_sm.
- Utilize referências por sessão, fornecedor e tipo de operação.
- Observe percentis e tendências, além das médias.
- Exija duração ou recorrência antes de escalar um sinal isolado.
- Diferencie alertas de transporte, bind, resposta de submit_sm e receção de DLR.
- Reveja os limites após incidentes e alterações de configuração.
Ações seguras perante cada sinal
Perante uma degradação inicial, reduza o risco antes de tentar uma reconexão agressiva. Pode limitar novas aceitações, reduzir o ritmo de envio e permitir que os pedidos já enviados recebam resposta dentro do temporizador configurado. A decisão depende da capacidade da sessão e da política acordada para o tráfego, mas deve evitar que a janela de pendentes continue a crescer sem controlo.
Perante um encerramento, reset ou falha de bind, marque a sessão como indisponível e registe quais os pedidos que permaneciam pendentes. Reconecte de forma controlada: restabeleça o transporte, execute o bind necessário e mantenha um período de observação de respostas normais antes de abrir totalmente a aceitação.
Escalar para o fornecedor é adequado quando existem evidências rastreáveis de falha ou degradação persistente: hora de início, endpoint remoto, modo de bind, resultados de bind, sequência de timeouts, command_status, eventos de socket e evolução de pendentes. O objetivo não é atribuir uma causa sem provas, mas sim partilhar observações reproduzíveis.
Não reenvie automaticamente todos os pedidos afetados por um timeout ou uma queda. A ausência de resposta confirma a falta de uma confirmação correlacionada, mas pode deixar o resultado remoto indeterminado. Qualquer nova tentativa deve seguir uma política de idempotência ou de controlo de duplicados definida pelo negócio.
- Degradação ligeira: limite aceitações e monitorize pendentes e RTT.
- Timeouts crescentes: reduza a pressão e evite ampliar a janela de pendentes.
- Socket encerrado ou reset: retire a sessão do envio e classifique os pedidos pendentes como incertos.
- Bind falhado: não aceite tráfego para essa função até restabelecer uma sessão válida.
- Recuperação: valide transporte, bind e um período de respostas normais antes de reabrir totalmente.
- Escalação: partilhe evidência correlacionada, não apenas a afirmação de “ligação perdida”.
Perguntas frequentes
Um bind SMPP correto garante que os SMS serão entregues?
Não. Um bind correto indica que o SMSC aceitou abrir uma sessão SMPP no modo solicitado. A aceitação de uma mensagem concreta é observada em submit_sm_resp e command_status. A informação posterior de entrega, se solicitada, chega através de DLR e deve ser interpretada como o estado comunicado pelo SMSC.
O que confirma exatamente o enquire_link?
Confirma que o caminho de comunicação da sessão funciona ao nível da aplicação SMPP no momento em que é recebido um enquire_link_resp correlacionado. Não confirma a aceitação de submit_sm, a disponibilidade de uma rota nem a entrega final de um SMS.
Porque devo registar o sequence_number?
Porque é o campo que correlaciona um pedido SMPP com a respetiva resposta. Permite medir RTT, detetar pedidos pendentes e gerir respostas que chegam fora de ordem.
Quantos pedidos SMPP pendentes posso ter?
Não existe um máximo universal definido pelo SMPP; depende da implementação do SMSC. A especificação indica, como orientação, não exceder dez operações simultâneas pendentes. Deve utilizar o limite acordado ou validado para cada ligação e observar a evolução real da sessão.
Um reset TCP significa que as mensagens pendentes falharam?
Não. Um reset aborta o transporte, mas não determina o resultado das PDUs pendentes. Se faltar a resposta associada, não existe confirmação correlacionada de receção. Trate-as como operações incertas e aplique uma política controlada para evitar duplicados.
O que devo verificar antes de atribuir um incidente a uma rota SMS?
Verifique primeiro o estado TCP, o resultado do bind, os RTT de enquire_link e submit_sm_resp separadamente, command_status, pedidos pendentes, timeouts, eventos de socket e a disponibilidade de DLR. Uma sessão SMPP degradada pode explicar problemas de aceitação ou de visibilidade antes de concluir que existe um problema de rota.
Fontes consultadas
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9293: Transmission Control Protocol (TCP)Internet Engineering Task Force / RFC Editor
- RFC 1122: Requirements for Internet Hosts -- Communication LayersInternet Engineering Task Force / RFC Editor