Salud de sesiones SMPP: cómo detectar degradación antes de perder mensajes
Una guía operativa para distinguir una sesión SMPP conectada de una sesión realmente sana, interpretar señales de transporte y actuar sin confundir conectividad con entregabilidad.
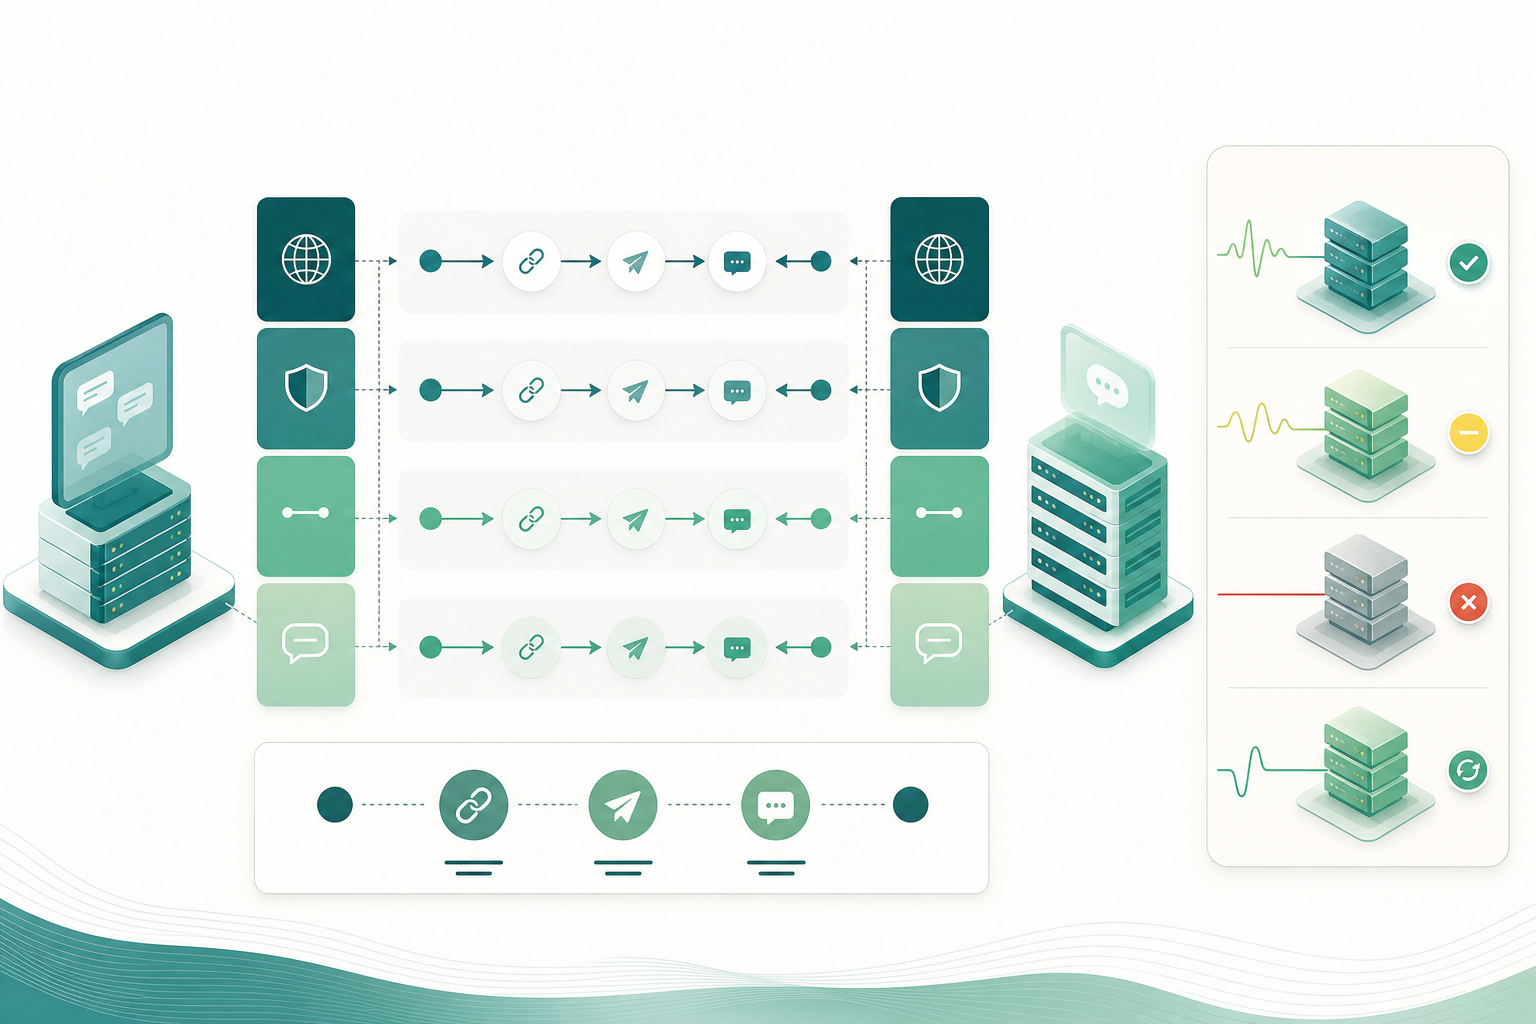
Una sesión conectada no siempre es una sesión sana
La salud de sesiones SMPP debe evaluarse por capas. Primero existe una conexión de red, normalmente TCP/IP. Después, el ESME envía una solicitud Bind para abrir la sesión SMPP en el modo requerido. Que TCP esté establecido y que el Bind haya sido aceptado confirma que esas dos etapas se completaron, pero no demuestra que la sesión responda con normalidad bajo carga ni que los mensajes futuros vayan a ser aceptados o entregados.
Una sesión puede conservar un bind aparentemente vigente mientras aumentan los tiempos de respuesta, se acumulan solicitudes sin respuesta o aparecen cierres y resets de socket. Por ello, la señal “conectado” es necesaria, pero insuficiente. La operación debe observar la capacidad real de intercambiar PDUs correlacionadas dentro de los tiempos esperados.
Tampoco debe equipararse la salud de la sesión con el resultado final de un SMS. La admisión de un submit_sm se observa en su submit_sm_resp y command_status. La fase posterior, si se solicita recibo de entrega, se observa mediante DLR transportados en deliver_sm o data_sm. Un bind correcto, un socket abierto o un enquire_link_resp no sustituyen esas evidencias.
- TCP disponible: confirma la capa de transporte, no la apertura de sesión SMPP.
- Bind aceptado: confirma que el SMSC aceptó la sesión y el modo solicitado.
- Respuestas operativas: muestran si las PDUs, incluidos submit_sm, reciben respuesta correlacionada.
- DLR: aportan información posterior sobre el estado comunicado por el SMSC; no deben confundirse con una prueba independiente de recepción en el terminal.
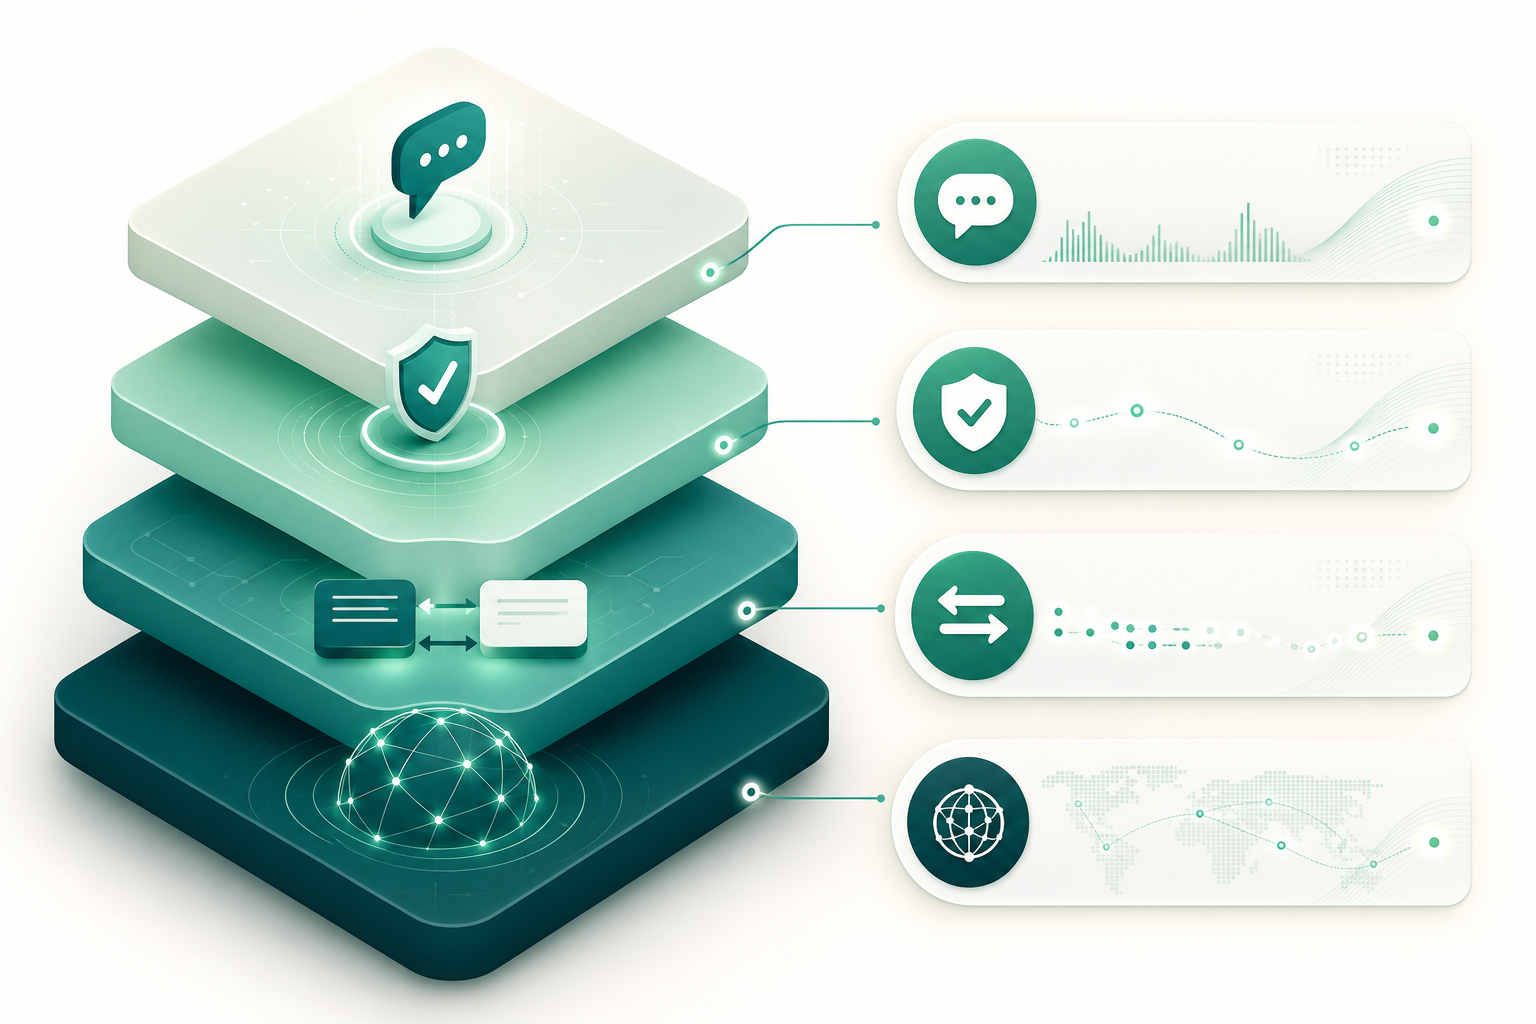
Componentes observables: transporte, bind, solicitudes pendientes y respuestas
SMPP funciona mediante PDUs de solicitud y respuesta. Salvo alert_notification, cada operación debe tener su respuesta asociada. El campo sequence_number permite correlacionar una solicitud con su respuesta y debe ser el identificador primario para medir el tiempo de respuesta y contabilizar operaciones pendientes.
No conviene asociar respuestas por orden de llegada. SMPP permite que lleguen fuera de orden, por lo que una implementación debe resolver la correlación por sequence_number. Esta precaución es especialmente importante en sesiones con varias operaciones simultáneas.
El protocolo no fija un máximo universal de operaciones pendientes. Ese límite depende de la implementación del SMSC; la especificación ofrece como guía no superar diez operaciones simultáneas pendientes. En producción, el límite operativo debe acordarse con el proveedor cuando sea posible y validarse contra el comportamiento real de cada sesión.
- Identificador de sesión y extremo remoto.
- Estado TCP: conectado, cierre, error o reset.
- Resultado y duración del bind.
- sequence_number, command_id y command_status.
- Marca de tiempo de envío y de recepción de cada PDU.
- Número de solicitudes pendientes por tipo de operación.
- RTT de enquire_link y RTT de submit_sm_resp, almacenados por separado.
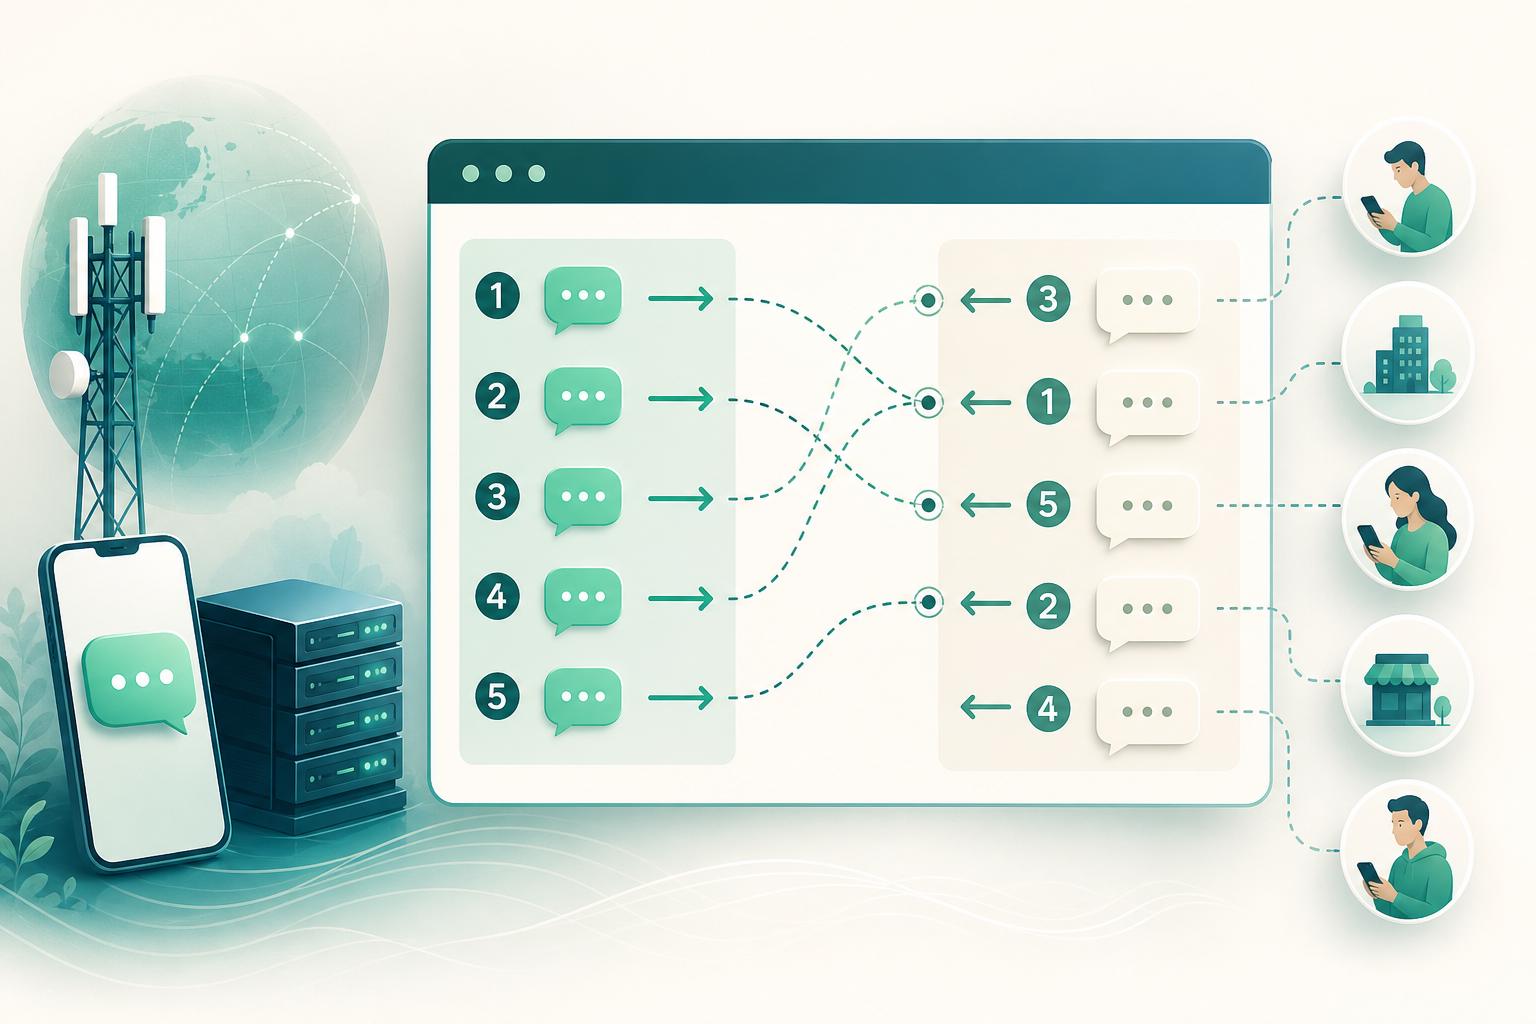
Bind modes y sus implicaciones operativas
El modo de bind define la dirección de tráfico permitida en una sesión. bind_transmitter se utiliza para tráfico desde el ESME hacia el SMSC. bind_receiver se utiliza para tráfico desde el SMSC hacia el ESME. bind_transceiver permite intercambio bidireccional en una sola sesión.
Si un ESME utiliza sesiones separadas para enviar y recibir, necesita dos conexiones de red y dos sesiones SMPP: una Transmitter y una Receiver. Operativamente, ambas deben supervisarse de forma independiente. Una sesión de envío sana no confirma que la sesión receptora esté disponible para recibir DLR u otras PDUs entrantes.
En una sesión Transceiver, el hecho de compartir conexión no elimina la necesidad de medir los dos sentidos. Deben observarse por separado las solicitudes salientes, sus respuestas, las PDUs entrantes y las respuestas que el ESME devuelve a esas PDUs cuando corresponda.
- Transmitter: supervise submit_sm y sus submit_sm_resp.
- Receiver: supervise la recepción de deliver_sm o data_sm y la respuesta que devuelve el ESME.
- Transceiver: supervise ambos sentidos y no reduzca la salud a una sola métrica agregada.
- Verifique que el modo de bind coincide con la función operacional necesaria para la ruta o conexión.
enquire_link: una sonda de sesión, no una prueba de entregabilidad
enquire_link permite a un ESME o SMSC comprobar el camino de comunicación a nivel de aplicación SMPP. Cuando llega enquire_link_resp con el mismo sequence_number, existe evidencia de que la sesión pudo intercambiar esa comprobación en ese momento.
Esta señal es útil para vigilar inactividad, detectar deterioro de RTT y descubrir antes una conexión medio abierta. En TCP, un extremo puede cerrar o abortar una conexión sin que el otro lo sepa de inmediato; el problema puede hacerse visible al intentar transmitir datos y recibir un reset. Una sonda SMPP ayuda a crear actividad de aplicación, pero no elimina toda incertidumbre.
No use enquire_link como sustituto de submit_sm. Un enquire_link_resp no confirma que el SMSC acepte tráfico de envío, que pueda procesarlo en una ruta determinada ni que un destinatario final reciba un mensaje. Mida el RTT de enquire_link por separado del RTT de submit_sm_resp para evitar que una sonda sana oculte degradación en la admisión de mensajes.
Además, un único fallo de sonda no debe convertirse automáticamente en la conclusión de que el par está caído. La decisión debe incorporar recurrencia, duración, señales de socket, estado del bind y el comportamiento de solicitudes reales.
- Qué comprueba: intercambio SMPP de aplicación en la sesión activa.
- Qué no comprueba: aceptación de submit_sm, capacidad de ruta, DLR ni entrega final.
- Qué medir: envío, recepción de enquire_link_resp, RTT, timeout y sequence_number.
- Qué evitar: declarar indisponibilidad por una única sonda fallida sin señales adicionales.
Señales de degradación temprana que deben vigilarse
La primera señal suele ser un cambio persistente respecto de la línea de referencia propia, no necesariamente un error explícito. Un aumento sostenido del RTT de enquire_link_resp puede indicar que la sesión responde peor. Un aumento sostenido del RTT de submit_sm_resp, o de los errores reflejados en command_status, indica un problema más cercano a la admisión de tráfico.
El crecimiento del inventario de sequence_number pendientes es otra señal crítica. Mientras no llegue la respuesta correspondiente, el originador debe asumir que la PDU no fue recibida en destino. Sin embargo, esa ausencia de confirmación no debe tratarse como prueba de que una acción remota nunca ocurrió: tras una caída o pérdida de respuesta puede existir incertidumbre operativa que exige controles contra duplicados.
Los timeouts repetidos del temporizador de transacción, los errores de socket, los cierres inesperados y los resets TCP justifican elevar la severidad. Un reset aborta la conexión TCP; no aporta por sí mismo el resultado de las PDUs que estaban pendientes. Esas PDUs deben quedar marcadas como inciertas para investigación y tratamiento posterior.
Los errores o rechazos de bind son una señal directa de que no hay sesión apta en el modo solicitado. Incluso con bind correcto, una acumulación de pendientes o un deterioro de submit_sm_resp puede justificar limitar la admisión de nuevos envíos antes de que la sesión falle por completo.
- Latencia elevada de enquire_link_resp durante un período sostenido.
- Latencia elevada o errores en submit_sm_resp.
- Aumento persistente de solicitudes pendientes.
- Timeouts de transacción recurrentes.
- Cierres, errores y resets de socket.
- Fallos o rechazos de bind.
- Ausencia de respuestas donde antes existía un patrón normal de actividad.
Estados operativos: sana, degradada, no disponible y en recuperación
Definir estados explícitos evita que las alertas se traduzcan en reacciones improvisadas. Los criterios exactos deben ajustarse a cada proveedor, sesión y patrón de tráfico, porque SMPP no impone valores universales de temporización ni un máximo fijo de operaciones pendientes.
Una sesión sana combina transporte disponible, bind vigente para el rol necesario, respuestas dentro de su referencia habitual y ausencia de acumulación anómala de solicitudes pendientes. Una sesión degradada mantiene alguna capacidad de comunicación, pero muestra deterioro persistente: mayor latencia, más timeouts, más pendientes o errores crecientes.
Una sesión no disponible no puede usarse con seguridad para el rol requerido. Puede deberse a fallo o rechazo de bind, cierre o reset del socket, o vencimientos repetidos de transacciones sin recuperación de respuestas. La recuperación debe ser un estado distinto: el transporte y el bind pueden haberse restablecido, pero la admisión de tráfico debe mantenerse pausada o limitada hasta observar estabilidad.
- Sana: TCP disponible, bind válido, respuestas normales y pendientes controladas.
- Degradada: sesión activa con señales persistentes de empeoramiento.
- No disponible: sin transporte o bind utilizable, o con fallos repetidos sin recuperación.
- En recuperación: conectividad restaurada, pero bajo observación antes de volver a la operación normal.
Cómo diseñar umbrales y alertas sin depender de un único evento
Los umbrales deben partir de una línea de referencia propia por conexión y tipo de PDU. Compare, por ejemplo, la distribución habitual de RTT de enquire_link con la de submit_sm_resp, y observe cambios sostenidos en percentiles altos, no sólo promedios. El promedio puede ocultar una cola de respuestas lentas que ya está ocupando la ventana de solicitudes pendientes.
Añada una dimensión temporal. Una alerta por un único timeout o por una sola sonda perdida puede generar ruido y acciones innecesarias. Es más seguro combinar intensidad, duración y recurrencia: deterioro sostenido, varios vencimientos, crecimiento continuo de pendientes o un evento de transporte acompañado de falta de recuperación.
Las alertas deben incluir contexto accionable: sesión afectada, modo de bind, extremo remoto, tipo de PDU, evolución de latencia, pendientes, último error de socket y resultado del último bind. Sin ese contexto, el equipo puede confundir un problema de recepción de DLR con un problema de admisión de submit_sm.
- Use referencias por sesión, proveedor y tipo de operación.
- Observe percentiles y tendencias, además de promedios.
- Exija duración o recurrencia antes de escalar una señal aislada.
- Diferencie alertas de transporte, bind, respuesta de submit_sm y recepción de DLR.
- Revise los umbrales después de incidentes y cambios de configuración.
Acciones seguras ante cada señal
Ante una degradación inicial, reduzca el riesgo antes de intentar una reconexión agresiva. Puede limitar nuevas admisiones, reducir el ritmo de envío y permitir que las solicitudes ya enviadas reciban respuesta dentro del temporizador configurado. La decisión depende de la capacidad de la sesión y de la política acordada para el tráfico, pero debe evitar que la ventana pendiente siga creciendo sin control.
Ante un cierre, reset o fallo de bind, marque la sesión como no disponible y registre qué solicitudes permanecían pendientes. Reconecte de forma controlada: restablezca transporte, ejecute el bind requerido y mantenga un período de observación de respuestas normales antes de abrir plenamente la admisión.
Escalar al proveedor es apropiado cuando existen evidencias trazables de fallo o degradación persistente: hora de inicio, extremo remoto, modo de bind, resultados de bind, secuencia de timeouts, command_status, eventos de socket y evolución de pendientes. El objetivo no es atribuir causa sin pruebas, sino compartir observaciones reproducibles.
No reenvíe automáticamente todas las solicitudes afectadas por un timeout o una caída. La ausencia de respuesta confirma una falta de confirmación correlacionada, pero puede dejar el resultado remoto indeterminado. Cualquier reintento debe seguir una política de idempotencia o de control de duplicados definida por el negocio.
- Degradación leve: limite admisiones y vigile pendientes y RTT.
- Timeouts crecientes: reduzca presión y evite ampliar la ventana pendiente.
- Socket cerrado o reset: retire la sesión del envío y clasifique solicitudes pendientes como inciertas.
- Bind fallido: no admita tráfico para ese rol hasta restablecer una sesión válida.
- Recuperación: valide transporte, bind y un período de respuestas normales antes de reabrir plenamente.
- Escalación: comparta evidencia correlacionada, no sólo una afirmación de “conexión caída”.
Preguntas frecuentes
¿Un bind SMPP correcto garantiza que los SMS se entregarán?
No. Un bind correcto indica que el SMSC aceptó abrir una sesión SMPP en el modo solicitado. La aceptación de un mensaje concreto se observa en submit_sm_resp y command_status. La información posterior de entrega, si se solicita, llega mediante DLR y debe interpretarse como el estado comunicado por el SMSC.
¿Qué confirma exactamente enquire_link?
Confirma que el camino de comunicación de la sesión funciona a nivel de aplicación SMPP en el momento en que se recibe enquire_link_resp correlacionado. No confirma la aceptación de submit_sm, la disponibilidad de una ruta ni la entrega final de un SMS.
¿Por qué debo registrar sequence_number?
Porque es el campo que correlaciona una solicitud SMPP con su respuesta. Permite medir RTT, detectar solicitudes pendientes y manejar respuestas que llegan fuera de orden.
¿Cuántas solicitudes SMPP pendientes puedo tener?
No existe un máximo universal fijado por SMPP; depende de la implementación del SMSC. La especificación ofrece como guía no superar diez operaciones simultáneas pendientes. Debe usar el límite acordado o validado para cada conexión y observar la evolución real de la sesión.
¿Un reset TCP significa que los mensajes pendientes fallaron?
No. Un reset aborta el transporte, pero no determina el resultado de las PDUs pendientes. Si falta la respuesta asociada, no existe confirmación correlacionada de recepción. Trátelas como operaciones inciertas y aplique una política controlada para evitar duplicados.
¿Qué debo revisar antes de atribuir un incidente a una ruta SMS?
Revise primero el estado TCP, el resultado del bind, los RTT de enquire_link y submit_sm_resp por separado, command_status, solicitudes pendientes, timeouts, eventos de socket y la disponibilidad de DLR. Una sesión SMPP degradada puede explicar problemas de admisión o de visibilidad antes de concluir que existe un problema de ruta.
Fuentes consultadas
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9293: Transmission Control Protocol (TCP)Internet Engineering Task Force / RFC Editor
- RFC 1122: Requirements for Internet Hosts -- Communication LayersInternet Engineering Task Force / RFC Editor