Santé des sessions SMPP : détecter la dégradation avant de perdre des messages
Guide opérationnel pour distinguer une session SMPP connectée d’une session réellement saine, interpréter les signaux de transport et agir sans confondre connectivité et livraison.
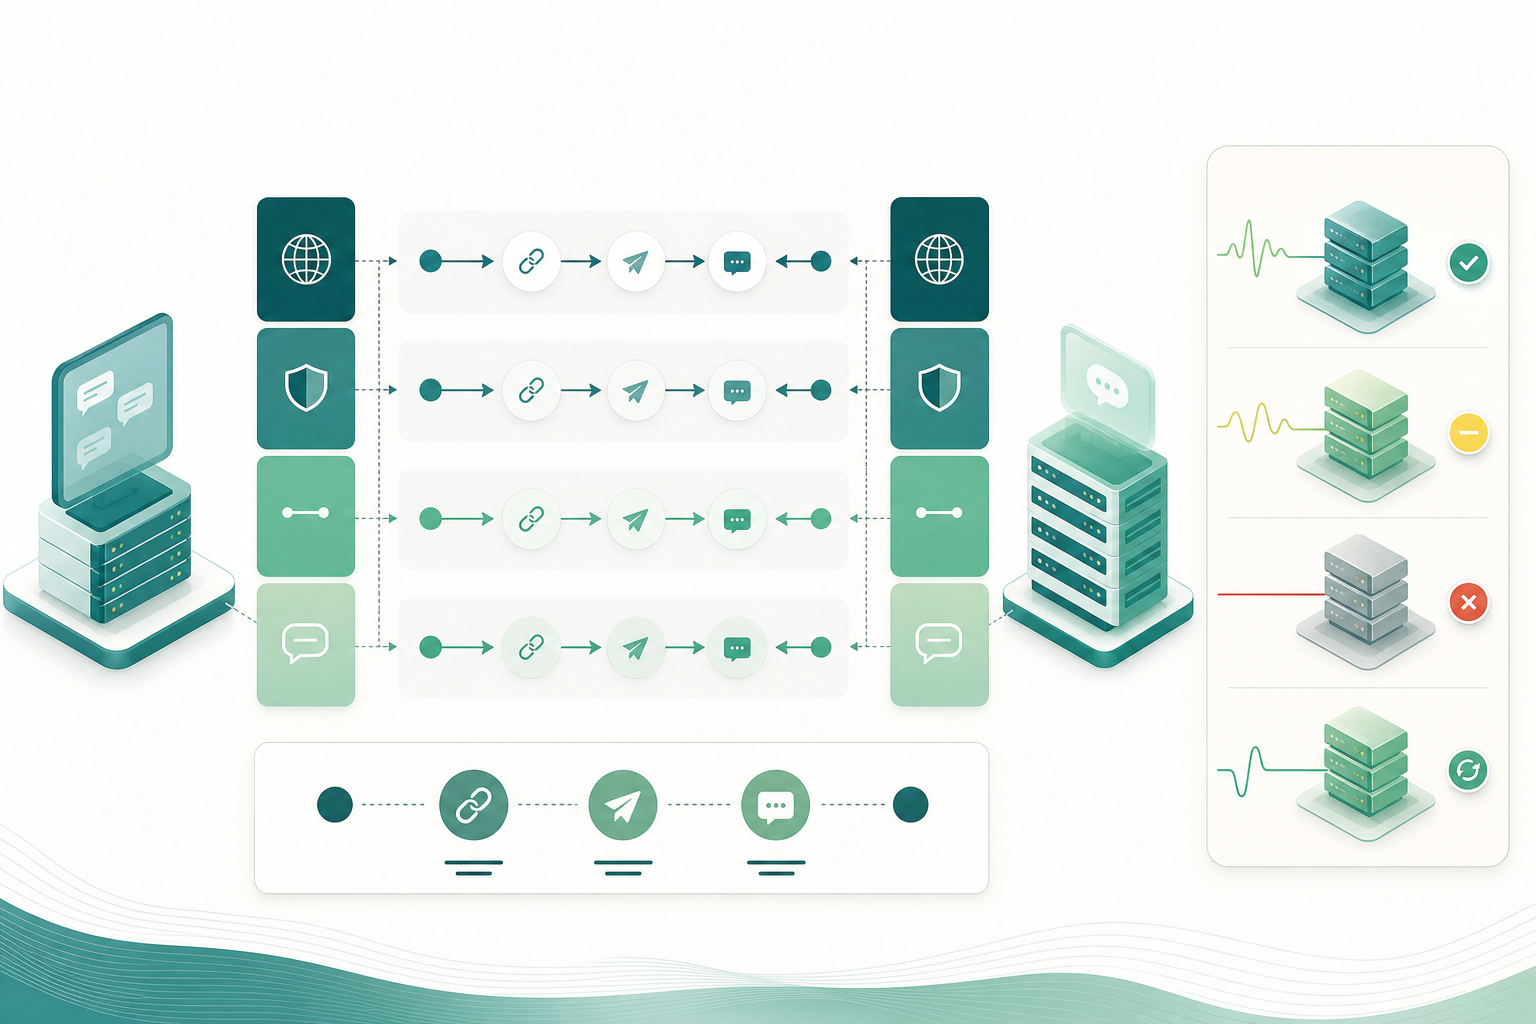
Une session connectée n’est pas toujours une session saine
La santé des sessions SMPP doit être évaluée par couches. Il y a d’abord une connexion réseau, généralement TCP/IP. Ensuite, l’ESME envoie une demande de Bind pour ouvrir la session SMPP dans le mode requis. Le fait que TCP soit établi et que le Bind ait été accepté confirme que ces deux étapes sont terminées, mais ne démontre pas que la session réponde normalement sous charge ni que les futurs messages soient acceptés ou livrés.
Une session peut conserver un bind apparemment actif tandis que les temps de réponse augmentent, que les requêtes sans réponse s’accumulent ou que des fermetures et des resets de socket apparaissent. Le signal « connecté » est donc nécessaire, mais insuffisant. L’exploitation doit observer la capacité réelle à échanger des PDU corrélées dans les délais attendus.
La santé de la session ne doit pas non plus être assimilée au résultat final d’un SMS. L’admission d’un submit_sm s’observe dans son submit_sm_resp et son command_status. La phase ultérieure, si un accusé de réception est demandé, peut être observée au moyen de DLR transmis dans deliver_sm ou data_sm. Un bind correct, un socket ouvert ou un enquire_link_resp ne remplacent pas ces preuves.
- TCP disponible : confirme la couche de transport, pas l’ouverture d’une session SMPP.
- Bind accepté : confirme que le SMSC a accepté la session et le mode demandé.
- Réponses opérationnelles : indiquent si les PDU, y compris submit_sm, reçoivent une réponse corrélée.
- DLR : fournissent des informations ultérieures sur l’état communiqué par le SMSC ; ils ne doivent pas être confondus avec une preuve indépendante de réception sur le terminal.
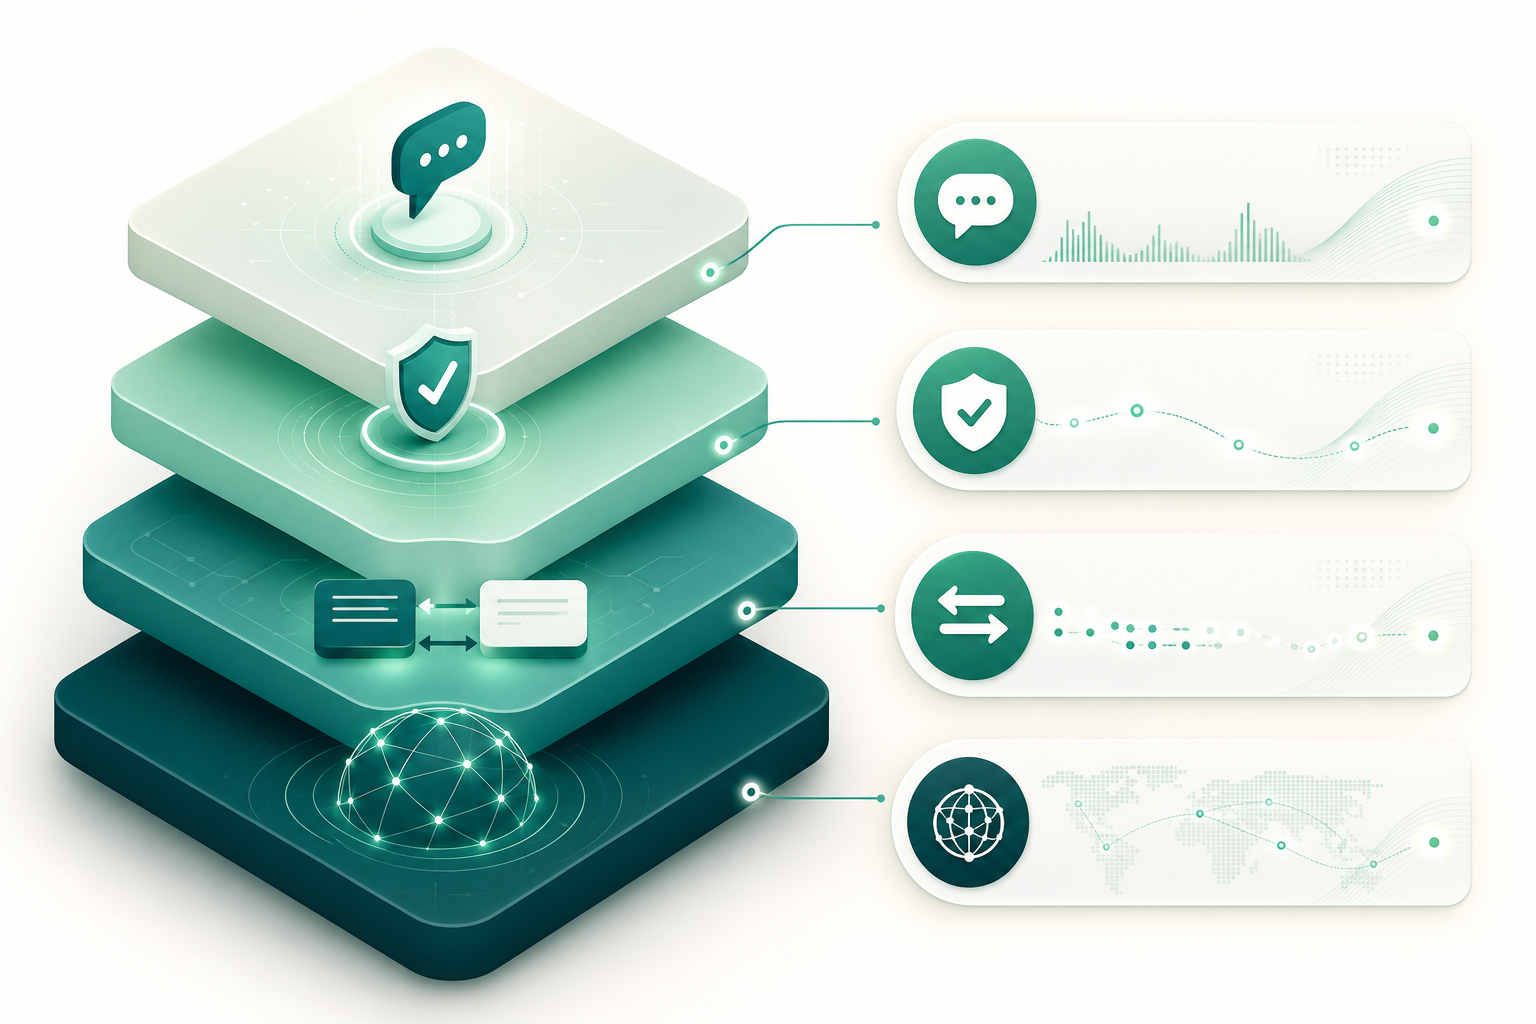
Composants observables : transport, bind, requêtes en attente et réponses
SMPP fonctionne au moyen de PDU de requête et de réponse. Les opérations de requête/réponse comportent une réponse associée. alert_notification est une PDU non sollicitée. Le champ sequence_number permet de corréler une requête à sa réponse et doit être l’identifiant principal pour mesurer le temps de réponse et compter les opérations en attente.
Il ne faut pas associer les réponses selon leur ordre d’arrivée. SMPP permet qu’elles arrivent dans le désordre ; une implémentation doit donc effectuer la corrélation par sequence_number. Cette précaution est particulièrement importante pour les sessions ayant plusieurs opérations simultanées.
Le protocole ne fixe pas de maximum universel pour les opérations en attente. Cette limite dépend de l’implémentation du SMSC ; la spécification recommande, à titre indicatif, de ne pas dépasser dix opérations simultanées en attente. En production, la limite opérationnelle doit être convenue avec le fournisseur lorsque cela est possible et validée par rapport au comportement réel de chaque session.
- Identifiant de session et extrémité distante.
- État TCP : connecté, fermeture, erreur ou reset.
- Résultat et durée du bind.
- sequence_number, command_id et command_status.
- Horodatage d’envoi et de réception de chaque PDU.
- Nombre de requêtes en attente par type d’opération.
- RTT de enquire_link et RTT de submit_sm_resp, stockés séparément.
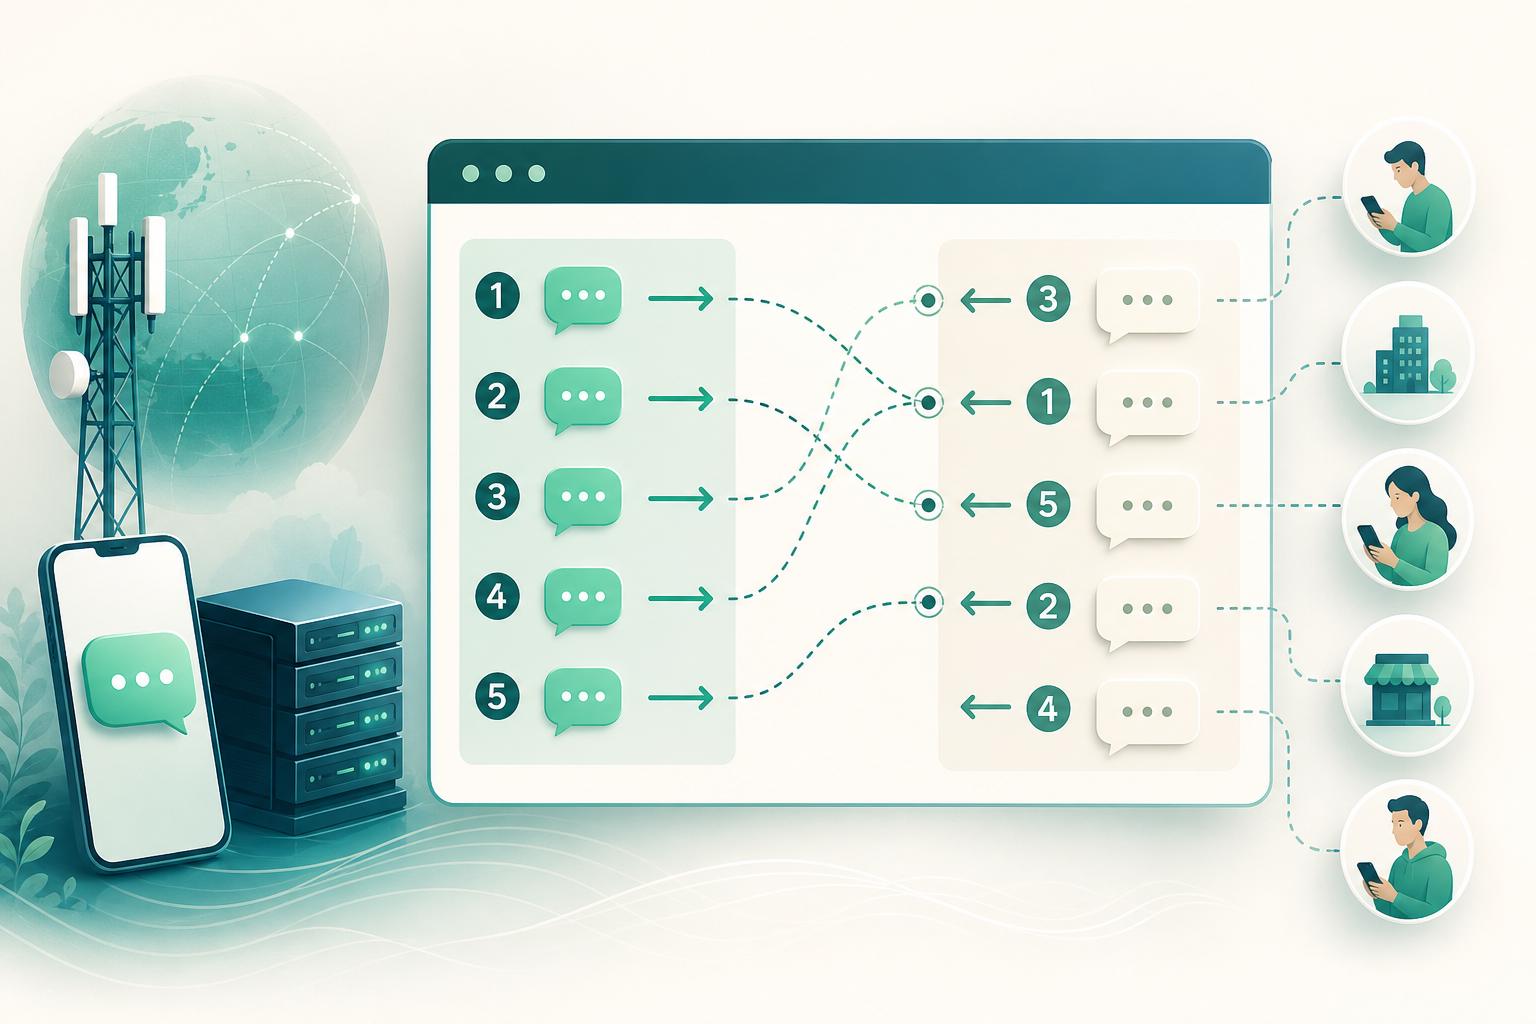
Modes de bind et implications opérationnelles
Le mode de bind définit le sens de trafic autorisé dans une session. bind_transmitter est utilisé pour le trafic de l’ESME vers le SMSC. bind_receiver est utilisé pour le trafic du SMSC vers l’ESME. bind_transceiver permet un échange bidirectionnel dans une seule session.
Si un ESME utilise des sessions distinctes pour envoyer et recevoir, il a besoin de deux connexions réseau et de deux sessions SMPP : une Transmitter et une Receiver. Sur le plan opérationnel, les deux doivent être supervisées indépendamment. Une session d’envoi saine ne confirme pas que la session réceptrice soit disponible pour recevoir des DLR ou d’autres PDU entrantes.
Dans une session Transceiver, le partage d’une connexion n’élimine pas la nécessité de mesurer les deux sens. Les requêtes sortantes, leurs réponses, les PDU entrantes et les réponses que l’ESME renvoie à ces PDU lorsqu’elles sont requises doivent être observées séparément.
- Transmitter : surveillez submit_sm et leurs submit_sm_resp.
- Receiver : surveillez la réception de deliver_sm ou data_sm et la réponse renvoyée par l’ESME.
- Transceiver : surveillez les deux sens et ne réduisez pas la santé à une seule métrique agrégée.
- Vérifiez que le mode de bind correspond à la fonction opérationnelle nécessaire pour la route ou la connexion.
enquire_link : une sonde de session, pas une preuve de livraison
enquire_link permet à un ESME ou à un SMSC de vérifier le chemin de communication au niveau applicatif SMPP. Lorsqu’un enquire_link_resp arrive avec le même sequence_number, cela prouve que la session a pu échanger cette vérification à ce moment-là.
Ce signal est utile pour surveiller l’inactivité, détecter une dégradation du RTT et découvrir plus tôt une connexion semi-ouverte. En TCP, une extrémité peut fermer ou interrompre une connexion sans que l’autre le sache immédiatement ; le problème peut devenir visible lors d’une tentative de transmission de données suivie d’un reset. Une sonde SMPP aide à créer une activité applicative, mais n’élimine pas toute incertitude.
N’utilisez pas enquire_link comme substitut à submit_sm. Un enquire_link_resp ne confirme pas que le SMSC accepte le trafic d’envoi, qu’il puisse le traiter sur une route donnée ni qu’un destinataire final reçoive un message. Mesurez le RTT de enquire_link séparément du RTT de submit_sm_resp afin d’éviter qu’une sonde saine ne masque une dégradation de l’admission des messages.
En outre, un seul échec de sonde ne doit pas automatiquement conduire à conclure que le pair est indisponible. La décision doit tenir compte de la récurrence, de la durée, des signaux de socket, de l’état du bind et du comportement des requêtes réelles.
- Ce qu’il vérifie : l’échange applicatif SMPP sur la session active.
- Ce qu’il ne vérifie pas : l’acceptation de submit_sm, la capacité de la route, les DLR ni la livraison finale.
- Ce qu’il faut mesurer : envoi, réception de enquire_link_resp, RTT, timeout et sequence_number.
- Ce qu’il faut éviter : déclarer une indisponibilité sur la base d’une seule sonde en échec sans signaux supplémentaires.
Signaux de dégradation précoce à surveiller
Le premier signal est souvent un changement persistant par rapport à la référence propre à la session, et non nécessairement une erreur explicite. Une hausse soutenue du RTT de enquire_link_resp peut indiquer que la session répond moins bien. Une hausse soutenue du RTT de submit_sm_resp, ou des erreurs reflétées dans command_status, indique un problème plus proche de l’admission du trafic.
La croissance du nombre de sequence_number en attente est un autre signal critique. Tant que la réponse correspondante n’est pas arrivée, l’émetteur doit, conformément à la règle de traitement SMPP, considérer que la PDU n’a pas été reçue à destination. Cette règle ne supprime pas l’incertitude opérationnelle : après une coupure ou une réponse perdue, l’absence de confirmation corrélée peut laisser le résultat distant indéterminé et exiger des contrôles contre les doublons.
Les expirations répétées du temporisateur de transaction, les erreurs de socket, les fermetures inattendues et les resets TCP justifient une élévation de la sévérité. Un reset interrompt la connexion TCP ; il ne fournit pas à lui seul le résultat des PDU qui étaient en attente. Ces PDU doivent être marquées comme incertaines en vue d’une investigation et d’un traitement ultérieur.
Les erreurs ou rejets de bind signalent directement qu’il n’existe pas de session adaptée dans le mode demandé. Même avec un bind correct, une accumulation de requêtes en attente ou une dégradation de submit_sm_resp peut justifier de limiter l’admission de nouveaux envois avant que la session n’échoue totalement.
- Latence élevée de enquire_link_resp pendant une période prolongée.
- Latence élevée ou erreurs dans submit_sm_resp.
- Augmentation persistante des requêtes en attente.
- Expirations récurrentes de transactions.
- Fermetures, erreurs et resets de socket.
- Échecs ou rejets de bind.
- Absence de réponses là où existait auparavant un schéma d’activité normal.
États opérationnels : saine, dégradée, indisponible et en récupération
La définition d’états explicites évite que les alertes ne se transforment en réactions improvisées. Les critères exacts doivent être adaptés à chaque fournisseur, session et modèle de trafic, car SMPP n’impose aucune valeur universelle de temporisation ni aucun maximum fixe d’opérations en attente.
Une session saine combine un transport disponible, un bind actif pour le rôle requis, des réponses dans leur plage habituelle et l’absence d’accumulation anormale de requêtes en attente. Une session dégradée conserve une certaine capacité de communication, mais présente une détérioration persistante : latence plus élevée, davantage de timeouts, plus de requêtes en attente ou des erreurs croissantes.
Une session indisponible ne peut pas être utilisée de manière fiable pour le rôle requis. Cela peut être dû à un échec ou un rejet du bind, à une fermeture ou un reset du socket, ou à des expirations répétées de transactions sans retour des réponses. La récupération doit être un état distinct : le transport et le bind peuvent avoir été rétablis, mais l’admission de trafic doit rester suspendue ou limitée jusqu’à l’observation d’une stabilité.
- Saine : TCP disponible, bind valide, réponses normales et requêtes en attente maîtrisées.
- Dégradée : session active présentant des signes persistants de détérioration.
- Indisponible : absence de transport ou de bind utilisable, ou échecs répétés sans récupération.
- En récupération : connectivité rétablie, mais sous observation avant le retour à une exploitation normale.
Concevoir des seuils et alertes sans dépendre d’un seul événement
Les seuils doivent s’appuyer sur une référence propre à chaque connexion et à chaque type de PDU. Comparez, par exemple, la distribution habituelle des RTT de enquire_link avec celle des submit_sm_resp, et observez les changements soutenus dans les percentiles élevés, pas seulement les moyennes. La moyenne peut masquer une file de réponses lentes qui occupe déjà la fenêtre des requêtes en attente.
Ajoutez une dimension temporelle. Une alerte déclenchée par un seul timeout ou une seule sonde perdue peut générer du bruit et des actions inutiles. Il est plus sûr de combiner intensité, durée et récurrence : détérioration soutenue, plusieurs expirations, croissance continue des requêtes en attente ou événement de transport accompagné d’une absence de récupération.
Les alertes doivent inclure un contexte exploitable : session affectée, mode de bind, extrémité distante, type de PDU, évolution de la latence, requêtes en attente, dernière erreur de socket et résultat du dernier bind. Sans ce contexte, l’équipe peut confondre un problème de réception de DLR avec un problème d’admission de submit_sm.
- Utilisez des références par session, fournisseur et type d’opération.
- Observez les percentiles et les tendances, en plus des moyennes.
- Exigez une durée ou une récurrence avant d’escalader un signal isolé.
- Distinguez les alertes de transport, de bind, de réponse submit_sm et de réception des DLR.
- Révisez les seuils après des incidents et des changements de configuration.
Actions sûres pour chaque signal
Face à une dégradation initiale, réduisez le risque avant de tenter une reconnexion agressive. Vous pouvez limiter les nouvelles admissions, réduire le débit d’envoi et permettre aux requêtes déjà envoyées de recevoir une réponse dans le délai configuré. La décision dépend de la capacité de la session et de la politique convenue pour le trafic, mais elle doit éviter que la fenêtre des requêtes en attente ne continue à croître sans contrôle.
En cas de fermeture, de reset ou d’échec de bind, marquez la session comme indisponible et enregistrez les requêtes qui étaient encore en attente. Reconnectez de manière contrôlée : rétablissez le transport, exécutez le bind requis et maintenez une période d’observation de réponses normales avant d’ouvrir pleinement l’admission.
L’escalade auprès du fournisseur est appropriée lorsqu’il existe des preuves traçables d’un échec ou d’une dégradation persistante : heure de début, extrémité distante, mode de bind, résultats des bind, séquence de timeouts, command_status, événements de socket et évolution des requêtes en attente. L’objectif n’est pas d’attribuer une cause sans preuve, mais de partager des observations reproductibles.
Ne renvoyez pas automatiquement toutes les requêtes touchées par un timeout ou une coupure. L’absence de réponse impose, selon la règle de traitement SMPP, de considérer qu’il n’y a pas eu de réception confirmée ; elle ne permet toutefois pas d’exclure un résultat distant indéterminé après une réponse perdue ou une coupure. Toute nouvelle tentative doit suivre une politique d’idempotence ou de contrôle des doublons définie par l’entreprise.
- Dégradation légère : limitez les admissions et surveillez les requêtes en attente et le RTT.
- Timeouts croissants : réduisez la pression et évitez d’élargir la fenêtre des requêtes en attente.
- Socket fermé ou reset : retirez la session de l’envoi et classez les requêtes en attente comme incertaines.
- Échec de bind : n’admettez pas de trafic pour ce rôle jusqu’au rétablissement d’une session valide.
- Récupération : validez le transport, le bind et une période de réponses normales avant de rouvrir pleinement.
- Escalade : partagez des preuves corrélées, et non une simple affirmation de « connexion coupée ».
Questions fréquentes
Un bind SMPP correct garantit-il que les SMS seront livrés ?
Non. Un bind correct indique que le SMSC a accepté d’ouvrir une session SMPP dans le mode demandé. L’acceptation d’un message spécifique s’observe dans submit_sm_resp et command_status. Les informations ultérieures de livraison, si elles sont demandées, peuvent arriver par DLR et doivent être interprétées comme l’état communiqué par le SMSC.
Que confirme exactement enquire_link ?
Il confirme que le chemin de communication de la session fonctionne au niveau applicatif SMPP au moment où un enquire_link_resp corrélé est reçu. Il ne confirme pas l’acceptation de submit_sm, la disponibilité d’une route ni la livraison finale d’un SMS.
Pourquoi dois-je enregistrer sequence_number ?
Parce qu’il s’agit du champ qui corrèle une requête SMPP à sa réponse. Il permet de mesurer le RTT, de détecter les requêtes en attente et de gérer les réponses qui arrivent dans le désordre.
Combien de requêtes SMPP en attente puis-je avoir ?
Il n’existe pas de maximum universel défini par SMPP ; cela dépend de l’implémentation du SMSC. La spécification recommande, à titre indicatif, de ne pas dépasser dix opérations simultanées en attente. Vous devez utiliser la limite convenue ou validée pour chaque connexion et observer l’évolution réelle de la session.
Un reset TCP signifie-t-il que les messages en attente ont échoué ?
Non. Un reset interrompt le transport, mais ne détermine pas le résultat des PDU en attente. En l’absence de réponse associée, SMPP impose de les traiter comme non reçues à destination. Toutefois, une réponse perdue ou une coupure peut laisser le résultat distant indéterminé. Traitez-les donc comme des opérations incertaines et appliquez une politique contrôlée pour éviter les doublons.
Que dois-je vérifier avant d’attribuer un incident à une route SMS ?
Vérifiez d’abord l’état TCP, le résultat du bind, les RTT de enquire_link et de submit_sm_resp séparément, command_status, les requêtes en attente, les timeouts, les événements de socket et la disponibilité des DLR. Une session SMPP dégradée peut expliquer des problèmes d’admission ou de visibilité avant de conclure à un problème de route.
Sources consultées
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9293: Transmission Control Protocol (TCP)Internet Engineering Task Force / RFC Editor
- RFC 1122: Requirements for Internet Hosts -- Communication LayersInternet Engineering Task Force / RFC Editor