Salute delle sessioni SMPP: come rilevare il degrado prima di perdere messaggi
Una guida operativa per distinguere una sessione SMPP connessa da una realmente sana, interpretare i segnali di trasporto e intervenire senza confondere connettività e consegna.
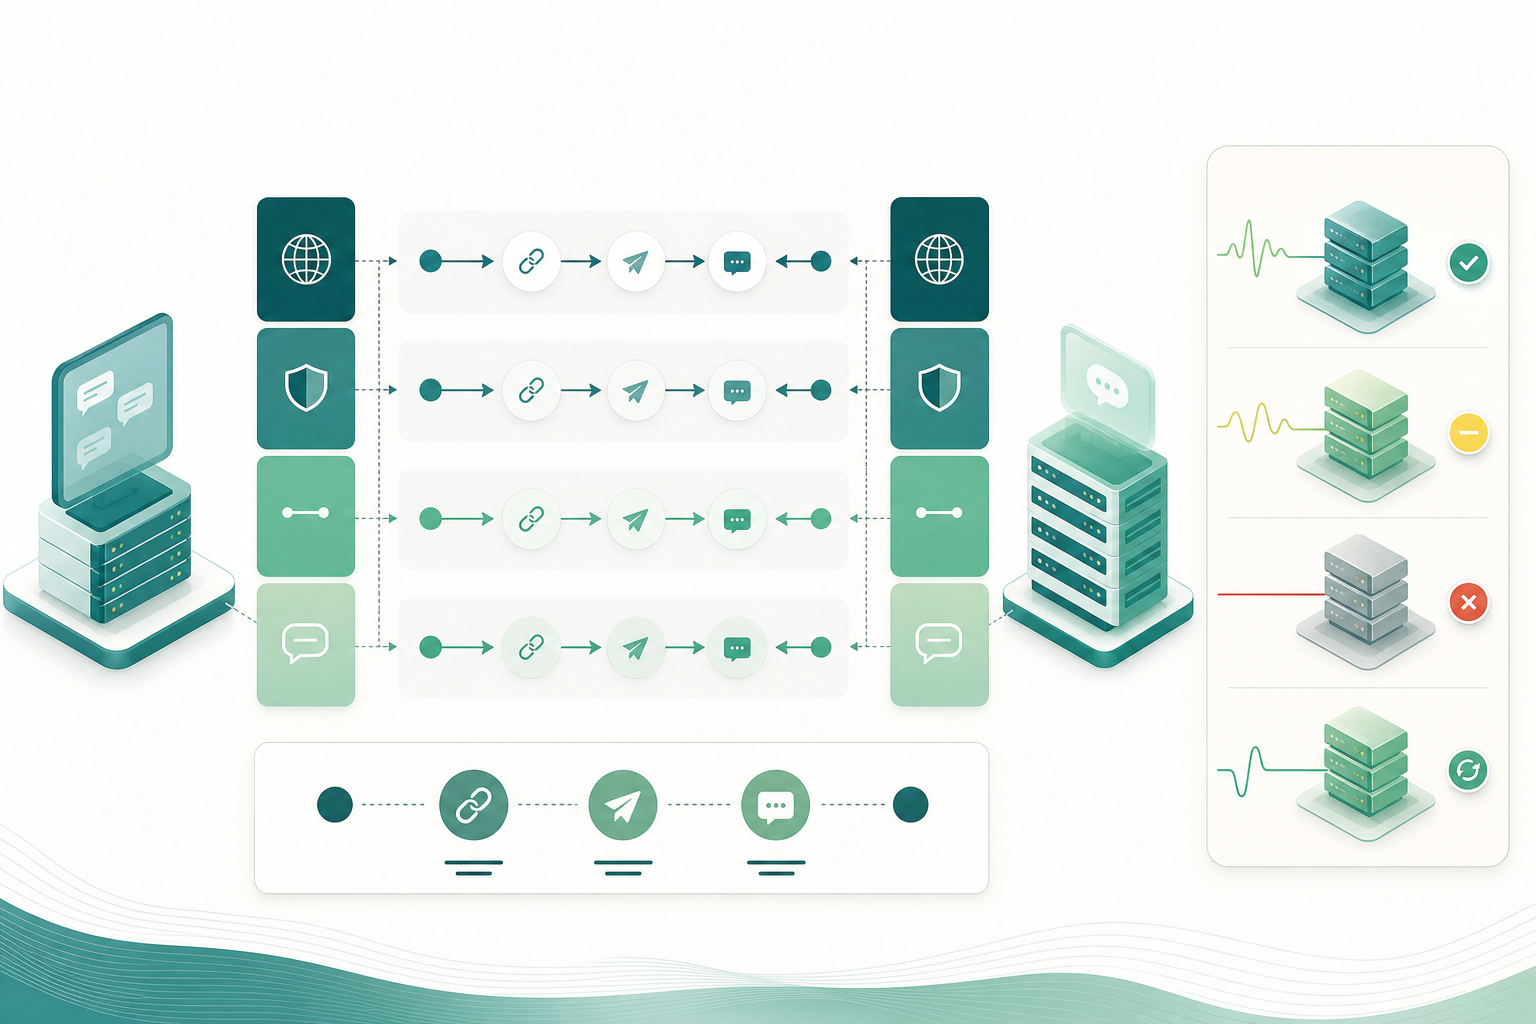
Una sessione connessa non è sempre una sessione sana
La salute delle sessioni SMPP deve essere valutata a livelli. Innanzitutto esiste una connessione di rete, normalmente TCP/IP. Successivamente, l’ESME invia una richiesta Bind per aprire la sessione SMPP nella modalità richiesta. Il fatto che TCP sia stabilito e che il Bind sia stato accettato conferma il completamento di queste due fasi, ma non dimostra che la sessione risponda normalmente sotto carico né che i messaggi futuri vengano accettati o consegnati.
Una sessione può mantenere un bind apparentemente valido mentre aumentano i tempi di risposta, si accumulano richieste senza risposta o si verificano chiusure e reset del socket. Per questo, il segnale “connesso” è necessario, ma non sufficiente. Le operazioni devono osservare l’effettiva capacità di scambiare PDU correlate entro i tempi attesi.
La salute della sessione non deve neppure essere equiparata al risultato finale di un SMS. L’accettazione di un submit_sm si osserva nella relativa submit_sm_resp e nel command_status. La fase successiva, se viene richiesto un rapporto di consegna, si osserva tramite DLR trasportati in deliver_sm o data_sm. Un bind corretto, un socket aperto o un enquire_link_resp non sostituiscono queste evidenze.
- TCP disponibile: conferma il livello di trasporto, non l’apertura della sessione SMPP.
- Bind accettato: conferma che l’SMSC ha accettato la sessione e la modalità richiesta.
- Risposte operative: mostrano se le PDU, incluse le submit_sm, ricevono una risposta correlata.
- DLR: forniscono informazioni successive sullo stato comunicato dall’SMSC; non devono essere confusi con una prova indipendente di ricezione sul terminale.
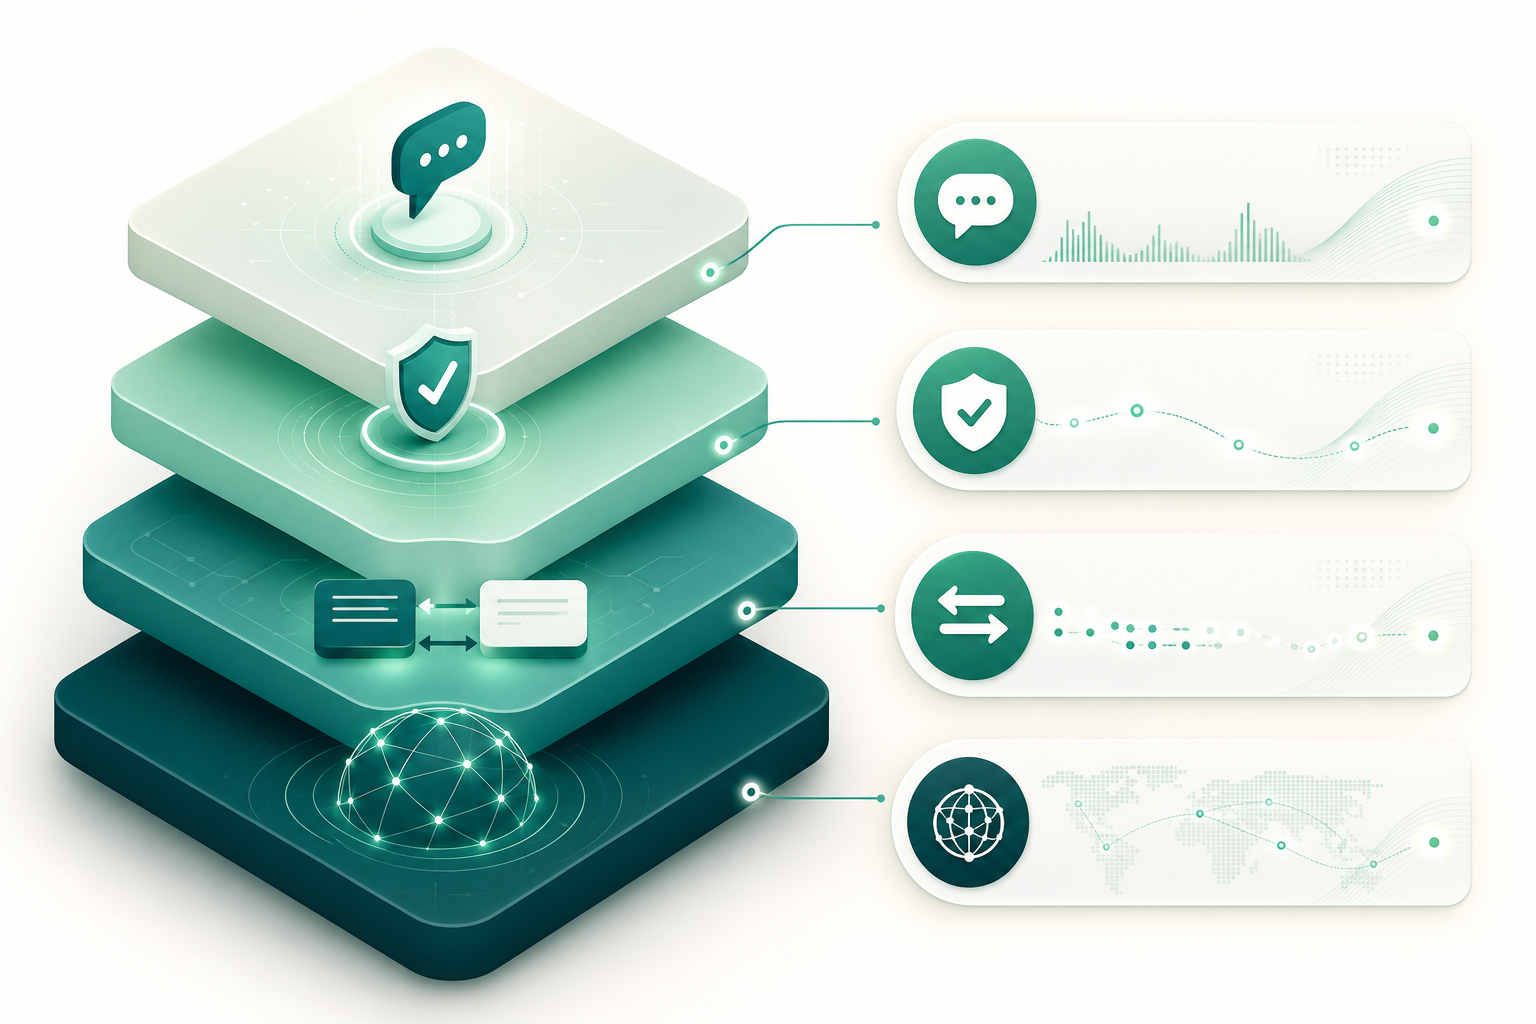
Componenti osservabili: trasporto, bind, richieste pendenti e risposte
SMPP funziona tramite PDU di richiesta e risposta. Tranne alert_notification, ogni operazione deve avere la propria risposta associata. Il campo sequence_number permette di correlare una richiesta con la sua risposta e deve essere l’identificatore principale per misurare il tempo di risposta e conteggiare le operazioni pendenti.
Non è opportuno associare le risposte in base all’ordine di arrivo. SMPP consente che arrivino fuori ordine, quindi un’implementazione deve risolvere la correlazione tramite sequence_number. Questa precauzione è particolarmente importante nelle sessioni con più operazioni simultanee.
Il protocollo non stabilisce un massimo universale di operazioni pendenti. Questo limite dipende dall’implementazione dell’SMSC; la specifica suggerisce di non superare dieci operazioni simultanee pendenti. In produzione, il limite operativo dovrebbe essere concordato con il fornitore quando possibile e convalidato rispetto al comportamento reale di ciascuna sessione.
- Identificatore della sessione e endpoint remoto.
- Stato TCP: connesso, chiusura, errore o reset.
- Esito e durata del bind.
- sequence_number, command_id e command_status.
- Timestamp di invio e ricezione di ogni PDU.
- Numero di richieste pendenti per tipo di operazione.
- RTT di enquire_link e RTT di submit_sm_resp, memorizzati separatamente.
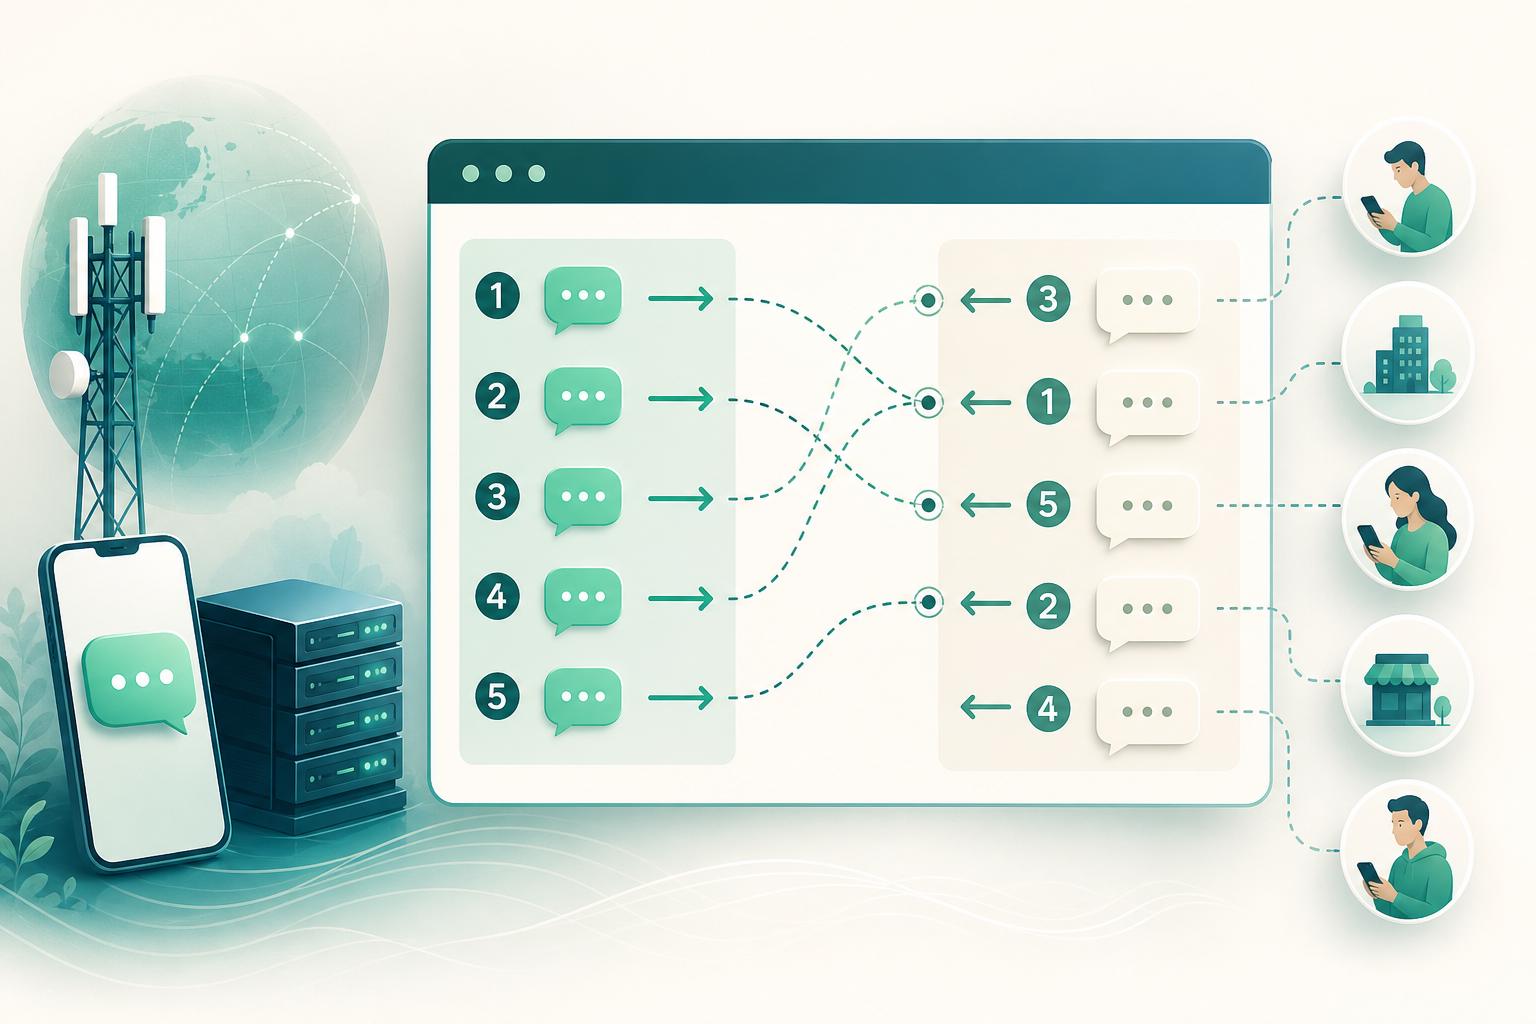
Modalità di bind e implicazioni operative
La modalità di bind definisce la direzione del traffico consentita in una sessione. bind_transmitter viene usato per il traffico dall’ESME verso l’SMSC. bind_receiver viene usato per il traffico dall’SMSC verso l’ESME. bind_transceiver consente lo scambio bidirezionale in un’unica sessione.
Se un ESME utilizza sessioni separate per inviare e ricevere, necessita di due connessioni di rete e due sessioni SMPP: una Transmitter e una Receiver. Operativamente, entrambe devono essere monitorate in modo indipendente. Una sessione di invio sana non conferma che la sessione ricevente sia disponibile per ricevere DLR o altre PDU in ingresso.
In una sessione Transceiver, il fatto di condividere la connessione non elimina la necessità di misurare entrambe le direzioni. Devono essere osservate separatamente le richieste in uscita, le relative risposte, le PDU in ingresso e le risposte che l’ESME restituisce a tali PDU quando necessario.
- Transmitter: monitorare submit_sm e le relative submit_sm_resp.
- Receiver: monitorare la ricezione di deliver_sm o data_sm e la risposta restituita dall’ESME.
- Transceiver: monitorare entrambe le direzioni e non ridurre la salute a una sola metrica aggregata.
- Verificare che la modalità di bind corrisponda alla funzione operativa necessaria per la rotta o la connessione.
enquire_link: una sonda di sessione, non una prova di consegna
enquire_link permette a un ESME o a un SMSC di verificare il canale di comunicazione a livello applicativo SMPP. Quando arriva un enquire_link_resp con lo stesso sequence_number, vi è evidenza che la sessione abbia potuto scambiare tale verifica in quel momento.
Questo segnale è utile per monitorare l’inattività, rilevare il peggioramento dell’RTT e individuare prima una connessione semiaperta. In TCP, un’estremità può chiudere o interrompere una connessione senza che l’altra lo sappia immediatamente; il problema può diventare visibile quando si tenta di trasmettere dati e si riceve un reset. Una sonda SMPP aiuta a generare attività applicativa, ma non elimina ogni incertezza.
Non utilizzare enquire_link come sostituto di submit_sm. Un enquire_link_resp non conferma che l’SMSC accetti traffico di invio, che possa elaborarlo su una determinata rotta né che un destinatario finale riceva un messaggio. Misurare l’RTT di enquire_link separatamente dall’RTT di submit_sm_resp per evitare che una sonda sana nasconda il degrado nell’accettazione dei messaggi.
Inoltre, un singolo errore della sonda non deve trasformarsi automaticamente nella conclusione che il peer sia inattivo. La decisione deve includere ricorrenza, durata, segnali del socket, stato del bind e comportamento delle richieste reali.
- Cosa verifica: scambio applicativo SMPP nella sessione attiva.
- Cosa non verifica: accettazione di submit_sm, capacità della rotta, DLR o consegna finale.
- Cosa misurare: invio, ricezione di enquire_link_resp, RTT, timeout e sequence_number.
- Cosa evitare: dichiarare indisponibilità per una sola sonda fallita senza segnali aggiuntivi.
Segnali di degrado precoce da monitorare
Il primo segnale è spesso una variazione persistente rispetto alla propria baseline, non necessariamente un errore esplicito. Un aumento continuo dell’RTT di enquire_link_resp può indicare che la sessione risponde peggio. Un aumento continuo dell’RTT di submit_sm_resp, oppure degli errori riflessi nel command_status, indica un problema più vicino all’accettazione del traffico.
La crescita dell’inventario dei sequence_number pendenti è un altro segnale critico. Finché non arriva la risposta corrispondente, l’originatore deve presumere che la PDU non sia stata ricevuta a destinazione. Tuttavia, questa assenza di conferma non deve essere trattata come prova che un’azione remota non sia mai avvenuta: dopo un’interruzione o la perdita di una risposta, può esistere un’incertezza operativa che richiede controlli contro i duplicati.
Timeout ripetuti del timer di transazione, errori del socket, chiusure inattese e reset TCP giustificano un aumento della severità. Un reset interrompe la connessione TCP; non fornisce di per sé l’esito delle PDU rimaste pendenti. Tali PDU devono essere contrassegnate come incerte per l’analisi e la gestione successive.
Errori o rifiuti di bind sono un segnale diretto dell’assenza di una sessione idonea nella modalità richiesta. Anche con un bind corretto, un accumulo di richieste pendenti o un peggioramento delle submit_sm_resp può giustificare la limitazione dell’accettazione di nuovi invii prima che la sessione fallisca completamente.
- Latenza elevata di enquire_link_resp per un periodo prolungato.
- Latenza elevata o errori in submit_sm_resp.
- Aumento persistente delle richieste pendenti.
- Timeout di transazione ricorrenti.
- Chiusure, errori e reset del socket.
- Errori o rifiuti di bind.
- Assenza di risposte dove in precedenza esisteva un normale schema di attività.
Stati operativi: sana, degradata, non disponibile e in ripristino
Definire stati espliciti evita che gli avvisi si traducano in reazioni improvvisate. I criteri esatti devono essere adattati a ogni fornitore, sessione e modello di traffico, poiché SMPP non impone valori universali di temporizzazione né un massimo fisso di operazioni pendenti.
Una sessione sana combina trasporto disponibile, bind valido per il ruolo richiesto, risposte entro la propria baseline abituale e assenza di accumuli anomali di richieste pendenti. Una sessione degradata conserva una certa capacità di comunicazione, ma mostra un deterioramento persistente: maggiore latenza, più timeout, più richieste pendenti o errori in aumento.
Una sessione non disponibile non può essere usata in sicurezza per il ruolo richiesto. Può dipendere da un errore o un rifiuto di bind, dalla chiusura o dal reset del socket, oppure da scadenze ripetute delle transazioni senza recupero delle risposte. Il ripristino deve essere uno stato distinto: trasporto e bind possono essere stati ristabiliti, ma l’accettazione del traffico deve rimanere sospesa o limitata fino a quando non si osserva stabilità.
- Sana: TCP disponibile, bind valido, risposte normali e richieste pendenti controllate.
- Degradata: sessione attiva con segnali persistenti di peggioramento.
- Non disponibile: assenza di trasporto o bind utilizzabile, oppure guasti ripetuti senza ripristino.
- In ripristino: connettività ristabilita, ma sotto osservazione prima del ritorno alla normale operatività.
Come progettare soglie e avvisi senza dipendere da un singolo evento
Le soglie devono partire da una baseline propria per connessione e tipo di PDU. Confrontare, ad esempio, la distribuzione abituale dell’RTT di enquire_link con quella di submit_sm_resp e osservare variazioni persistenti nei percentili elevati, non soltanto nelle medie. La media può nascondere una coda di risposte lente che sta già occupando la finestra delle richieste pendenti.
Aggiungere una dimensione temporale. Un avviso per un singolo timeout o per una sola sonda persa può generare rumore e azioni non necessarie. È più sicuro combinare intensità, durata e ricorrenza: deterioramento prolungato, più scadenze, crescita continua delle richieste pendenti oppure un evento di trasporto accompagnato dall’assenza di ripristino.
Gli avvisi devono includere un contesto azionabile: sessione interessata, modalità di bind, endpoint remoto, tipo di PDU, evoluzione della latenza, richieste pendenti, ultimo errore del socket ed esito dell’ultimo bind. Senza questo contesto, il team può confondere un problema di ricezione dei DLR con un problema di accettazione di submit_sm.
- Utilizzare baseline per sessione, fornitore e tipo di operazione.
- Osservare percentili e tendenze, oltre alle medie.
- Richiedere durata o ricorrenza prima di escalare un segnale isolato.
- Distinguere gli avvisi di trasporto, bind, risposta submit_sm e ricezione DLR.
- Rivedere le soglie dopo incidenti e modifiche di configurazione.
Azioni sicure per ogni segnale
Di fronte a un degrado iniziale, ridurre il rischio prima di tentare una riconnessione aggressiva. È possibile limitare le nuove accettazioni, ridurre il ritmo di invio e consentire alle richieste già inviate di ricevere risposta entro il timer configurato. La decisione dipende dalla capacità della sessione e dalla policy concordata per il traffico, ma deve evitare che la finestra pendente continui a crescere senza controllo.
In caso di chiusura, reset o errore di bind, contrassegnare la sessione come non disponibile e registrare quali richieste erano ancora pendenti. Riconnettere in modo controllato: ristabilire il trasporto, eseguire il bind richiesto e mantenere un periodo di osservazione di risposte normali prima di aprire completamente l’accettazione.
L’escalation al fornitore è appropriata quando esistono evidenze tracciabili di guasto o degrado persistente: ora di inizio, endpoint remoto, modalità di bind, risultati del bind, sequenza di timeout, command_status, eventi del socket ed evoluzione delle richieste pendenti. L’obiettivo non è attribuire una causa senza prove, ma condividere osservazioni riproducibili.
Non reinviare automaticamente tutte le richieste interessate da un timeout o da un’interruzione. L’assenza di risposta conferma la mancanza di una conferma correlata, ma può lasciare indeterminato l’esito remoto. Qualsiasi nuovo tentativo deve seguire una policy di idempotenza o di controllo dei duplicati definita dal business.
- Degrado lieve: limitare le accettazioni e monitorare richieste pendenti e RTT.
- Timeout in aumento: ridurre la pressione ed evitare di ampliare la finestra pendente.
- Socket chiuso o reset: rimuovere la sessione dall’invio e classificare le richieste pendenti come incerte.
- Bind fallito: non accettare traffico per quel ruolo finché non viene ristabilita una sessione valida.
- Ripristino: convalidare trasporto, bind e un periodo di risposte normali prima della piena riapertura.
- Escalation: condividere evidenze correlate, non soltanto un’affermazione di “connessione interrotta”.
Domande frequenti
Un bind SMPP corretto garantisce che gli SMS saranno consegnati?
No. Un bind corretto indica che l’SMSC ha accettato di aprire una sessione SMPP nella modalità richiesta. L’accettazione di un messaggio specifico si osserva nella submit_sm_resp e nel command_status. Le informazioni successive sulla consegna, se richieste, arrivano tramite DLR e devono essere interpretate come lo stato comunicato dall’SMSC.
Che cosa conferma esattamente enquire_link?
Conferma che il canale di comunicazione della sessione funziona a livello applicativo SMPP nel momento in cui viene ricevuto un enquire_link_resp correlato. Non conferma l’accettazione di submit_sm, la disponibilità di una rotta né la consegna finale di un SMS.
Perché devo registrare sequence_number?
Perché è il campo che correla una richiesta SMPP con la sua risposta. Consente di misurare l’RTT, rilevare richieste pendenti e gestire risposte che arrivano fuori ordine.
Quante richieste SMPP pendenti posso avere?
Non esiste un massimo universale stabilito da SMPP; dipende dall’implementazione dell’SMSC. La specifica suggerisce di non superare dieci operazioni simultanee pendenti. È necessario usare il limite concordato o convalidato per ogni connessione e osservare l’evoluzione reale della sessione.
Un reset TCP significa che i messaggi pendenti sono falliti?
No. Un reset interrompe il trasporto, ma non determina l’esito delle PDU pendenti. Se manca la risposta associata, non esiste una conferma correlata di ricezione. Trattarle come operazioni incerte e applicare una policy controllata per evitare duplicati.
Cosa devo verificare prima di attribuire un incidente a una rotta SMS?
Verificare prima lo stato TCP, l’esito del bind, gli RTT di enquire_link e submit_sm_resp separatamente, command_status, richieste pendenti, timeout, eventi del socket e disponibilità dei DLR. Una sessione SMPP degradata può spiegare problemi di accettazione o visibilità prima di concludere che esista un problema di rotta.
Fonti consultate
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9293: Transmission Control Protocol (TCP)Internet Engineering Task Force / RFC Editor
- RFC 1122: Requirements for Internet Hosts -- Communication LayersInternet Engineering Task Force / RFC Editor