Backpressure en SMS A2P : concevoir des files d’attente qui protègent la livraison face aux pics, limites et dégradations
Guide opérationnel pour dissocier l’acceptation de l’envoi de SMS A2P, limiter la pression par destination et par route, et gérer les attentes, expirations et nouvelles tentatives sans aggraver un incident.
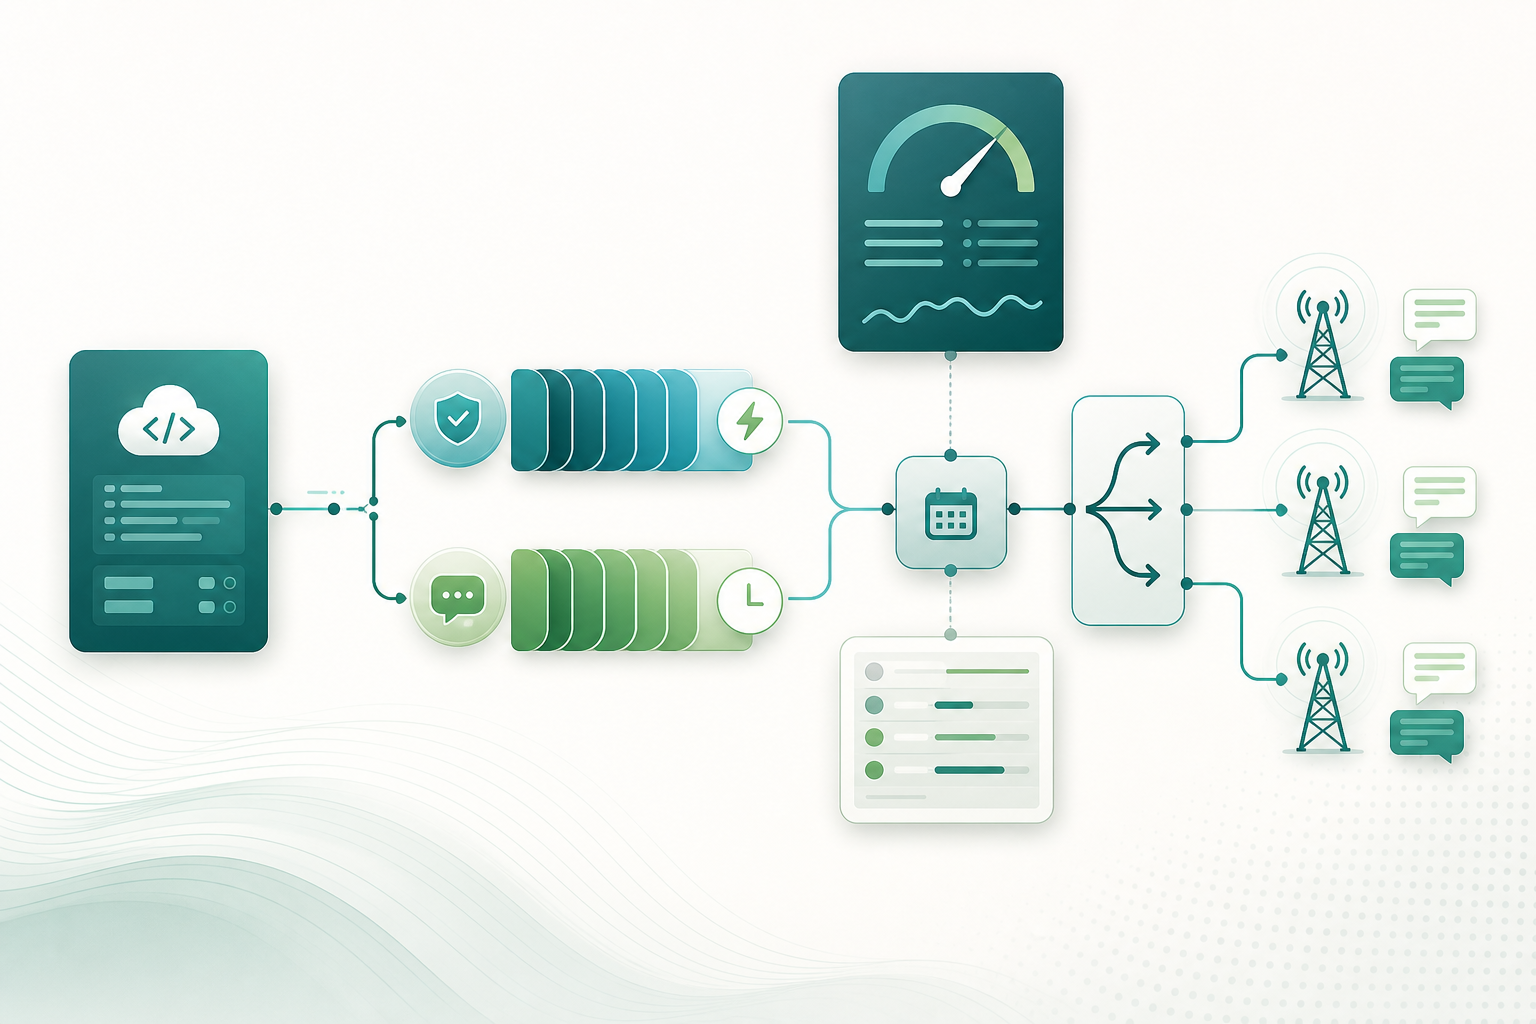
Que signifie le backpressure dans les SMS A2P ?
Le backpressure dans les SMS A2P désigne l’ensemble des contrôles qui empêchent l’afflux de requêtes de dépasser durablement la capacité réelle de traitement et d’envoi. Son objectif n’est pas d’accepter le plus grand nombre possible de requêtes, mais de préserver un comportement utile du trafic en cas de pics, de limites de débit, de congestion ou de dégradation d’une route.
Une réponse positive d’une API ne prouve pas que le message est arrivé sur le terminal. En SMPP, submit_sm soumet un message au Message Center pour une livraison ultérieure ; la demande d’un accusé de réception de livraison se configure séparément avec registered_delivery. De même, une plateforme peut accepter et placer un message en file d’attente avant de l’envoyer à un opérateur amont.
Si le système accepte plus de travail qu’il ne peut en évacuer, la profondeur et l’ancienneté de la file d’attente augmentent. Pour un trafic soumis à un délai, le résultat peut être pire qu’un rejet explicite : un OTP peut être envoyé trop tard, une notification transactionnelle peut perdre son utilité et les nouvelles tentatives peuvent multiplier les messages ou aggraver la saturation.
- Considérez l’acceptation comme un état d’admission, et non comme une preuve de livraison.
- Mesurez la capacité de sortie effective dans chaque périmètre pertinent, et pas uniquement la capacité d’entrée de l’API.
- Appliquez une pression vers l’amont avant que le travail accumulé ne dépasse le délai utile du message.
- Distinguez les états internes de file d’attente des états signalés par le réseau ou l’opérateur.
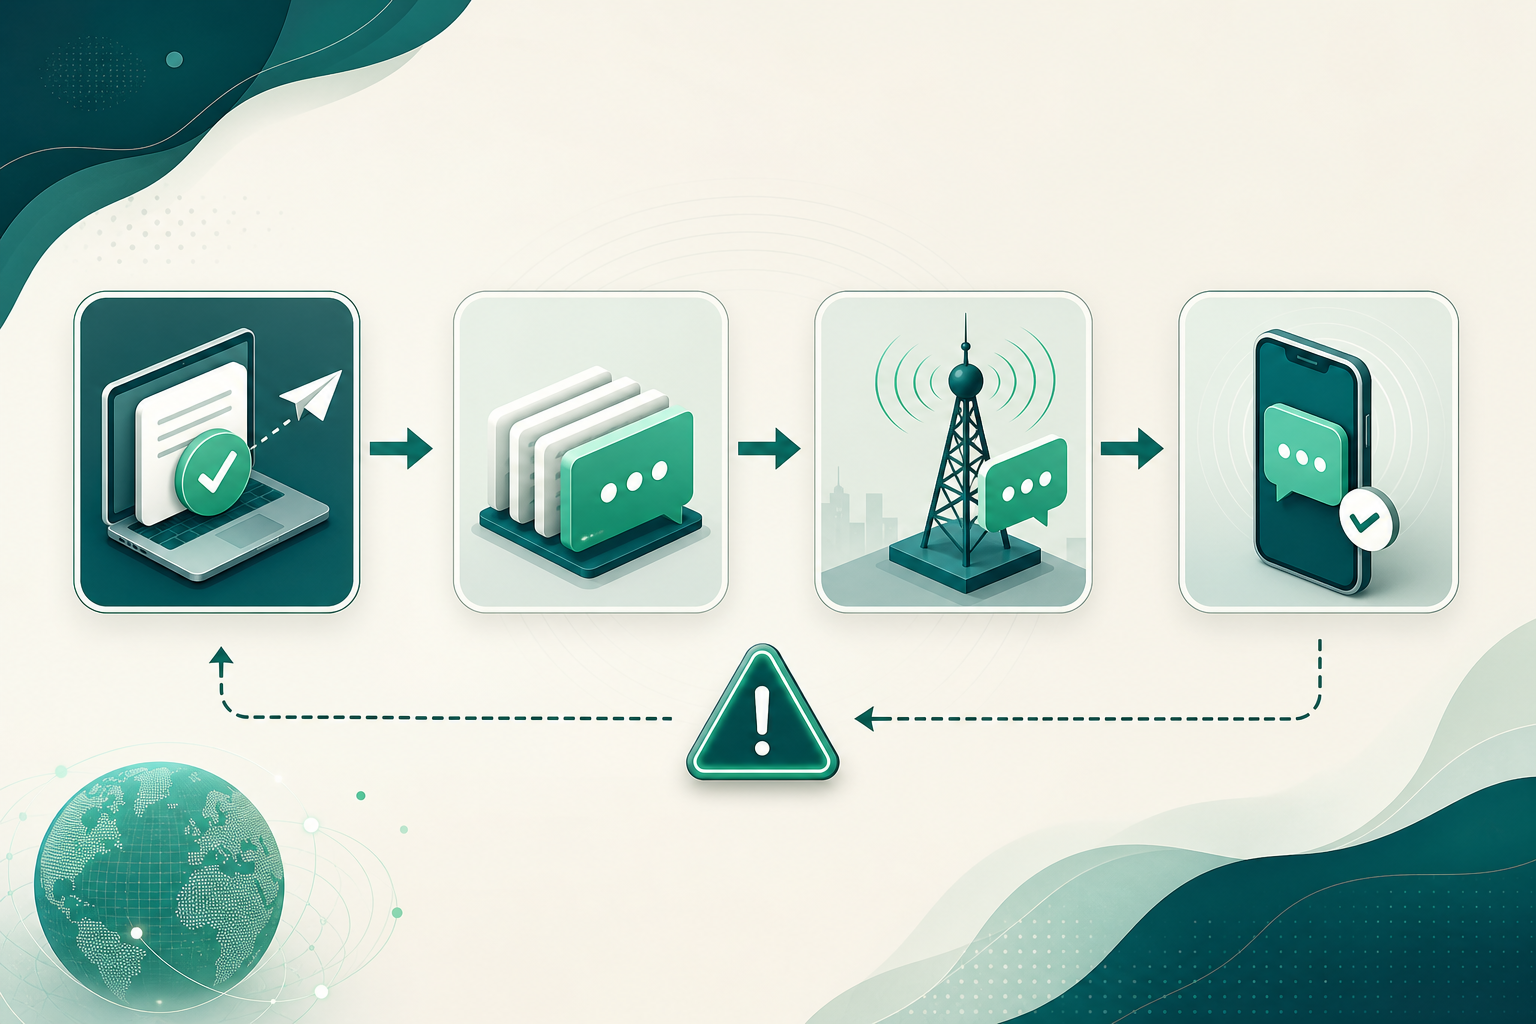
Séparez l’admission, la file d’attente, la planification et la confirmation d’état
Une conception exploitable répartit le cycle de vie en couches aux responsabilités distinctes. Cette séparation permet de décider où appliquer les limites et évite qu’un problème de livraison soit masqué par une API qui semble saine.
La couche d’admission valide la requête, contrôle sa clé d’idempotence, applique des quotas et décide si elle doit être acceptée, différée ou rejetée. La file d’attente conserve le travail admis avec suffisamment de métadonnées pour le prioriser, faire expirer les messages et éviter les doublons. Le planificateur choisit quel message peut partir selon la capacité disponible. La couche d’état enregistre les transitions internes ainsi que les réponses et DLR ultérieurs.
Il ne convient pas d’utiliser les DLR comme signal principal de contrôle en temps réel. Les événements générés par les opérateurs peuvent arriver longtemps après l’envoi ; la santé immédiate doit donc surtout s’appuyer sur les signaux d’admission, de file d’attente, de session et d’expédition.
- Admission : authentification, validation, classification, déduplication et décision d’accepter ou de rejeter.
- File d’attente : persistance, priorité, heure de création, délai utile, destination, route prévue et identifiant idempotent.
- Planification : sélection des messages soumise à des limites hiérarchiques et à la capacité observée.
- Confirmation : enregistrement de l’acceptation, de la mise en file, de la tentative de sortie, de la réponse technique, de l’expiration et du DLR lorsqu’il existe.
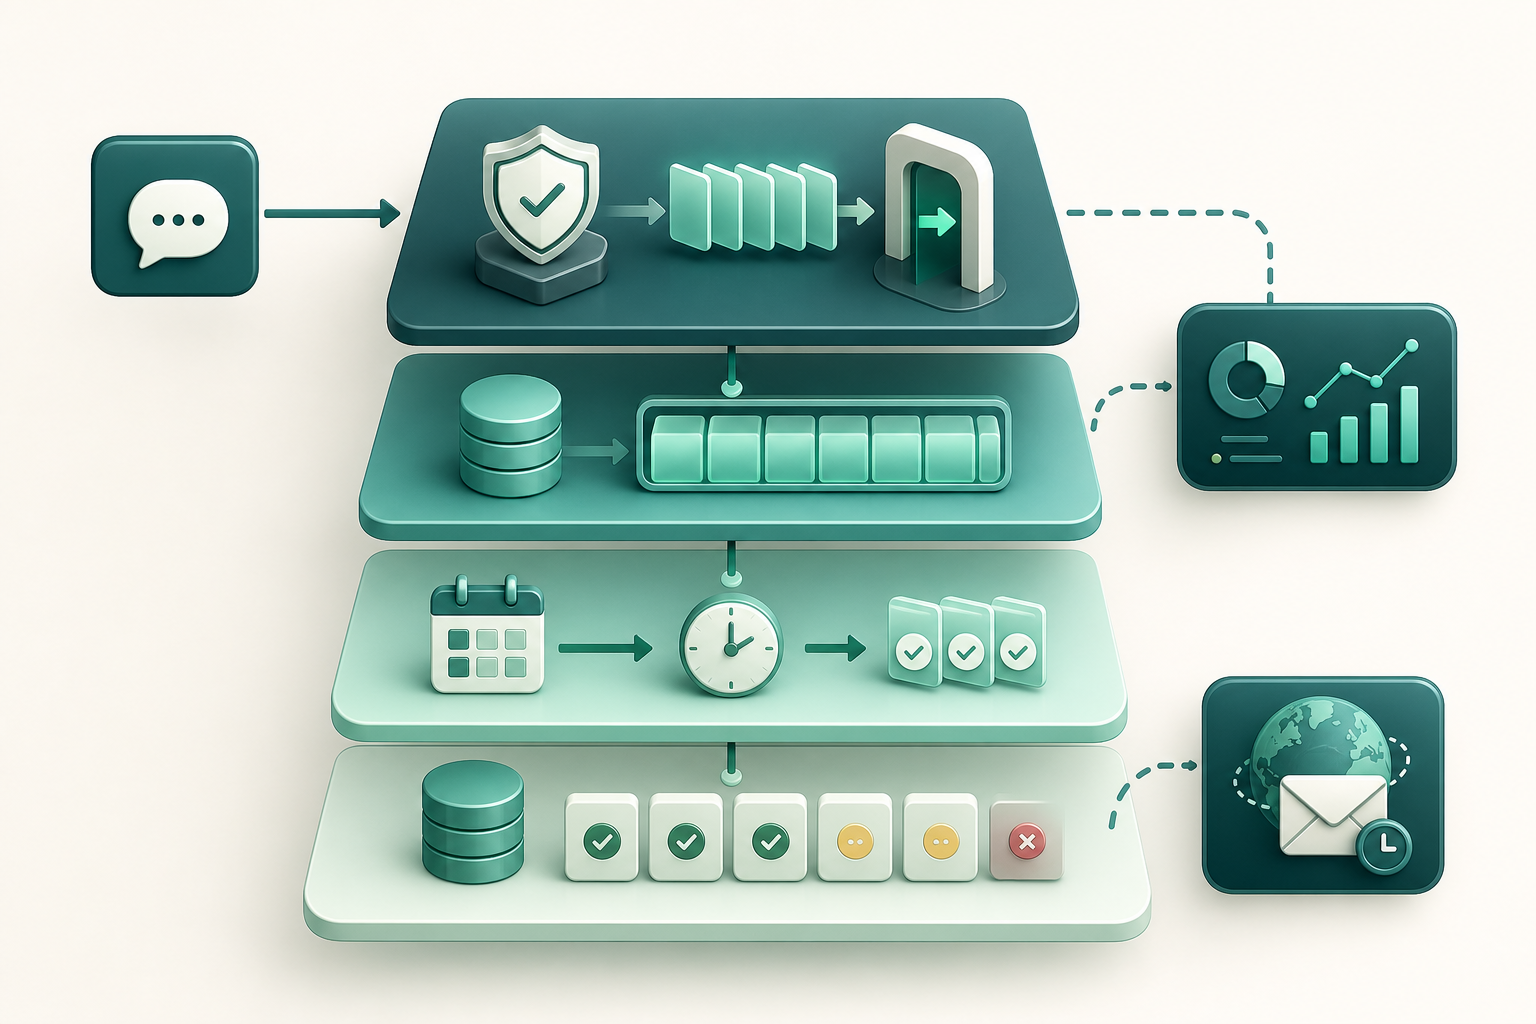
Détectez la pression avant que la file d’attente ne devienne un incident
L’indicateur le plus évident est une file d’attente qui grossit, mais il ne suffit pas. Une file peut rester stable tout en étant inacceptable si les messages vieillissent trop, si une destination consomme l’essentiel de la capacité ou si les nouvelles tentatives évinceraient le trafic neuf.
Définissez des seuils par classe de trafic et par périmètre de contrôle. Le seuil utile pour un OTP ne doit pas nécessairement être valable pour une notification transactionnelle non urgente, et un problème limité à une destination ou à une route ne devrait pas imposer l’arrêt de tout le trafic.
La latence d’acceptation mérite également un suivi. Si l’API commence à ralentir, elle peut accumuler du travail avant de répondre ou dépendre de composants déjà dégradés. Une admission explicite et bornée est préférable à des temps de réponse croissants et imprévisibles.
- Profondeur de file d’attente globale et par compte, application, destination, route, session et classe de trafic.
- Ancienneté maximale et percentiles d’ancienneté des messages qui n’ont pas encore été envoyés.
- Taux d’admission par rapport au taux d’expédition effective.
- Rejets temporaires, erreurs de session, temps de réponse et reconnexions SMPP.
- Nombre de messages expirant en interne, supprimés ou rejetés par politique.
- Pourcentage de capacité consommé par les nouvelles tentatives par rapport aux premières tentatives.
Classez le trafic avant sa mise en file d’attente
La priorité doit être attribuée avant que le message n’entre dans une file partagée. Il ne suffit pas d’étiqueter tout le trafic comme transactionnel : certains messages ont un délai strict, d’autres une utilité décroissante, tandis que d’autres peuvent attendre ou ne pas être envoyés pendant une dégradation.
Une classification pratique distingue les OTP, les messages transactionnels avec délai, le marketing fondé sur le consentement et le trafic non prioritaire. AWS différencie les messages transactionnels, critiques ou sensibles au temps des messages promotionnels, qui ne le sont pas. Cette distinction est utile comme point de départ, mais chaque organisation doit documenter ses propres priorités légitimes, obligations et délais.
La classification ne doit pas devenir un mécanisme permettant de contourner les règles relatives aux routes, au consentement ou à l’expéditeur. La priorité est une décision opérationnelle interne visant à utiliser une capacité limitée de manière cohérente avec la finalité légitime du message.
- OTP : messages à usage unique dont l’utilité est brève ; ils doivent avoir un budget d’attente court et une expiration stricte.
- Transactionnel avec délai : alertes, changements de statut ou notifications opérationnelles qui perdent leur valeur après un temps défini.
- Marketing fondé sur le consentement : trafic qui doit normalement pouvoir être différé, limité ou suspendu sans compromettre une opération critique.
- Non prioritaire : trafic peu urgent qui doit être le premier à être réduit ou rejeté en cas de pression.
Définissez des budgets d’attente et des expirations sans confondre les états
Chaque classe de messages nécessite un budget d’attente : le temps maximal pendant lequel elle peut rester sur votre propre plateforme avant qu’il ne soit plus pertinent de tenter son envoi. Ce budget doit être inférieur ou égal au délai utile pour l’activité et doit être examiné au regard de la capacité de sortie disponible.
L’expiration interne est une décision de votre système : par exemple, supprimer un OTP qui a attendu plus longtemps que permis avant de lui attribuer une route. Elle ne doit pas être communiquée comme un DLR opérateur. Conservez un état explicite tel que « expiré en interne » ou un équivalent, ainsi que le motif de la décision.
Lors de l’utilisation de SMPP, validity_period exprime le moment d’expiration dans le SMSC après lequel le message doit être abandonné s’il n’a pas été livré. Cette période de validité est distincte de l’attente préalable dans votre propre file d’attente et également distincte d’une confirmation de livraison au terminal. Dans les services de messagerie, le TTL contrôle la durée pendant laquelle la livraison d’un SMS est tentée, et non la garantie de recevoir un DLR final.
- Conservez pour chaque message : heure de création, échéance interne, période de validité demandée et motif d’expiration le cas échéant.
- Ne planifiez pas l’envoi de messages dont le budget interne est déjà épuisé.
- Exposez séparément : expiré avant envoi, expiré pendant la tentative de livraison et DLR reçu, lorsque cela s’applique.
- N’interprétez ni une expiration ni un état d’acceptation comme une confirmation de réception sur le terminal.
Appliquez des limites hiérarchiques et contrôlez les rafales
La capacité n’est pas un chiffre unique. Un système peut disposer d’une capacité agrégée suffisante tout en étant limité pour un compte, une application, une destination, une route, une session SMPP ou un fournisseur. Les limites doivent pouvoir se composer : un message ne part que s’il dispose d’un budget dans tous les périmètres applicables.
Un modèle de token bucket est utile pour appliquer un débit soutenu et limiter la rafale après une accumulation. Le débit limite l’expédition continue ; la taille de rafale limite la vitesse à laquelle une file accumulée peut être vidée. Cela évite qu’une reprise après une courte interruption ne crée une nouvelle congestion.
Appliquez la même limite d’expédition aux premières tentatives et aux nouvelles tentatives. Si les nouvelles tentatives échappent au contrôle, elles consomment une capacité qui devrait être réservée au trafic neuf ou prioritaire.
- Limite par compte, campagne ou application afin de protéger les quotas et l’isolation entre clients.
- Limite par destination pour éviter qu’une numérotation, un réseau ou un pays n’absorbe une capacité partagée.
- Limite par route et par fournisseur afin de respecter la capacité ou la restriction applicable.
- Limite par session SMPP afin de ne pas surcharger une connexion ou sa fenêtre opérationnelle.
- Réservation ou pondération par classe de trafic pour protéger les OTP et les autres flux soumis à un délai.
- Contrôle des rafales pour assurer une reprise progressive après une pause ou une dégradation.
Choisissez une stratégie d’admission explicite
Lorsqu’il n’y a pas suffisamment de capacité, quatre résultats sont légitimes : accepter, différer, rejeter ou demander à l’émetteur de réduire son débit. Le choix doit dépendre du délai utile, de la priorité documentée, de la possibilité de réessayer en toute sécurité et du caractère global ou localisé du manque de capacité.
Accepter signifie que le message entre dans la file d’attente avec un budget d’attente réaliste. Différer signifie le conserver pour une fenêtre ultérieure uniquement s’il aura encore une utilité. Rejeter est approprié lorsqu’il n’existe aucune possibilité raisonnable de respecter le délai ou lorsque la politique ne permet pas d’accumuler davantage de travail. Demander une réduction de débit est particulièrement utile pour les intégrations capables d’adapter leur production.
En HTTP, une surcharge temporaire peut être communiquée avec 503 et Retry-After. Il est préférable que le client reçoive un signal explicite et exploitable plutôt que d’accepter indéfiniment des requêtes susceptibles d’expirer. Pour que cette intégration soit sûre, documentez clairement la sémantique des nouvelles tentatives et des clés d’idempotence.
- N’acceptez que si la file d’attente et la capacité indiquent que le message peut partir dans son budget.
- Différez le trafic tolérant l’attente, avec une échéance qui empêche son envoi tardif.
- Rejetez les OTP ou messages dont le délai est épuisé ou irréalisable, avec une cause lisible par les machines et les équipes d’exploitation.
- Renvoyez une indication de réduction temporaire du débit lorsque l’interface le permet.
- Ne transformez pas un rejet d’admission en une acceptation silencieuse qui se termine dans une file illimitée.
Planifiez la file d’attente avec équité et priorités documentées
La planification doit empêcher qu’un seul client, une seule campagne ou une seule destination consomme toute la capacité disponible. Dans le même temps, elle ne doit pas modifier de manière opaque des priorités métier légitimes, telles que la protection des OTP face au marketing fondé sur le consentement pendant une restriction.
Une combinaison raisonnable consiste à utiliser des files par classe de trafic et à appliquer des limites par locataire, destination et route avant de sélectionner le message suivant. Au sein d’une même classe, une politique de partage équitable peut empêcher qu’une source très active monopolise l’expédition.
L’ordre strict d’arrivée n’est pas toujours le bon ordre. En présence de délais, il peut être préférable de prioriser, dans une même classe, les messages proches de l’expiration, à condition que la politique évite l’inanition des autres messages. Toute exception doit être explicite, auditable et cohérente avec la finalité du trafic.
- Évitez une file globale unique dépourvue de métadonnées de priorité, de destination et d’échéance.
- Isolez les destinations ou routes dégradées afin qu’elles ne bloquent pas le trafic sain.
- Utilisez des quotas ou un partage équitable au sein de catégories équivalentes.
- Protégez les priorités documentées sans étiqueter à tort un trafic non urgent comme critique.
- Vérifiez régulièrement si certains messages n’obtiennent jamais de créneau d’expédition.
Questions fréquentes
L’acceptation d’un SMS par une API signifie-t-elle qu’il a déjà été livré ?
Non. L’acceptation indique que la requête a été admise ou placée en file d’attente. En SMPP, submit_sm soumet le message pour une livraison ultérieure. La livraison et les accusés de réception de livraison sont des étapes distinctes, et un DLR, lorsqu’il est reçu, ne doit pas non plus être confondu avec une garantie universelle et immédiate.
Quand faut-il rejeter un OTP plutôt que le placer en file d’attente ?
Il convient de le rejeter explicitement lorsque la capacité disponible et l’ancienneté de la file indiquent qu’il ne pourra pas partir dans son délai utile. Envoyer un OTP trop tard peut être moins utile que d’informer l’émetteur afin qu’il applique son processus de récupération ou génère un nouveau code.
Les nouvelles tentatives doivent-elles avoir une limite de débit distincte ?
Elles doivent être soumises au même contrôle d’expédition que les premières tentatives et, en outre, être limitées en nombre de tentatives et dans le temps. Si elles sont exclues de la limite, elles peuvent consommer la capacité disponible et prolonger une congestion.
Un validity_period SMPP remplace-t-il une expiration interne ?
Non. validity_period définit l’expiration dans le SMSC, après laquelle le message doit être abandonné s’il n’a pas été livré. La plateforme a toujours besoin d’un budget d’attente interne pour empêcher que des messages devenus inutiles n’arrivent trop tard au SMSC.
Faut-il utiliser les DLR pour détecter une dégradation en temps réel ?
Pas comme signal unique. Les événements provenant des opérateurs peuvent arriver avec un retard considérable. Pour un contrôle opérationnel immédiat, surveillez l’admission, la profondeur et l’ancienneté de la file d’attente, l’expédition, les erreurs techniques, l’état de santé des sessions et le comportement par destination ou par route.
Comment éviter les doublons lorsqu’un client réessaie une requête HTTP ?
Utilisez une clé d’idempotence persistante ou un mécanisme équivalent permettant de reconnaître une requête déjà appliquée. Les nouvelles tentatives automatiques d’opérations non idempotentes sont dangereuses si l’émetteur ne peut pas savoir si la requête initiale a été traitée.
Sources consultées
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9110: HTTP SemanticsIETF
- Cloud Tasks: Configure queue routing, limits, and retriesGoogle Cloud
- Cloud Tasks v2 API reference: RateLimitsGoogle Cloud
- AWS End User Messaging SMS: How SMS worksAmazon Web Services
- AWS End User Messaging SMS: Event types for SMS, MMS, and voiceAmazon Web Services
- AWS End User Messaging SMS: Example of sending an SMS or voice messageAmazon Web Services
- Messages resourceTwilio
- Outbound Message Status in Status CallbacksTwilio
- 30036: Validity Period ExpiredTwilio
- 30001: Queue overflowTwilio