SMS-OTP-Latenz: Wie Sie sinnvolle Alarmgrenzwerte festlegen
Praxisleitfaden zur Aufschlüsselung der OTP-Latenz nach Prozessschritten, zur Auswahl von Kennzahlen und Beobachtungsfenstern und zur Einrichtung von Alarmen, die Anomalien erkennen, ohne einen DLR mit einer Empfangsbestätigung zu verwechseln.
Warum die durchschnittliche Latenz zur Überwachung von OTP nicht ausreicht
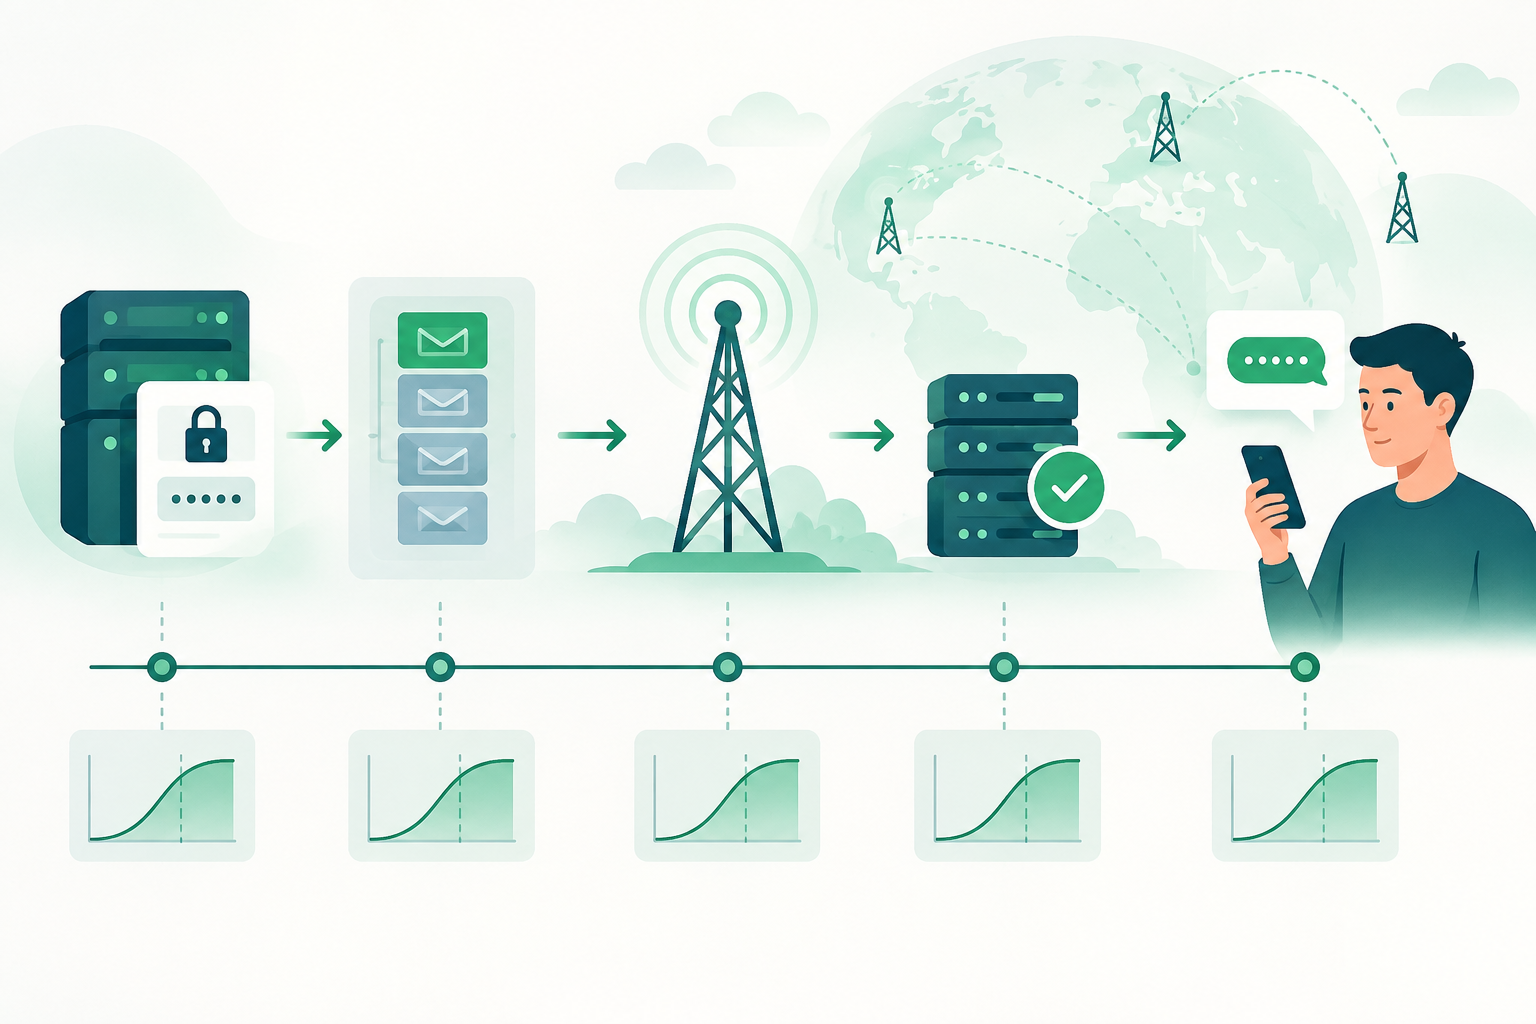
Der Mittelwert fasst die Gesamtheit zusammen, kann aber einen deutlich langsameren Nachrichtenrückstand verschleiern, der einen Teil der Sitzungen betrifft. Bei der Überwachung von OTP sollten Sie deshalb die Zeitverteilung betrachten und sich nicht auf einen einzigen Durchschnittswert verlassen.
Perzentile helfen dabei, unterschiedliche Fragen zu beantworten: Der Median beschreibt die Mitte der Verteilung; ein hohes Perzentil zeigt die Erfahrung der langsamsten Fälle, ohne dass wenige Extremwerte die Kennzahl dominieren. Die verfügbaren Daten belegen kein universelles Perzentil, das für alle Anwendungen, Zielgebiete oder Routen geeignet wäre.
Legen Sie vor der Einrichtung eines Alarms fest, welches Ereignis den Anfang und welches das Ende markiert. Verwendet jede Komponente unterschiedliche Zeitstempel oder Kriterien, kann der Vergleich Unterschiede bei der Messung statt einer tatsächlichen Änderung des Dienstes widerspiegeln.
- Behalten Sie den Mittelwert als ergänzende Kennzahl bei, nicht als einziges Signal.
- Vergleichen Sie Perzentile mit derselben Berechnungsmethode und derselben Definition von Anfang und Ende.
- Interpretieren Sie jedes Perzentil zusammen mit der Zahl der Beobachtungen: Bei kleinen Stichproben können die Ergebnisse instabil sein.
Den Ablauf des OTP abbilden und ein Zeitbudget je Prozessschritt festlegen
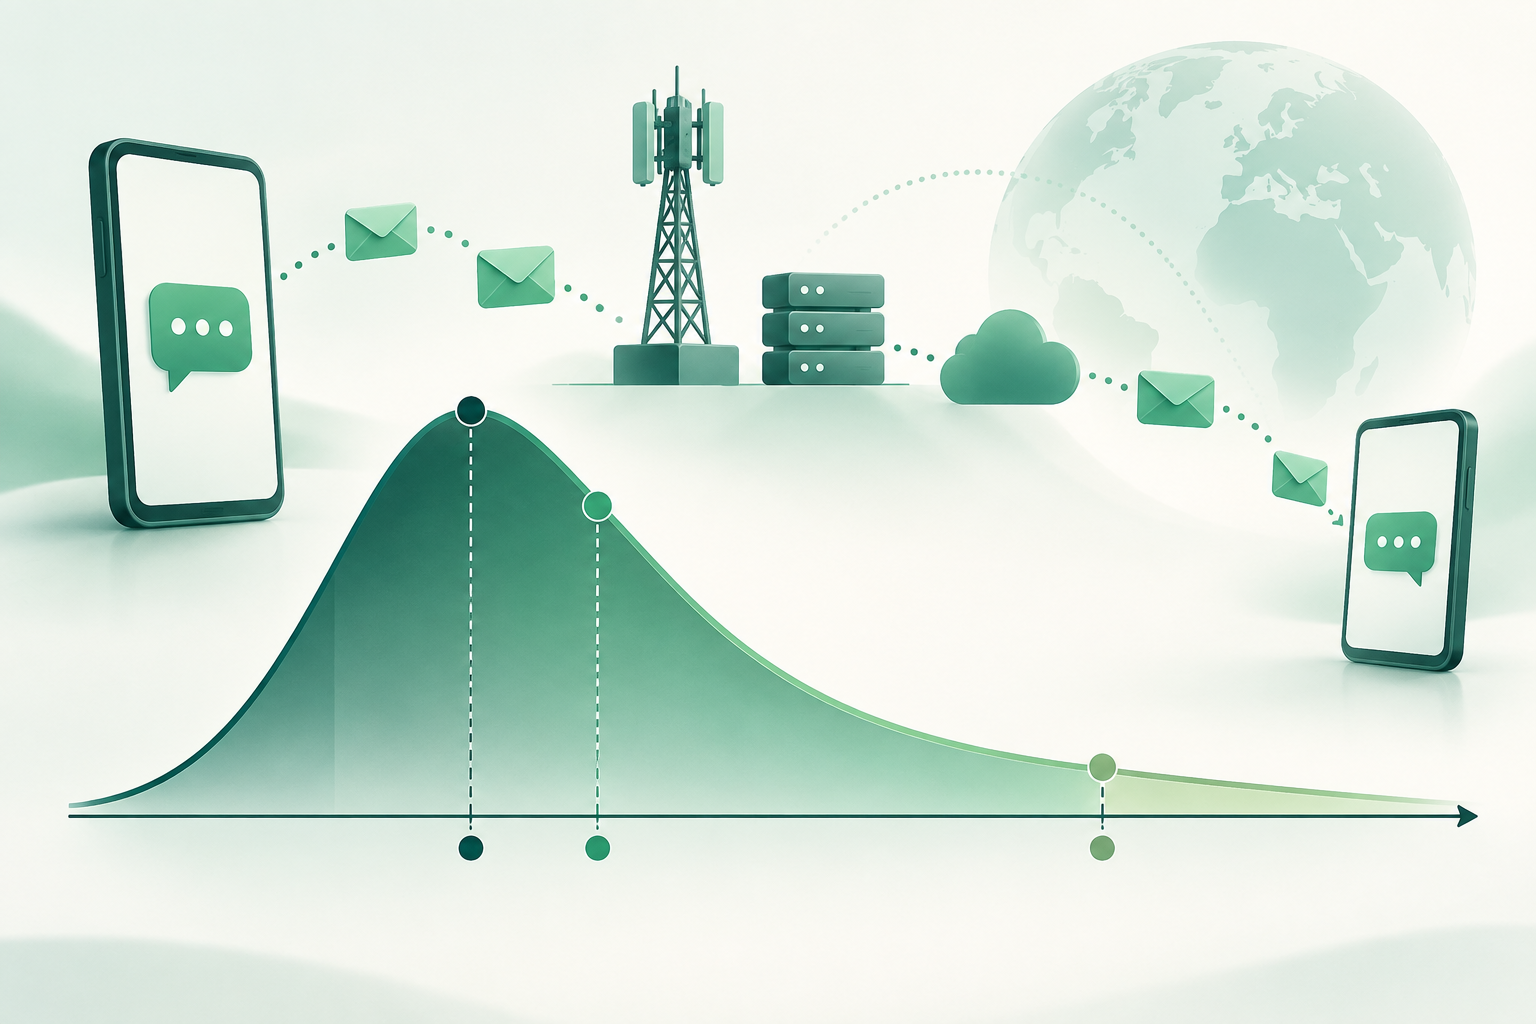
Eine Gesamtzeit gibt nur an, wie viel Zeit zwischen zwei ausgewählten Ereignissen vergangen ist. Um Verzögerungen einzugrenzen, sollten Sie den Ablauf anhand eigener Zeitstempel aufschlüsseln: Erstellung des Codes, Eintritt in die Warteschlange und Wartezeit, Versand an den Anbieter und Eingang eines gemeldeten Status. Erfassen Sie auch den Zeitpunkt, zu dem die Anwendung eine Antwort des Anbieters erhält, sofern dieses Ereignis Teil Ihrer Integration ist.
Nicht alle Plattformen stellen dieselben Ereignisse bereit, und die Zeit zwischen zwei Prozessschritten kann interne Arbeit, Wartezeit oder Kommunikationslatenz umfassen. Dokumentieren Sie, was jedes Intervall misst und welche Komponenten nicht berücksichtigt werden. Addieren Sie keine sich überschneidenden Zeitspannen und vergleichen Sie keine Zeitstempel von Uhren, die nicht ausreichend synchronisiert sind.
Ein Zeitbudget je Prozessschritt ist ein von Ihnen festgelegtes Betriebsziel, keine universelle technische Grenze und keine Zustellgarantie. Orientieren Sie sich zunächst an den Produktanforderungen und an Beobachtungen unter normalen Bedingungen. Verteilen Sie die verfügbare Zeit auf messbare und steuerbare Prozessschritte. Überprüfen Sie die Aufteilung, wenn sich Architektur, Integration oder beobachtetes Verhalten ändern.
- Definieren Sie für jedes Intervall Anfangs- und Endereignis.
- Ermitteln Sie, welches Team oder welche Komponente auf den jeweiligen Prozessschritt Einfluss nehmen kann.
- Kennzeichnen Sie Fälle ohne vollständige Zeitstempel als unvollständige Daten, statt eine Dauer zu erfinden.
- Verwenden Sie ein internes Ziel weder als Versprechen an Nutzer noch als Zustellgarantie.
Perzentile, Datenvolumen und Beobachtungsfenster auswählen
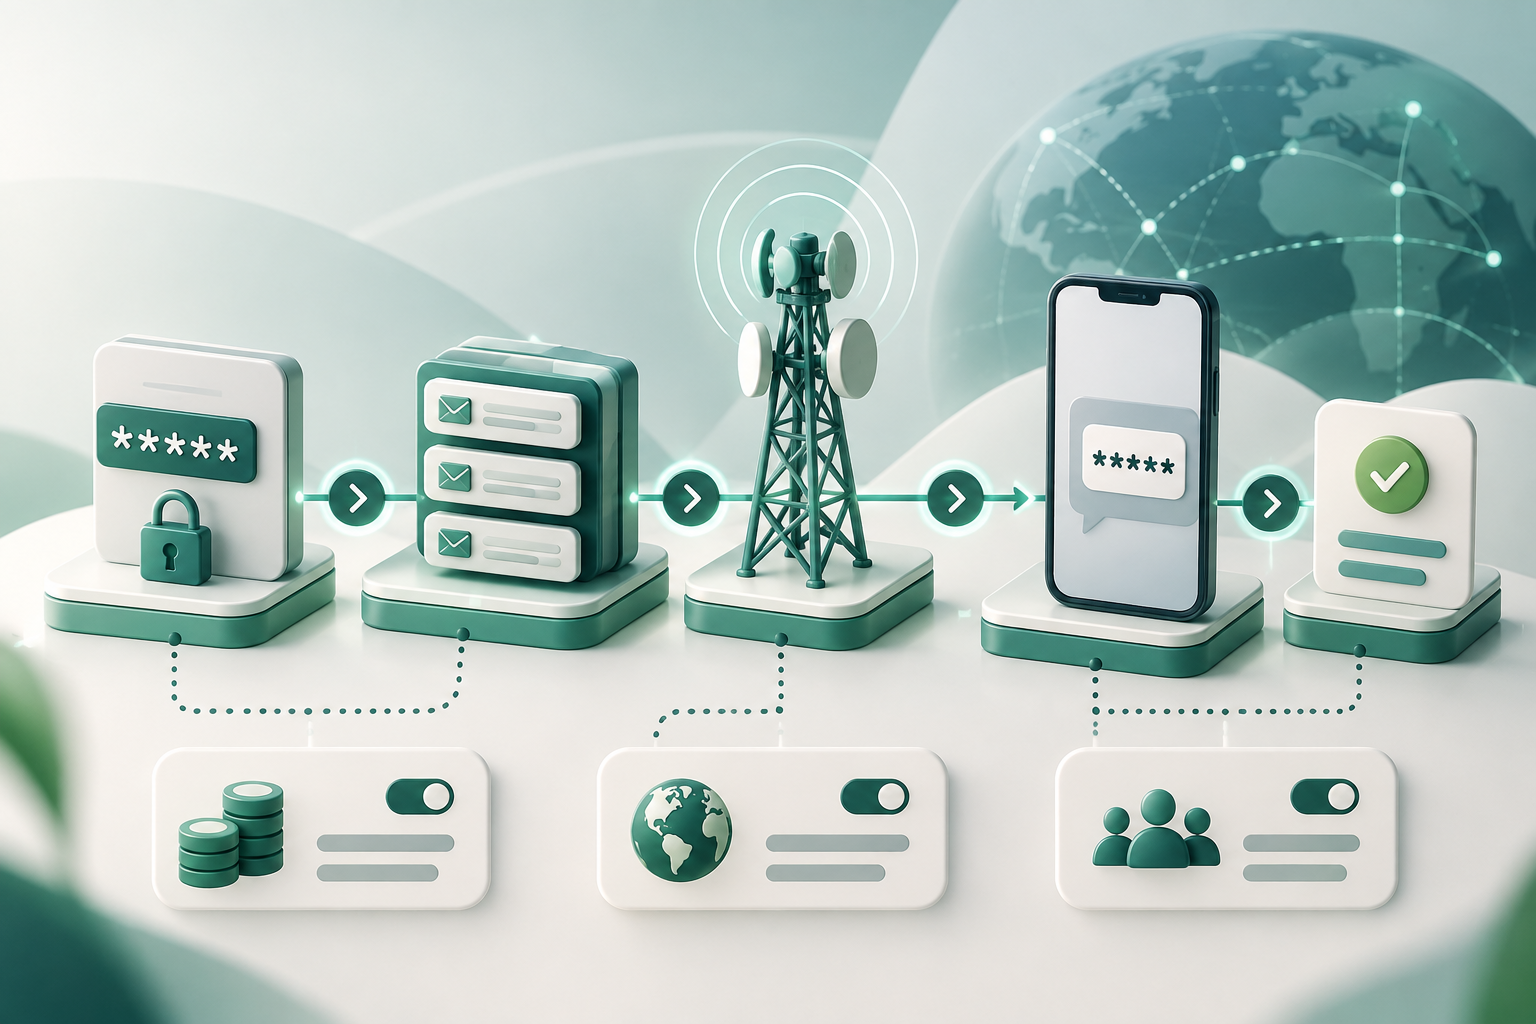
Wählen Sie Kennzahlen danach aus, welche Entscheidung sie unterstützen sollen. Der Median kann das typische Verhalten zeigen; ein hohes Perzentil kann auf eine Verschlechterung am langsamen Ende der Verteilung hinweisen. Betrachten Sie bei Bedarf beide Kennzahlen zusammen mit dem Datenvolumen und dem Anteil der Ereignisse ohne Ergebnis. Stellen Sie keinen Wert als repräsentativ dar, wenn nur wenige Beobachtungen vorliegen.
Das Beobachtungsfenster muss zwischen Reaktionsgeschwindigkeit und Stabilität abwägen. Ein kurzes Fenster kann schnell reagieren, aber auch zufällige Schwankungen verstärken. Ein langes Fenster glättet Schwankungen, kann jedoch Änderungen später sichtbar machen. Die Auswahl hängt vom Volumen, dem Verkehrsaufkommen und der erforderlichen Reaktionszeit des Teams ab; die verfügbaren Daten nennen keine empfohlene Dauer.
Wenn Sie dynamische Schwellenwerte verwenden, prüfen Sie, wie das Tool diese ermittelt und anpasst, bevor Sie sich auf seine Alarme verlassen. Die Dokumentation von Microsoft zu Azure Monitor gibt an, dass dynamische Schwellenwerte beim Erstellen einer Regel zehn Tage historische Daten verwenden. Dieses Verhalten gilt für diese konkrete Funktion und sollte nicht als allgemeine Regel für andere Systeme verstanden werden.
- Halten Sie Perzentil, Zeitfenster, angewendetes Mindestvolumen und Umgang mit unvollständigen Daten fest.
- Prüfen Sie, ob ein Fenster in Ihrem Kontext genügend Ereignisse enthält, damit die Kennzahl aussagekräftig ist.
- Bewerten Sie, ob eine Änderung anhaltend und relevant ist, bevor Sie eine kurze Schwankung als Vorfall einstufen.
Versandlatenz, Eingang eines DLR und Nutzerbestätigung voneinander trennen
Führen Sie die einzelnen Meilensteine in Ihren Kennzahlen getrennt. Die Antwort auf eine Versandanforderung, ein später von der Nachrichtenkette gemeldeter Status und eine Bestätigung in der Anwendung sind unterschiedliche Ereignisse. Messen Sie jedes Ereignis mit einem eigenen Zeitstempel und benennen Sie es eindeutig.
Ein DLR ist ein Status, der von einer Komponente der Nachrichtenkette gemeldet wird. Seine konkrete Bedeutung hängt von der Implementierung und dem gemeldeten Status ab. Stellen Sie ihn allein nicht als unabhängigen Nachweis dafür dar, dass die SMS auf dem Endgerät angezeigt wurde oder die Person sie gelesen hat.
Gibt ein Nutzer den Code ein, kann dieses Ereignis bestätigen, dass der Authentifizierungsablauf fortgeschritten ist. Es ist jedoch nicht automatisch eine reine Zustellmessung: Das Verhalten des Nutzers und weitere Schritte der Anwendung können das Ergebnis beeinflussen. Halten Sie die technische Kennzahl zum gemeldeten Status und das im Produkt beobachtete Ergebnis getrennt.
- Kennzeichnen Sie angenommene Versandanforderung, gemeldeten Status und Abschluss des Authentifizierungsablaufs getrennt.
- Dokumentieren Sie die Bedeutung der Statusmeldungen für die konkrete Integration; übertragen Sie Statuscodes nicht pauschal auf andere Implementierungen.
- Weisen Sie in Berichten auf die Unsicherheit hin, wenn eine unabhängige Bestätigung vom Endgerät fehlt.
Schwellenwerte nach Zielgebiet und Kontext festlegen, ohne daraus Garantien abzuleiten
Ein aggregierter Schwellenwert kann verschleiern, dass sich ein Teil des Verkehrs anders verhält. Vergleichen Sie, sofern Volumen und Datenlage es zulassen, relevante Gruppen wie Zielgebiet oder Route und behalten Sie eine Gesamtansicht bei, um weitreichende Auswirkungen zu erkennen. Verwenden Sie einheitliche und dokumentierte Kennungen für Zielgebiete; der Segmentierungsplan sollte sich danach richten, was Ihr System tatsächlich erfasst.
Eine zu starke Aufteilung führt zu Gruppen mit wenigen Stichproben und instabilen Ergebnissen. Behalten Sie eine aggregierte Kategorie bei, wenn die Daten keine vorsichtige Schlussfolgerung zulassen. Leiten Sie nicht allein deshalb eine Ursache bei einem Anbieter oder einer Route ab, weil sich gleichzeitig eine Kennzahl verändert hat.
Schwellenwerte geben an, wann eine Abweichung von einem Ziel oder einer internen Basislinie untersucht werden sollte. Sie belegen weder, dass eine Nachricht innerhalb einer bestimmten Frist zugestellt wird, noch dass eine Route für jeden Nutzer oder jede Sitzung dasselbe Ergebnis liefert.
- Beginnen Sie mit Dimensionen, die konkrete betriebliche Maßnahmen ermöglichen.
- Berücksichtigen Sie bei jedem Vergleich Datenvolumen und Abdeckung.
- Veröffentlichen Sie interne Messungen oder nicht vergleichbare Stichproben nicht als Marktbenchmarks.
Alarme mit Persistenz, Mindestvolumen und Schweregrad gestalten
Ein handlungsrelevanter Alarm verbindet eine Kennzahl, eine Bedingung, ein Zeitfenster und ein ausreichendes Datenvolumen für die Interpretation. Wählen Sie diese Elemente anhand der Daten Ihres eigenen Dienstes und der verfügbaren betrieblichen Reaktionszeit aus; es gibt keine verifizierten universellen Werte dafür.
Um Benachrichtigungen aufgrund einzelner Schwankungen zu vermeiden, können Sie verlangen, dass die Bedingung über einen Zeitraum anhält oder bei mehreren Auswertungen wiederholt auftritt. Passen Sie die Persistenz an die Auswirkungen und das Risiko einer verzögerten Reaktion an. Trennen Sie Signale für eine erhöhte Latenz von Signalen für fehlende Statusmeldungen oder Integrationsfehler: Sie erfordern unterschiedliche Diagnosen.
Legen Sie den Schweregrad anhand der beobachteten Auswirkungen und der Handlungsmöglichkeiten fest, nicht allein anhand der Abweichung einer Kennzahl von ihrem Referenzwert. Ein Untersuchungsalarm kann zur Prüfung einer Anomalie auffordern; eine Eskalation sollte Bedingungen vorbehalten bleiben, die das Team als relevant für den Dienst definiert hat.
- Nennen Sie im Alarm den Prozessschritt, das Perzentil, das Zeitfenster, das Datenvolumen und die betroffenen Gruppen.
- Legen Sie fest, wer die Untersuchung übernimmt und welche Nachweise vor einer Eskalation geprüft werden müssen.
- Testen Sie das Verhalten der Regel nach Möglichkeit mit historischen oder simulierten Daten, ohne davon auszugehen, dass der Test die künftige Leistung garantiert.
Einen Alarm untersuchen: Prozessschritte, Zielgebiete und Status vergleichen
Prüfen Sie zunächst, ob die Änderung durch Anpassungen an der Instrumentierung, den Uhren, dem Datenvolumen oder den Einschlusskriterien entstanden sein könnte. Vergleichen Sie anschließend die Dauer je Prozessschritt mit der Gesamtzeit: Konzentriert sich die Verzögerung auf einen Prozessschritt, lenkt das die Untersuchung auf die dafür zuständigen Komponenten, ohne eine Ursache zu beweisen.
Vergleichen Sie die Gesamtansicht mit den Gruppen nach Zielgebiet oder Route, sofern diese genügend aussagekräftige Stichproben enthalten. Prüfen Sie gemeldete Statusmeldungen und Fälle ohne Status getrennt, denn ein verzögerter Eingang eines DLR beweist für sich genommen nicht, dass sich auch der Versand verzögert hat.
Dokumentieren Sie den betroffenen Zeitraum, die beobachteten Gruppen, kürzlich erfolgte Änderungen und die Einschränkungen der Daten. Lassen sich mögliche Ursachen anhand der Nachweise nicht unterscheiden, formulieren Sie das Ergebnis als noch zu prüfende Hypothese.
- Prüfen Sie zuerst Vollständigkeit, Volumen und Konsistenz der Zeitstempel.
- Ermitteln Sie, in welchem Intervall die Abweichung auftritt, bevor Sie eine Ursache zuweisen.
- Vergleichen Sie Gruppen nur, wenn ihre Daten ausreichend und vergleichbar sind.
- Unterscheiden Sie zwischen fehlendem Status, Latenz beim Statuseingang und Latenz in anderen Prozessschritten.
Schwellenwerte überprüfen und Unsicherheiten dokumentieren
Schwellenwerte müssen überprüft werden, wenn sich Produkt, Instrumentierung, Verkehrsaufkommen oder betriebliche Bedingungen ändern. Bewahren Sie die Änderungshistorie auf und erläutern Sie, welche Nachweise jede Anpassung begründet haben. Ändern Sie eine Regel nicht einfach, um einen Alarm stummzuschalten, ohne zuvor zu prüfen, ob das Signal eine tatsächliche Änderung anzeigt.
Dokumentieren Sie Ausschlüsse, unvollständige Ereignisse, Gruppen mit geringem Datenvolumen und die Grenzen der Aussagen, die sich aus den jeweiligen Statusmeldungen ableiten lassen. So können Trends mit der nötigen Vorsicht interpretiert werden und interne Messwerte werden nicht mit externen Garantien verwechselt.
BulkSMSMarket beschreibt eine Plattform in Entwicklung, mit der A2P-SMS-Kapazitäten entdeckt, verglichen, gekauft, verkauft und verwaltet werden können, sowie eine interne Testplattform, die unter anderem Latenz und DLR-Konsistenz beobachtet. Öffentliche Kennzahlenkarten dienen der Demonstration, bis Vertragsdaten angebunden sind; sie sollten weder als Live-Kennzahlen für den Geschäftsbetrieb noch als Referenzschwellenwerte verwendet werden.
- Halten Sie die Definition der Kennzahl, die geltende Regel, ihre Ausschlüsse und das Datum der Überprüfung fest.
- Bewerten Sie Schwellenwerte nach relevanten Änderungen neu und prüfen Sie, ob der Vergleich weiterhin gültig ist.
- Machen Sie klar kenntlich, was beobachtete Daten, was ein internes Ziel und welche Unsicherheiten noch bestehen.
Häufige Fragen
Welches Perzentil sollte ich für Alarme zur SMS-OTP-Latenz verwenden?
Es gibt kein universell geeignetes Perzentil, das für alle Dienste belegt ist. Wählen Sie die Kennzahl entsprechend der Nutzererfahrung, die Sie überwachen möchten, und prüfen Sie ihre Stabilität anhand des verfügbaren Datenvolumens. Median und ein hohes Perzentil können ergänzende Perspektiven bieten.
Wie lang sollte das Beobachtungsfenster sein?
Das hängt vom Datenvolumen, dem Verkehrsmuster und der Reaktionszeit ab, die Ihr Betrieb benötigt. Ein kurzes Fenster reagiert schneller, ist aber möglicherweise empfindlicher gegenüber Schwankungen. Ein langes Fenster glättet Schwankungen, kann die Erkennung jedoch verzögern. Eine universell verifizierte Dauer gibt es nicht.
Bestätigt ein DLR, dass das OTP auf dem Telefon angekommen ist?
Nicht für sich allein. Ein DLR ist ein von der Nachrichtenkette gemeldeter Status, dessen Bedeutung von der Implementierung abhängt. Er ist nicht zwangsläufig eine unabhängige Bestätigung des Eingangs auf dem Endgerät und bestätigt auch nicht, dass der Nutzer die Nachricht gelesen hat.
Sollte ich unterschiedliche Schwellenwerte für Zielgebiete oder Routen einrichten?
Das kann hilfreich sein, wenn die Segmentierung die Untersuchung von Unterschieden ermöglicht und ausreichend vergleichbare Daten vorliegen. Bei kleinen Gruppen können Kennzahlen instabil sein. Behalten Sie eine aggregierte Ansicht bei und weisen Sie auf die Unsicherheit hin.
Garantieren Alarmgrenzwerte die Zustellung des OTP?
Nein. Sie sind betriebliche Kontrollen, die Abweichungen bei definierten Kennzahlen anzeigen. Sie garantieren weder die Zustellung noch den Empfang innerhalb einer bestimmten Frist oder ein identisches Ergebnis für jede Nachricht.
Verwendete Quellen
- Azure Monitor: umbrales dinámicosMicrosoft Learn
- Especificaciones 3GPP3GPP
- ITU-T E.164International Telecommunication Union
- NIST SP 800-63-4NIST
- OWASP Authentication Cheat SheetOWASP
- GSMA: redes y tecnologíasGSMA