Latenza degli OTP via SMS: come definire soglie di allerta utili
Guida pratica per analizzare la latenza degli OTP per fasi, scegliere metriche e finestre di osservazione e creare avvisi che rilevino anomalie senza confondere un DLR con una conferma di ricezione.
Perché la latenza media non basta per monitorare gli OTP
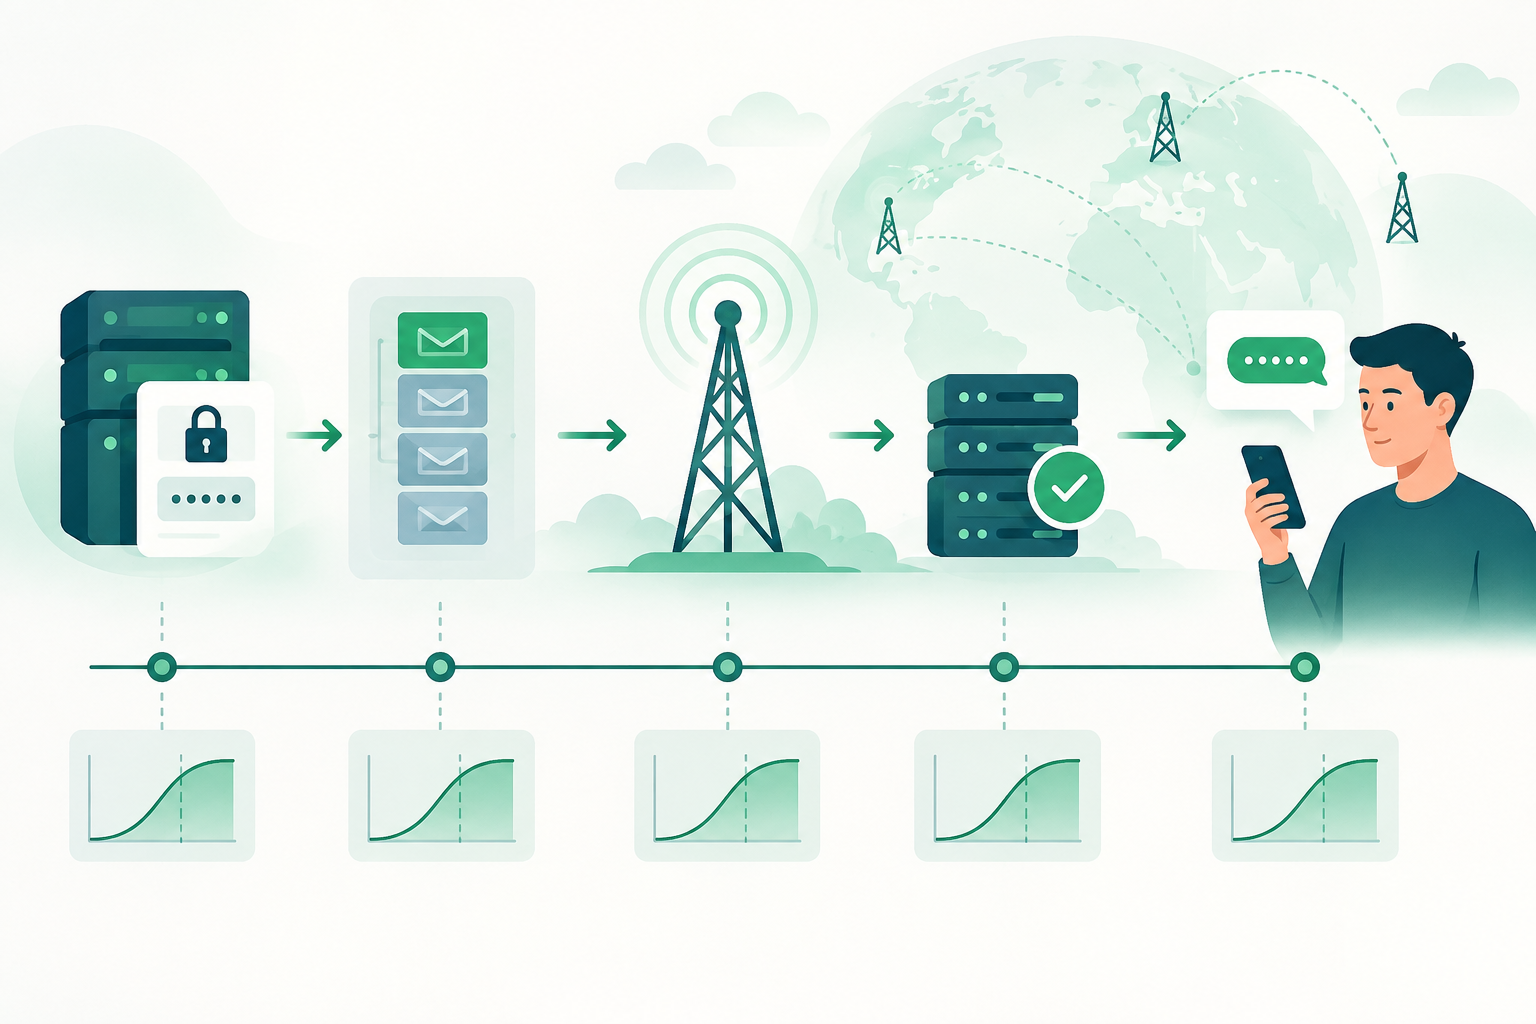
La media riassume l’insieme, ma può nascondere una coda di messaggi molto più lenti che interessa una parte delle sessioni. Per questo, nel monitoraggio degli OTP è opportuno osservare la distribuzione dei tempi e non affidarsi a un’unica media.
I percentili aiutano a porre domande diverse: la mediana descrive il centro della distribuzione; un percentile alto permette di osservare l’esperienza dei casi più lenti senza lasciare che pochi valori estremi dominino la metrica. Le evidenze disponibili non indicano un percentile universale valido per tutte le applicazioni, le destinazioni o le rotte.
Prima di impostare un avviso, definisci quale evento segna l’inizio e quale la fine. Se ogni componente usa marcature temporali o criteri diversi, il confronto può riflettere differenze di misurazione e non un cambiamento reale del servizio.
- Mantieni la media come indicatore complementare, non come unico segnale.
- Confronta i percentili usando lo stesso metodo di calcolo e le stesse definizioni di inizio e fine.
- Interpreta ogni percentile insieme al volume delle osservazioni: un campione ridotto può produrre risultati instabili.
Mappare il percorso dell’OTP e assegnare un budget per fase
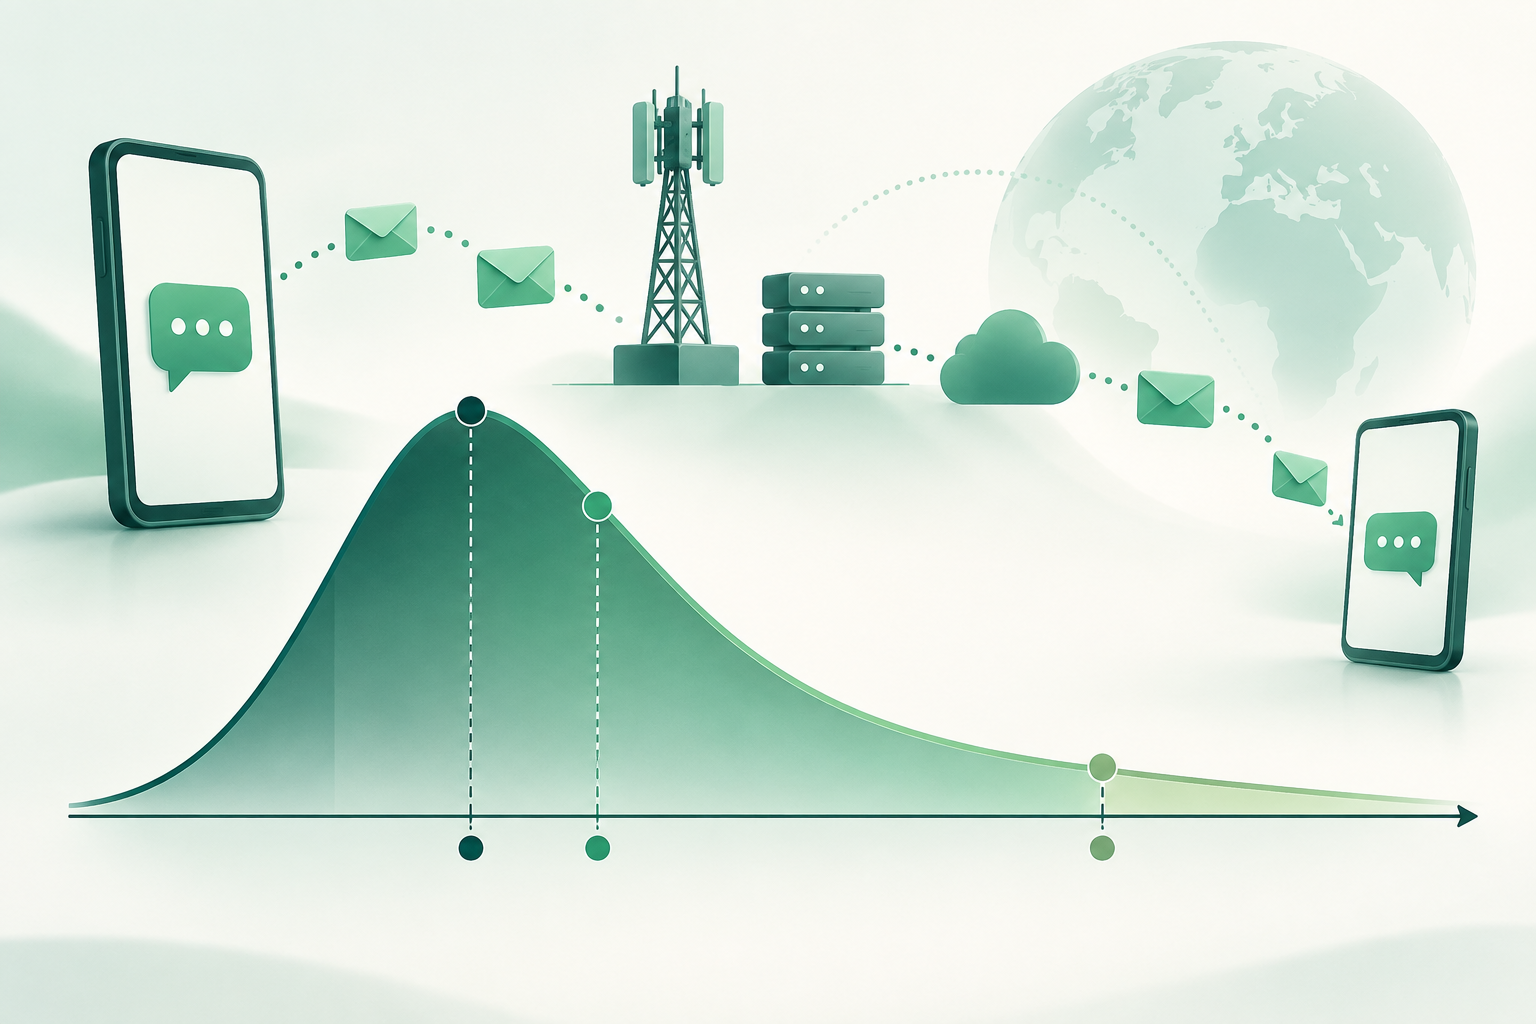
Un tempo totale indica solo quanto è trascorso tra due eventi scelti. Per individuare i ritardi, scomponi il percorso usando marcature temporali proprie: generazione del codice, ingresso e attesa in coda, invio al provider e ricezione di uno stato segnalato. Registra anche il momento in cui l’applicazione riceve una risposta dal provider, se questo evento fa parte della tua integrazione.
Non tutte le piattaforme espongono gli stessi eventi e il tempo tra una fase e l’altra può includere elaborazione interna, attesa o latenza di comunicazione. Documenta cosa misura ogni intervallo e quali componenti restano esclusi. Evita di sommare durate sovrapposte o confrontare orologi non adeguatamente sincronizzati.
Un budget per fase è un obiettivo operativo che definisci tu, non un limite tecnico universale né una garanzia di consegna. Parti dai requisiti del prodotto e dai dati osservati in condizioni normali; ripartisci il tempo disponibile tra le fasi che puoi misurare e controllare. Rivedi l’allocazione quando cambiano l’architettura, l’integrazione o il comportamento osservato.
- Definisci gli eventi di inizio e fine per ogni intervallo.
- Individua il team o il componente che può intervenire su ciascuna fase.
- Registra i casi privi di marcature temporali complete come dati incompleti, invece di assegnare loro una durata inventata.
- Non usare un obiettivo interno come promessa all’utente o garanzia di consegna.
Scegliere percentili, volumi e finestre di osservazione
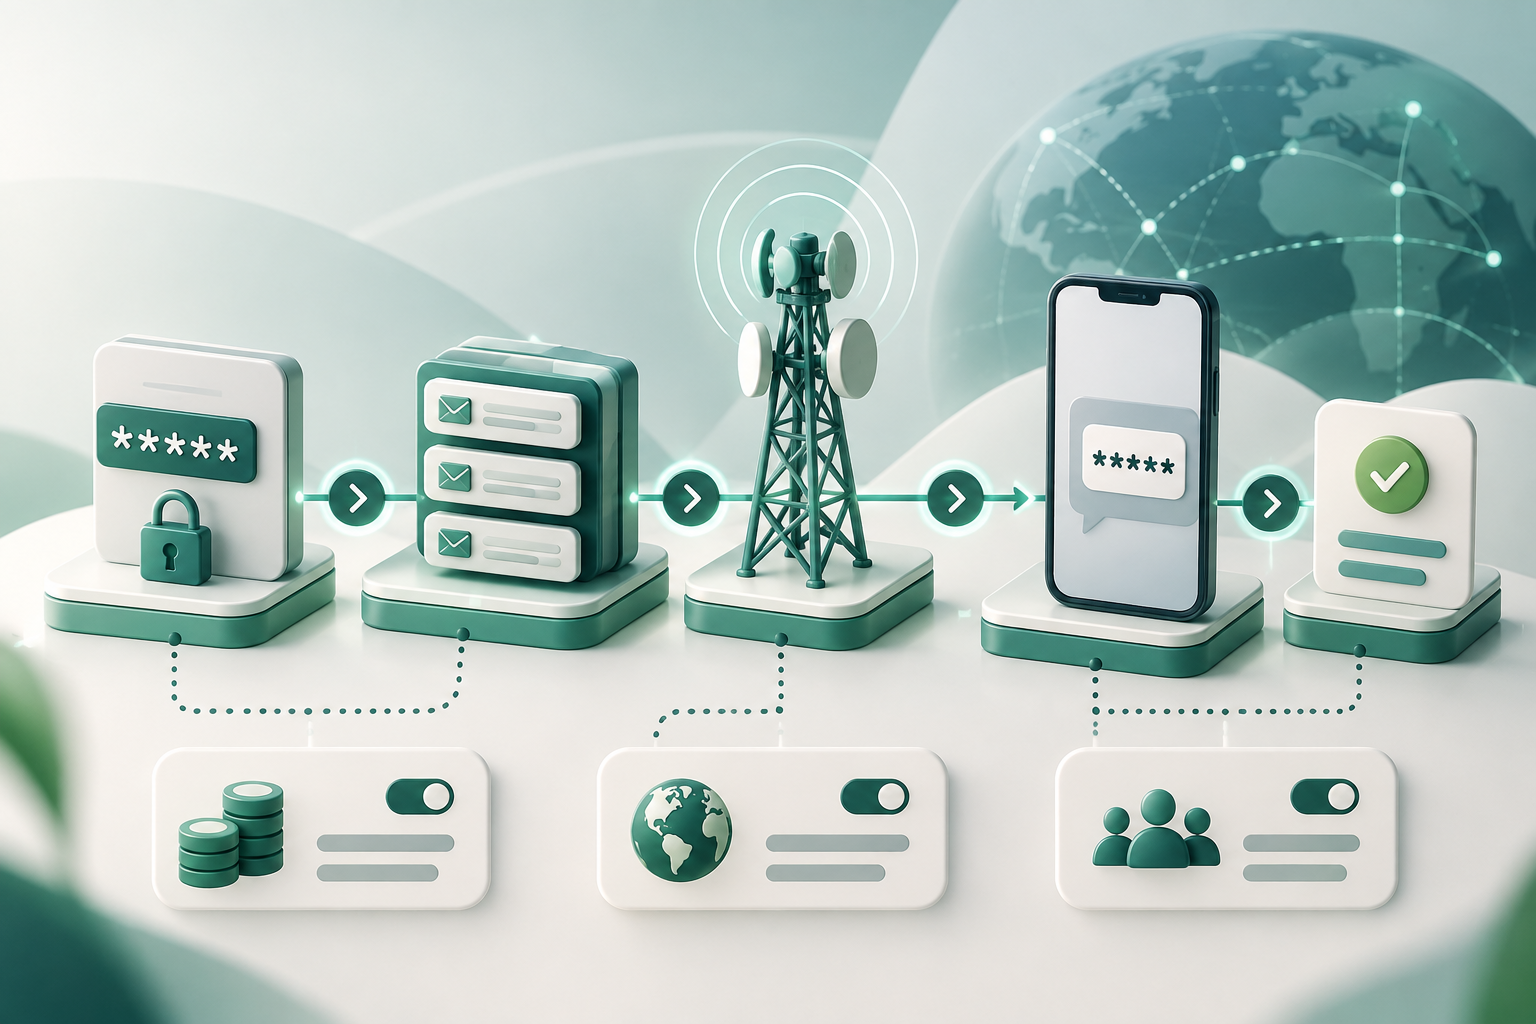
Scegli le metriche in base alla decisione che devono supportare. La mediana può mostrare il comportamento tipico; un percentile alto può segnalare un peggioramento nella coda lenta. Quando è utile, osserva entrambi insieme al volume e alla quota di eventi senza esito. Non presentare un valore come rappresentativo se le osservazioni sono poche.
La finestra di osservazione deve bilanciare rapidità e stabilità. Una finestra breve può reagire prima, ma anche amplificare variazioni casuali; una finestra lunga attenua le fluttuazioni, ma può richiedere più tempo per rivelare un cambiamento. La scelta dipende dal volume, dal ritmo del traffico e dal tempo a disposizione del team per intervenire; le evidenze disponibili non indicano una durata consigliata.
Se utilizzi soglie dinamiche, verifica come lo strumento apprende e si adatta prima di affidarti ai suoi avvisi. La documentazione di Microsoft su Azure Monitor indica che la specifica funzionalità delle soglie dinamiche utilizza dieci giorni di dati storici quando viene creata una regola. Questo comportamento riguarda esclusivamente quella funzionalità e non va considerato una regola generale per altri sistemi.
- Annota il percentile, la finestra, il volume minimo applicato e il trattamento dei dati incompleti.
- Verifica che una finestra contenga eventi sufficienti perché la metrica sia interpretabile nel tuo contesto.
- Valuta se il cambiamento è persistente e rilevante prima di trasformare una variazione breve in un incidente.
Distinguere la latenza di invio, la ricezione del DLR e la conferma dell’utente
Tieni separati i diversi eventi nelle tue metriche. La risposta a una richiesta di invio, uno stato successivo segnalato dalla catena e una conferma nell’applicazione sono eventi distinti. Misura ciascuno con una propria marcatura temporale e assegnagli un nome esplicito.
Un DLR è uno stato segnalato da un componente della catena di messaggistica. Il suo significato concreto dipende dall’implementazione e dallo stato comunicato. Da solo, non va presentato come prova indipendente che l’SMS sia comparso sul terminale o che la persona lo abbia letto.
Se l’utente inserisce il codice, questo evento può confermare che il flusso di autenticazione è proseguito, ma non equivale automaticamente a una misurazione pura della consegna: possono influire l’azione dell’utente e altri passaggi dell’applicazione. Mantieni separato l’indicatore tecnico dello stato segnalato dal risultato osservato nel prodotto.
- Etichetta separatamente l’invio accettato, lo stato segnalato e il completamento del flusso di autenticazione.
- Documenta il significato degli stati in base alla specifica integrazione; non generalizzare i codici tra implementazioni.
- Quando manca una conferma indipendente dal terminale, dichiara questa incertezza nei report.
Definire soglie per destinazione e contesto senza trasformarle in garanzie
Una soglia aggregata può nascondere differenze nel comportamento di una parte del traffico. Quando volume e dati lo consentono, confronta gruppi pertinenti, come destinazione o rotta, e mantieni una vista globale per rilevare impatti più ampi. Usa identificativi di destinazione coerenti e documentati; il piano di segmentazione deve adattarsi a ciò che il tuo sistema osserva realmente.
Una segmentazione eccessiva crea gruppi con pochi campioni e misurazioni instabili. Mantieni una categoria aggregata quando i dati non sono sufficienti per una conclusione prudente ed evita di attribuire una causa a un operatore o a una rotta solo perché una metrica è cambiata nello stesso momento.
Le soglie indicano quando approfondire uno scostamento rispetto a un obiettivo o a una baseline interna. Non dimostrano che un messaggio verrà consegnato entro una scadenza né che una rotta offrirà lo stesso risultato a ogni utente o sessione.
- Inizia con dimensioni che consentano un’azione operativa concreta.
- Considera il volume e la copertura dei dati per ogni confronto.
- Non pubblicare i risultati come benchmark di mercato se derivano da misurazioni interne o da campioni non confrontabili.
Progettare avvisi con persistenza, volume minimo e gravità
Un avviso utile combina una metrica, una condizione, una finestra e un volume sufficiente per poter essere interpretato. Scegli questi elementi in base ai dati del tuo servizio e al tempo di risposta operativo disponibile; non esistono valori universali verificati per definirli.
Per evitare notifiche dovute a variazioni isolate, puoi richiedere che la condizione persista o si ripeta in più valutazioni. Regola la persistenza in base all’impatto e al rischio di ritardare una risposta. Tieni separate le segnalazioni di degrado della latenza da quelle di assenza di stati segnalati o di errori di integrazione: richiedono diagnosi diverse.
Assegna la gravità in base all’impatto osservato e alla possibilità di intervenire, non solo alla distanza di una metrica dal suo riferimento. Un avviso di verifica può chiedere di esaminare un’anomalia; l’escalation va riservata alle condizioni che il team ha definito rilevanti per il servizio.
- Includi nell’avviso la fase, il percentile, la finestra, il volume e i gruppi interessati.
- Definisci chi deve svolgere l’indagine e quali evidenze verificare prima di procedere con l’escalation.
- Quando possibile, verifica il comportamento della regola con dati storici o simulati, senza presumere che il test garantisca prestazioni future.
Indagare un avviso: confrontare fasi, destinazioni e stati
Inizia verificando che il cambiamento non dipenda da una modifica alla strumentazione, agli orologi, al volume o ai criteri di inclusione. Poi confronta le durate delle singole fasi con il totale: se il ritardo si concentra in una fase, indirizza l’indagine verso i componenti che la controllano, senza considerare dimostrata una causa.
Confronta la vista globale con i gruppi per destinazione o rotta che dispongono di campioni interpretabili. Esamina separatamente gli stati segnalati e i casi senza stato, perché un ritardo nella ricezione di un DLR non dimostra di per sé che anche l’invio sia stato ritardato.
Registra l’intervallo interessato, i gruppi osservati, le modifiche recenti e i limiti dei dati. Se le evidenze non permettono di distinguere tra cause possibili, formula la conclusione come ipotesi da verificare.
- Verifica innanzitutto integrità, volume e coerenza delle marcature temporali.
- Individua l’intervallo in cui compare lo scostamento prima di attribuirgli una causa.
- Confronta i gruppi solo quando i dati sono sufficienti e comparabili.
- Distingui l’assenza di uno stato, la latenza dello stato e la latenza misurata in altre fasi.
Rivedere le soglie e documentare le incertezze
Le soglie vanno riviste quando cambiano il prodotto, la strumentazione, il modello di traffico o le condizioni operative. Conserva lo storico delle modifiche e spiega quali evidenze hanno motivato ciascun aggiornamento. Evita di modificare una regola soltanto per silenziare un avviso senza prima verificare se il segnale riveli un cambiamento reale.
Registra le esclusioni, gli eventi incompleti, le dimensioni con volume ridotto e i limiti di ciò che ogni stato può dimostrare. Queste informazioni aiutano a interpretare le tendenze con cautela ed evitano che una misura interna venga confusa con una garanzia esterna.
- Conserva la definizione della metrica, la regola in vigore, le relative esclusioni e la data della revisione.
- Rivaluta la soglia dopo cambiamenti rilevanti e verifica che il confronto resti valido.
- Specifica chiaramente cosa è un dato osservato, cosa è un obiettivo interno e quale incertezza permane.
Domande frequenti
Quale percentile devo usare per segnalare la latenza degli OTP via SMS?
Non esiste un percentile universale comprovato per tutti i servizi. Scegli la metrica in base all’esperienza che vuoi monitorare e verifica che sia stabile rispetto al volume disponibile. La mediana e un percentile alto possono offrire prospettive complementari.
Quanto deve durare la finestra di osservazione?
Dipende dal volume, dal modello di traffico e dal tempo di risposta richiesto dalla tua operatività. Una finestra breve reagisce prima, ma può essere più sensibile alle variazioni; una lunga attenua le fluttuazioni, ma può ritardare il rilevamento. Non esiste una durata universale verificata.
Un DLR conferma che l’OTP è arrivato al telefono?
Non da solo. Un DLR è uno stato segnalato dalla catena e il suo significato dipende dall’implementazione. Non equivale necessariamente a una verifica indipendente della ricezione sul terminale né conferma che l’utente abbia letto il messaggio.
È opportuno creare soglie diverse per destinazione o rotta?
Può essere utile se la segmentazione permette di indagare una differenza e ci sono abbastanza dati confrontabili. Se i gruppi sono piccoli, le metriche possono essere instabili: mantieni una vista aggregata ed esplicita l’incertezza.
Le soglie di avviso garantiscono la consegna dell’OTP?
No. Sono controlli operativi che segnalano scostamenti nelle metriche definite. Non garantiscono la consegna, la ricezione entro un tempo specifico né un risultato identico per ogni messaggio.
Fonti consultate
- Azure Monitor: umbrales dinámicosMicrosoft Learn
- Especificaciones 3GPP3GPP
- ITU-T E.164International Telecommunication Union
- NIST SP 800-63-4NIST
- OWASP Authentication Cheat SheetOWASP
- GSMA: redes y tecnologíasGSMA