Backpressure bei A2P-SMS: Warteschlangen für Spitzen, Limits und Störungen gestalten
Ein operativer Leitfaden, um die Annahme des A2P-SMS-Versands zu entkoppeln, Druck nach Ziel und Route zu begrenzen sowie Wartezeiten, Abläufe und Wiederholungsversuche zu steuern, ohne einen Vorfall zu verschärfen.
Was Backpressure bei A2P-SMS bedeutet
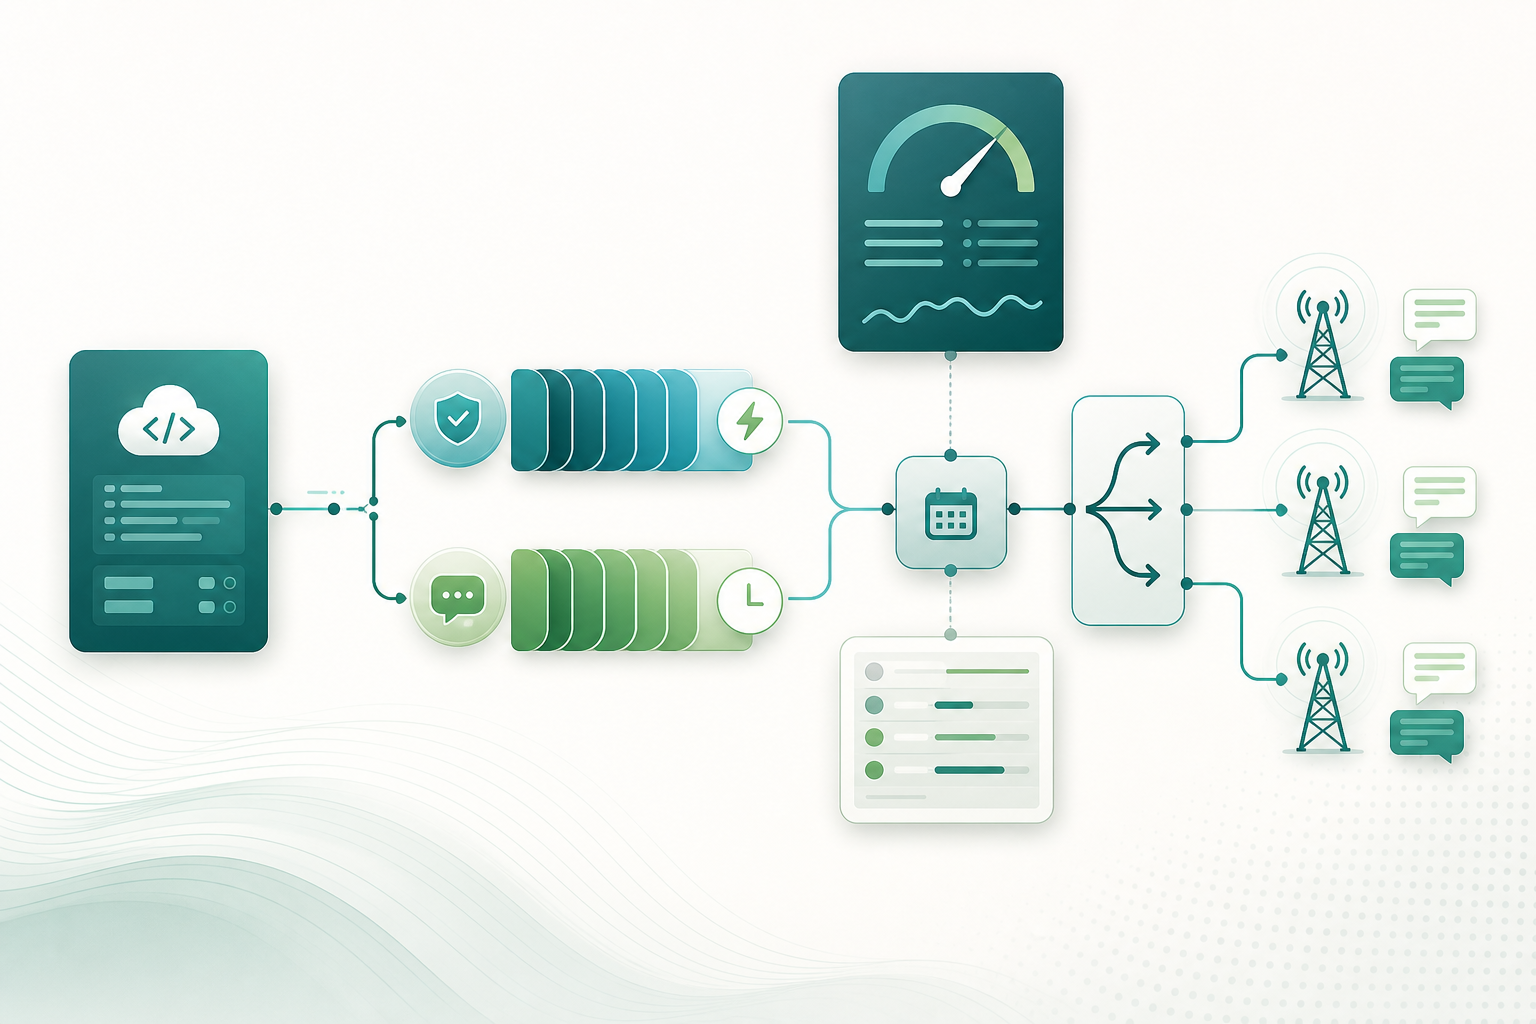
Backpressure bei A2P-SMS umfasst alle Kontrollen, die verhindern, dass eingehende Anfragen die tatsächliche Verarbeitungs- und Versandkapazität dauerhaft übersteigen. Das Ziel besteht nicht darin, möglichst viele Anfragen anzunehmen, sondern das sinnvolle Verhalten des Verkehrs bei Spitzenlasten, Ratenlimits, Überlastung oder einer Verschlechterung einer Route zu bewahren.
Eine positive API-Antwort belegt nicht, dass die Nachricht das Endgerät erreicht hat. In SMPP übergibt submit_sm eine Nachricht dem Message Center zur späteren Zustellung; die Anforderung eines Zustellberichts wird separat über registered_delivery konfiguriert. Ebenso kann eine Plattform eine Nachricht annehmen und in eine Warteschlange stellen, bevor sie sie an einen vorgelagerten Betreiber sendet.
Nimmt das System mehr Arbeit an, als es abarbeiten kann, steigen Tiefe und Alter der Warteschlange. Bei zeitkritischem Verkehr kann das schlechter sein als eine ausdrückliche Ablehnung: Ein OTP kann zu spät versendet werden, eine transaktionale Benachrichtigung kann ihren Nutzen verlieren und Wiederholungsversuche können Nachrichten vervielfachen oder die Überlastung verschärfen.
- Behandeln Sie die Annahme als Zulassungsstatus, nicht als Nachweis der Zustellung.
- Messen Sie die wirksame Ausgangskapazität je relevantem Bereich, nicht nur die Eingangskapazität der API.
- Üben Sie Druck nach oben aus, bevor angesammelte Arbeit die Nutzungsfrist der Nachricht überschreitet.
- Halten Sie interne Warteschlangenstatus von Statusmeldungen des Netzes oder Betreibers getrennt.
Annahme, Warteschlange, Planung und Statusbestätigung trennen
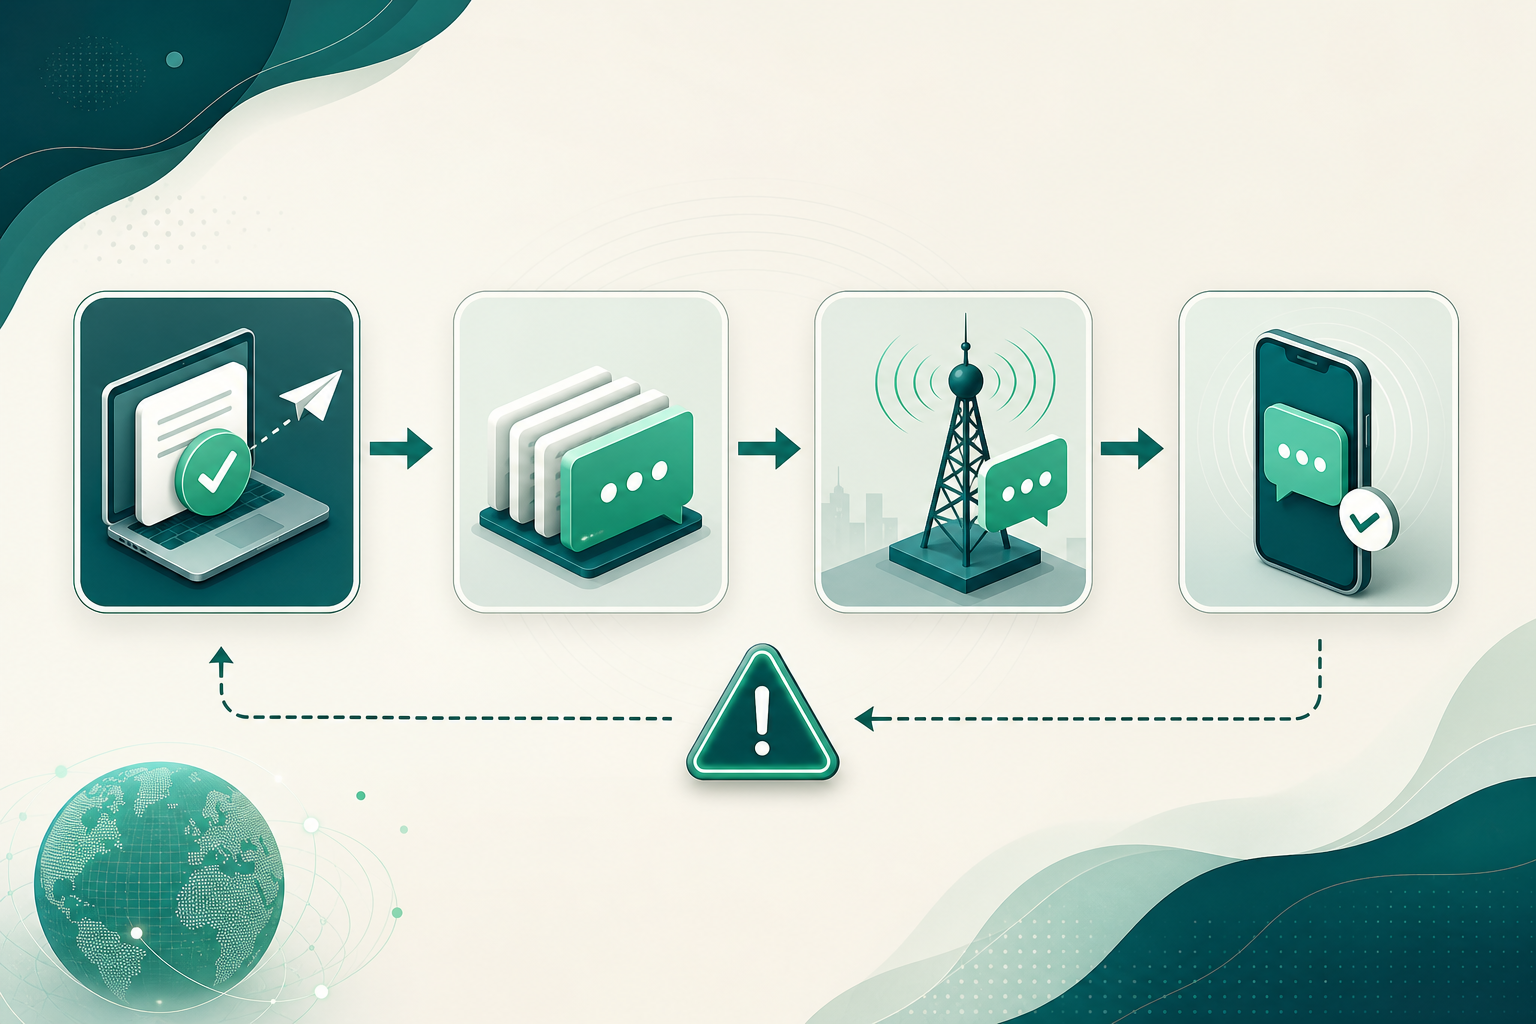
Ein betreibbares Design teilt den Lebenszyklus in Schichten mit unterschiedlichen Verantwortlichkeiten auf. Diese Trennung ermöglicht Entscheidungen darüber, wo Limits angewendet werden, und verhindert, dass ein Zustellproblem hinter einer scheinbar gesunden API verborgen bleibt.
Die Annahmeschicht validiert die Anfrage, prüft ihren Idempotenzschlüssel, wendet Quoten an und entscheidet, ob sie angenommen, zurückgestellt oder abgelehnt wird. Die Warteschlange bewahrt zugelassene Arbeit mit ausreichenden Metadaten auf, um sie zu priorisieren, Nachrichten ablaufen zu lassen und Duplikate zu vermeiden. Der Scheduler wählt anhand verfügbarer Kapazität aus, welche Nachricht gesendet werden kann. Die Statusschicht erfasst sowohl interne Übergänge als auch spätere Antworten und DLRs.
DLRs sollten nicht als primäres Signal für die Echtzeitsteuerung verwendet werden. Von Betreibern erzeugte Ereignisse können lange nach dem Versand eintreffen; die unmittelbare Gesundheit sollte daher vor allem auf Signalen aus Annahme, Warteschlange, Sitzung und Dispatch basieren.
- Annahme: Authentifizierung, Validierung, Klassifizierung, Deduplizierung und Entscheidung über Annahme oder Ablehnung.
- Warteschlange: Persistenz, Priorität, Erstellungszeitpunkt, Nutzungsfrist, Ziel, geplante Route und idempotente Kennung.
- Planung: Auswahl von Nachrichten unter hierarchischen Limits und beobachteter Kapazität.
- Bestätigung: Erfassung von Annahme, Einreihung, Sendeversuch, technischer Antwort, Ablauf und DLR, sofern vorhanden.
Druck erkennen, bevor die Warteschlange zum Vorfall wird
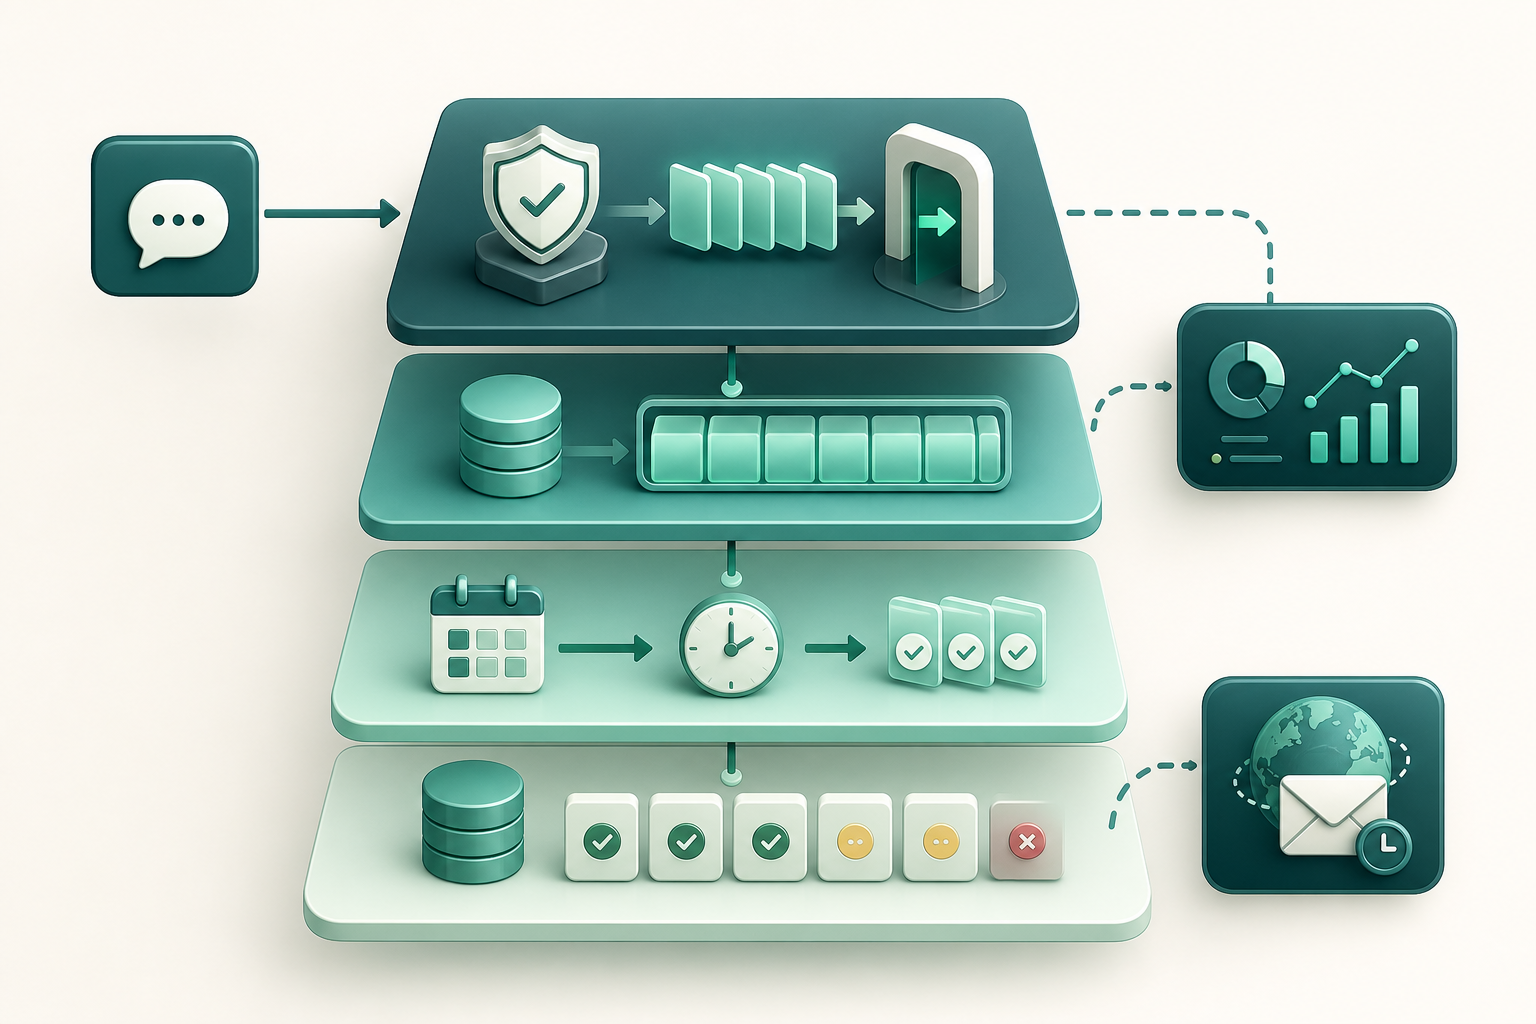
Der offensichtlichste Indikator ist eine wachsende Warteschlange, doch das reicht nicht aus. Eine Warteschlange kann stabil bleiben und dennoch inakzeptabel sein, wenn Nachrichten zu stark altern, ein Ziel den Großteil der Kapazität verbraucht oder Wiederholungsversuche neuen Verkehr verdrängen.
Definieren Sie Schwellenwerte je Verkehrsklasse und Steuerungsbereich. Ein sinnvoller Schwellenwert für OTP muss nicht für eine nicht dringende transaktionale Benachrichtigung gelten, und ein auf ein Ziel oder eine Route begrenztes Problem sollte nicht den gesamten Verkehr stoppen müssen.
Auch die Annahmelatenz verdient Überwachung. Wenn die API langsamer wird, sammelt sie möglicherweise Arbeit an, bevor sie antwortet, oder hängt von Komponenten ab, die bereits beeinträchtigt sind. Eine ausdrückliche, begrenzte Annahme ist wachsenden und unvorhersehbaren Antwortzeiten vorzuziehen.
- Gesamttiefe der Warteschlange sowie Tiefe je Konto, Anwendung, Ziel, Route, Sitzung und Verkehrsklasse.
- Maximales Alter und Altersperzentile noch nicht gesendeter Nachrichten.
- Annahmerate im Verhältnis zur wirksamen Dispatch-Rate.
- Temporäre Ablehnungen, Sitzungsfehler, Antwortzeiten und SMPP-Neuverbindungen.
- Anzahl intern abgelaufener, unterdrückter oder aufgrund einer Richtlinie abgelehnter Nachrichten.
- Anteil der Kapazität, der durch Wiederholungsversuche gegenüber Erstversuchen verbraucht wird.
Verkehr vor dem Einreihen klassifizieren
Die Priorität muss zugewiesen werden, bevor die Nachricht in eine gemeinsame Warteschlange gelangt. Es reicht nicht aus, alles als transaktional zu kennzeichnen: Manche Nachrichten haben eine strikte Frist, andere verlieren schrittweise an Nutzen und wieder andere können während einer Beeinträchtigung warten oder gar nicht gesendet werden.
Eine praktische Klassifizierung unterscheidet OTP, fristgebundenen transaktionalen Verkehr, einwilligungsbasiertes Marketing und nicht priorisierten Verkehr. AWS unterscheidet transaktionale, kritische oder zeitkritische Nachrichten von Werbenachrichten, die dies nicht sind. Diese Unterscheidung ist ein nützlicher Ausgangspunkt, doch jede Organisation sollte ihre eigenen legitimen Prioritäten, Verpflichtungen und Fristen dokumentieren.
Die Klassifizierung darf nicht zu einem Mechanismus werden, um Regeln für Route, Einwilligung oder Absender zu umgehen. Priorität ist eine interne Betriebsentscheidung, um begrenzte Kapazität im Einklang mit dem legitimen Zweck der Nachricht zu nutzen.
- OTP: Einmalcodes mit kurzer Nutzungsdauer; sie benötigen ein kurzes Wartebudget und einen strikten Ablauf.
- Fristgebundene Transaktionsnachrichten: Warnungen, Statusänderungen oder betriebliche Hinweise, die nach einer definierten Zeit an Wert verlieren.
- Einwilligungsbasiertes Marketing: Verkehr, der normalerweise zurückgestellt, begrenzt oder pausiert werden können muss, ohne einen kritischen Betrieb zu gefährden.
- Nicht prioritär: Verkehr mit geringer Dringlichkeit, der unter Druck zuerst reduziert oder abgelehnt werden sollte.
Wartebudgets und Abläufe definieren, ohne Status zu verwechseln
Jede Nachrichtenklasse benötigt ein Wartebudget: die maximale Zeit, die sie innerhalb der eigenen Plattform verbleiben darf, bevor ein Versandversuch keinen Sinn mehr ergibt. Dieses Budget sollte kleiner oder gleich der geschäftlichen Nutzungsfrist sein und anhand der verfügbaren Ausgangskapazität überprüft werden.
Der interne Ablauf ist eine Entscheidung Ihres Systems: beispielsweise ein OTP zu unterdrücken, das länger als erlaubt gewartet hat, bevor ihm eine Route zugewiesen wird. Er darf nicht als DLR des Betreibers kommuniziert werden. Führen Sie einen expliziten Status wie „intern abgelaufen“ oder einen gleichwertigen Status und bewahren Sie den Grund der Entscheidung auf.
Bei SMPP gibt validity_period den Ablaufzeitpunkt im SMSC an, nach dem die Nachricht verworfen werden muss, wenn sie nicht zugestellt wurde. Diese Gültigkeitsdauer unterscheidet sich sowohl von der vorherigen Wartezeit in der eigenen Warteschlange als auch von einer Zustellbestätigung am Endgerät. In Messaging-Diensten steuert die TTL, wie lange versucht wird, eine SMS zuzustellen, nicht die Garantie eines finalen DLR.
- Speichern Sie je Nachricht: Erstellungszeitpunkt, interne Frist, angeforderte Gültigkeitsdauer und Ablaufgrund, falls ein Ablauf eintritt.
- Planen Sie keinen Versand für Nachrichten, deren internes Budget bereits aufgebraucht ist.
- Weisen Sie getrennt aus: vor dem Versand abgelaufen, während des Zustellversuchs abgelaufen und DLR erhalten, sofern zutreffend.
- Interpretieren Sie weder einen Ablauf noch einen Annahmestatus als Bestätigung des Empfangs am Endgerät.
Hierarchische Limits anwenden und Bursts steuern
Kapazität ist keine einzelne Kennzahl. Ein System kann über ausreichend aggregierte Kapazität verfügen und dennoch für ein Konto, eine Anwendung, ein Ziel, eine Route, eine SMPP-Sitzung oder einen Anbieter begrenzt sein. Limits müssen kombinierbar sein: Eine Nachricht wird nur gesendet, wenn in allen zutreffenden Bereichen Budget verfügbar ist.
Ein Token-Bucket-Modell eignet sich, um eine nachhaltige Rate durchzusetzen und den Burst nach einer Ansammlung zu begrenzen. Die Rate begrenzt den kontinuierlichen Dispatch; die Burst-Größe begrenzt, wie schnell eine aufgestaute Warteschlange geleert werden kann. Dadurch wird verhindert, dass die Erholung nach einer kurzen Unterbrechung erneut Überlastung verursacht.
Wenden Sie dasselbe Dispatch-Limit auf Erstversuche und Wiederholungsversuche an. Wenn Wiederholungsversuche außer Kontrolle geraten, verbrauchen sie Kapazität, die für neuen oder priorisierten Verkehr reserviert sein sollte.
- Limit je Konto, Kampagne oder Anwendung zum Schutz von Quoten und zur Mandantentrennung.
- Limit je Ziel, damit eine Nummerierung, ein Netz oder ein Land keine gemeinsam genutzte Kapazität absorbiert.
- Limit je Route und Anbieter zur Einhaltung der jeweils geltenden Kapazität oder Einschränkung.
- Limit je SMPP-Sitzung, um eine Verbindung oder ihr Betriebsfenster nicht zu überlasten.
- Reservierung oder Gewichtung je Verkehrsklasse zum Schutz von OTP und anderen fristgebundenen Flüssen.
- Burst-Steuerung zur schrittweisen Erholung nach einer Pause oder Beeinträchtigung.
Eine explizite Annahmestrategie wählen
Wenn nicht genügend Kapazität vorhanden ist, gibt es vier legitime Ergebnisse: annehmen, zurückstellen, ablehnen oder den Absender zur Reduzierung seines Tempos auffordern. Die Wahl sollte von der Nutzungsfrist, der dokumentierten Priorität, der Möglichkeit eines sicheren Wiederholungsversuchs und davon abhängen, ob der Kapazitätsmangel global oder lokal begrenzt ist.
Annehmen bedeutet, dass die Nachricht innerhalb eines realistischen Wartebudgets in die Warteschlange gelangt. Zurückstellen bedeutet, sie für ein späteres Zeitfenster aufzubewahren, jedoch nur, wenn sie dann noch nützlich sein wird. Ablehnen ist angemessen, wenn keine realistische Möglichkeit besteht, die Frist einzuhalten, oder wenn die Richtlinie keine weitere Ansammlung von Arbeit erlaubt. Eine Reduzierung des Tempos anzufordern ist besonders bei Integrationen nützlich, die ihre Produktion anpassen können.
Bei HTTP kann eine temporäre Überlastung mit 503 und Retry-After kommuniziert werden. Es ist besser, wenn der Client ein explizites und umsetzbares Signal erhält, statt Anfragen unbegrenzt anzunehmen, die wahrscheinlich ablaufen werden. Damit diese Integration sicher ist, dokumentieren Sie die Semantik von Wiederholungsversuchen und Idempotenzschlüsseln klar.
- Nehmen Sie nur an, wenn Warteschlange und Kapazität darauf hindeuten, dass die Nachricht innerhalb ihres Budgets gesendet werden kann.
- Stellen Sie warteverträglichen Verkehr zurück, mit einer Frist, die einen verspäteten Versand verhindert.
- Lehnen Sie OTP oder Nachrichten mit abgelaufener oder nicht einhaltbarer Frist ab, mit einem maschinen- und betriebslesbaren Grund.
- Geben Sie einen Hinweis zur vorübergehenden Reduzierung des Tempos zurück, wenn die Schnittstelle dies ermöglicht.
- Verwandeln Sie eine Annahmeablehnung nicht in eine stille Annahme, die in einer unbegrenzten Warteschlange endet.
Die Warteschlange mit Fairness und dokumentierten Prioritäten planen
Die Planung muss verhindern, dass ein einzelner Kunde, eine Kampagne oder ein Ziel die gesamte verfügbare Kapazität verbraucht. Gleichzeitig darf sie legitime geschäftliche Prioritäten nicht intransparent verändern, etwa den Schutz von OTP gegenüber einwilligungsbasiertem Marketing während einer Einschränkung.
Eine sinnvolle Kombination besteht darin, Warteschlangen je Verkehrsklasse einzusetzen und Limits je Mandant, Ziel und Route anzuwenden, bevor die nächste Nachricht ausgewählt wird. Innerhalb derselben Klasse kann eine faire Verteilung verhindern, dass eine sehr aktive Quelle den Dispatch monopolisiert.
Die strikte Reihenfolge des Eingangs ist nicht immer die richtige Reihenfolge. Bei Fristen kann es vorzuziehen sein, innerhalb einer Klasse Nachrichten zu priorisieren, die kurz vor dem Ablauf stehen, sofern die Richtlinie eine Aushungerung anderer Nachrichten verhindert. Jede Ausnahme sollte explizit, auditierbar und mit dem Zweck des Verkehrs vereinbar sein.
- Vermeiden Sie eine einzige globale Warteschlange ohne Metadaten zu Priorität, Ziel und Frist.
- Isolieren Sie beeinträchtigte Ziele oder Routen, damit sie gesunden Verkehr nicht blockieren.
- Nutzen Sie Quoten oder faire Verteilung innerhalb gleichwertiger Kategorien.
- Schützen Sie dokumentierte Prioritäten, ohne nicht dringenden Verkehr unangemessen als kritisch zu kennzeichnen.
- Prüfen Sie regelmäßig, ob Nachrichten niemals einen Dispatch-Slot erhalten.
Häufige Fragen
Bedeutet die Annahme einer SMS per API, dass sie bereits zugestellt wurde?
Nein. Die Annahme zeigt an, dass die Anfrage zugelassen oder in die Warteschlange eingereiht wurde. In SMPP übergibt submit_sm die Nachricht zur späteren Zustellung. Zustellung und Zustellberichte sind getrennte Schritte, und ein DLR darf, wenn er eingeht, ebenfalls nicht mit einer universellen und unmittelbaren Garantie verwechselt werden.
Wann sollte ein OTP abgelehnt statt in die Warteschlange gestellt werden?
Es sollte ausdrücklich abgelehnt werden, wenn verfügbare Kapazität und Alter der Warteschlange zeigen, dass es nicht innerhalb seiner Nutzungsfrist gesendet werden kann. Ein verspätet gesendetes OTP kann weniger nützlich sein, als den Absender zu informieren, damit er seinen Wiederherstellungsprozess nutzt oder einen neuen Code erzeugt.
Sollten Wiederholungsversuche ein separates Ratenlimit haben?
Sie sollten derselben Dispatch-Steuerung wie Erstversuche unterliegen und zusätzlich eine Begrenzung der Anzahl von Versuchen und der Zeit haben. Werden sie vom Limit ausgenommen, können sie verfügbare Kapazität verbrauchen und eine Überlastung verlängern.
Ersetzt ein SMPP-validity_period einen internen Ablauf?
Nein. validity_period definiert den Ablauf im SMSC, nach dem die Nachricht verworfen werden muss, wenn sie nicht zugestellt wurde. Die Plattform benötigt weiterhin ein internes Wartebudget, um zu verhindern, dass nutzlose Nachrichten zu spät beim SMSC eintreffen.
Sollten DLRs verwendet werden, um eine Beeinträchtigung in Echtzeit zu erkennen?
Nicht als einziges Signal. Ereignisse von Betreibern können mit erheblicher Verzögerung eintreffen. Für die unmittelbare Betriebssteuerung sollten Sie Annahme, Tiefe und Alter der Warteschlange, Dispatch, technische Fehler, Sitzungsgesundheit sowie Verhalten je Ziel oder Route überwachen.
Wie werden Duplikate vermieden, wenn der Client eine HTTP-Anfrage wiederholt?
Verwenden Sie einen persistenten Idempotenzschlüssel oder einen gleichwertigen Mechanismus, der eine bereits angewendete Anfrage erkennen kann. Automatische Wiederholungen nicht idempotenter Vorgänge sind unsicher, wenn der Absender nicht erkennen kann, ob die ursprüngliche Anfrage verarbeitet wurde.
Verwendete Quellen
- SMPP Protocol Specification v3.4, Issue 1.2SMPP Developers Forum
- RFC 9110: HTTP SemanticsIETF
- Cloud Tasks: Configure queue routing, limits, and retriesGoogle Cloud
- Cloud Tasks v2 API reference: RateLimitsGoogle Cloud
- AWS End User Messaging SMS: How SMS worksAmazon Web Services
- AWS End User Messaging SMS: Event types for SMS, MMS, and voiceAmazon Web Services
- AWS End User Messaging SMS: Example of sending an SMS or voice messageAmazon Web Services
- Messages resourceTwilio
- Outbound Message Status in Status CallbacksTwilio
- 30036: Validity Period ExpiredTwilio
- 30001: Queue overflowTwilio