Tag del traffico A2P SMS: come progettare una tassonomia utile per analizzare qualità, costi e incidenti
Una tassonomia di tag per A2P SMS consente di separare l'intento di invio dai risultati osservati, confrontare i segmenti in modo coerente e proteggere i dati personali nelle operazioni.
Perché gli stati di consegna non bastano
Gli stati di consegna rappresentano una parte rilevante dell'evidenza operativa, ma da soli non descrivono il contesto di un invio. Negli SMS, i report di stato, i tentativi di trasferimento, determinate cause di errore e i nuovi tentativi legati alla disponibilità del terminale fanno parte di un ciclo tecnico con diversi possibili esiti.
Lo stesso stato aggregato può avere implicazioni operative diverse a seconda del caso d'uso, della criticità, del paese di destinazione, del tipo di mittente, della politica di instradamento applicata o della versione del contenuto. Senza queste dimensioni, una variazione nell'accettazione, nei DLR o nella latenza può essere visibile, ma difficile da attribuire e investigare.
Una tassonomia di tag A2P SMS fornisce questo contesto in modo strutturato. Il suo obiettivo non è sostituire gli eventi tecnici né gli identificatori di correlazione, ma consentirne la segmentazione attraverso categorie stabili, comparabili e verificabili.
- Separare il traffico OTP, gli avvisi transazionali e le campagne basate sul consenso.
- Distinguere i messaggi critici da quelli non critici per dare priorità alla risposta operativa.
- Confrontare i risultati per paese o territorio, politica logica di instradamento e versione del modello.
- Evitare che un calo aggregato o un apparente miglioramento nascondano comportamenti divergenti tra segmenti.
Principio di progettazione: identità tecnica, classificazione operativa e dati personali sono livelli distinti
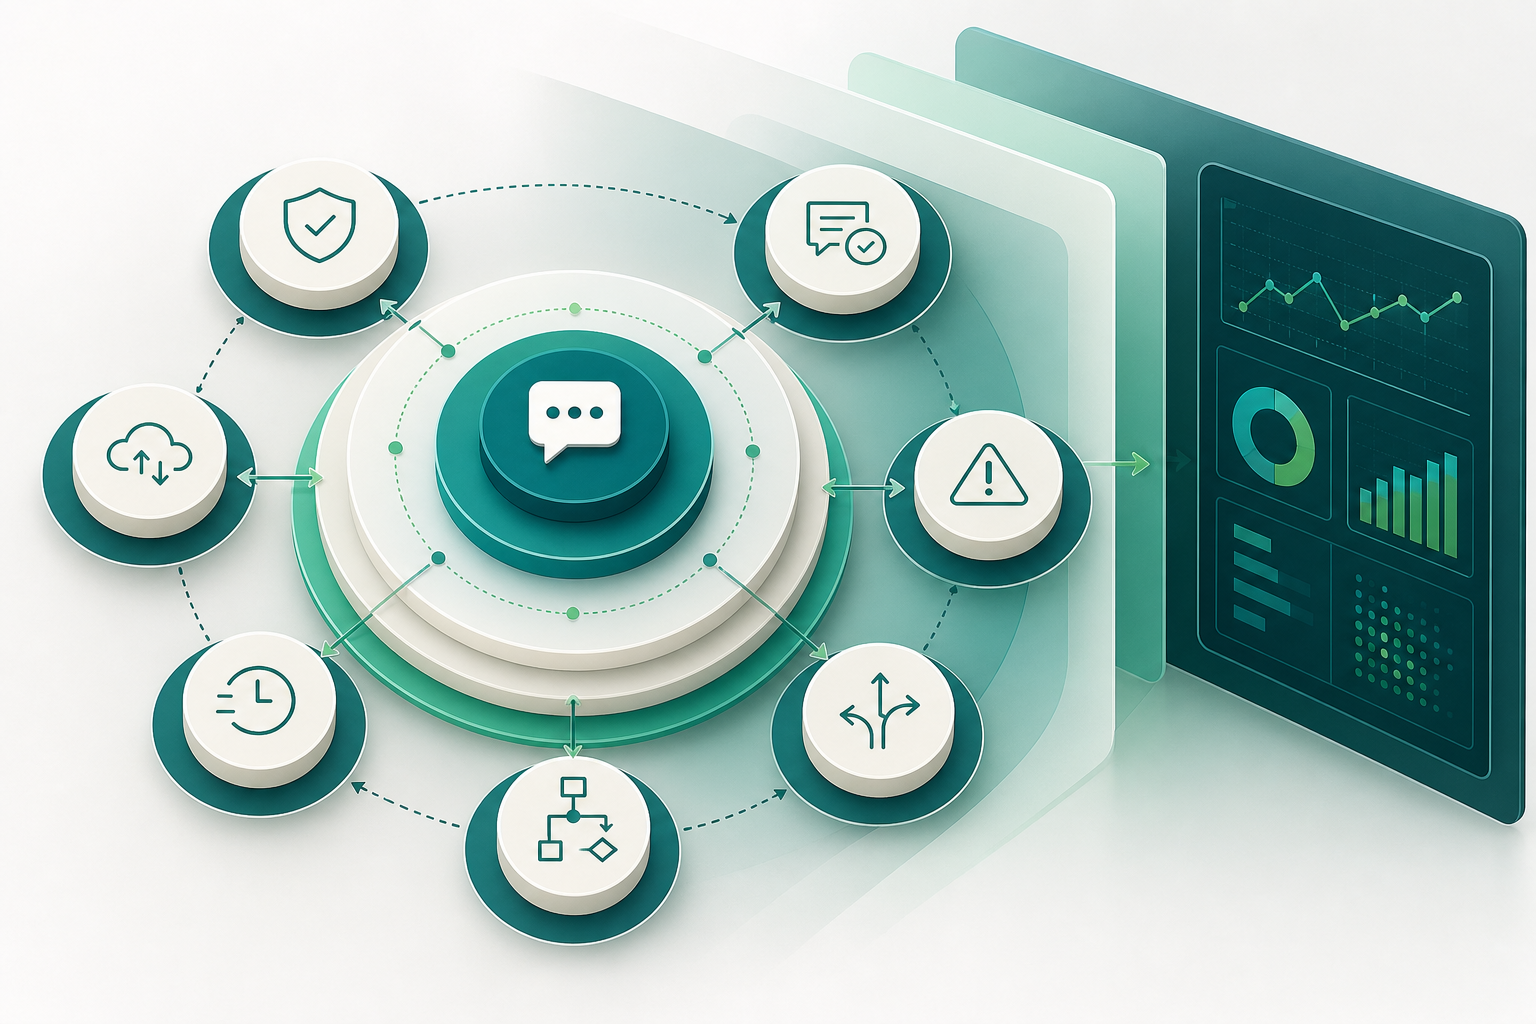
Il primo principio consiste nel separare tre categorie spesso confuse: l'identità tecnica per correlare gli eventi, la classificazione operativa per analizzare il traffico e i dati personali o contenuti sensibili da minimizzare.
L'architettura SMS utilizza identificatori e report per associare messaggi ed eventi tecnici. Questi identificatori sono utili per ricostruire una sequenza specifica, ma non devono diventare la tassonomia analitica. Allo stesso modo, le categorie di business non fanno necessariamente parte degli identificatori di rete e devono essere gestite come metadati propri della piattaforma.
La classificazione operativa deve rispondere a domande ripetibili: cosa si intendeva inviare, secondo quale politica si è deciso di inviarlo e in quale segmento debba essere confrontato. I dati personali, invece, non devono essere introdotti nei tag per comodità analitica.
- Identità tecnica: identificatore interno del messaggio, identificatore di correlazione e riferimenti agli eventi protetti.
- Classificazione preventiva: caso d'uso, criticità, paese di destinazione, tipo di mittente, canale di origine, campagna, percorso logico e versione del modello.
- Risultato osservato: accettazione, stato o DLR, causa di errore, timestamp e latenza calcolata.
- Dati da evitare: MSISDN completo, testo dell'SMS, OTP, nome della persona, indirizzo e identificatori di account riconoscibili.
Campi minimi di una tassonomia operativa
L'insieme esatto dipende dal modello operativo, ma una tassonomia minima deve offrire capacità di segmentazione senza creare una combinatoria ingestibile. Ogni campo deve avere una finalità analitica concreta, una fonte definita e valori controllati.
È opportuno conservare i tag di classificazione insieme al record di invio e archiviare i risultati osservati come eventi separati o come campi di stato con timestamp. Questa separazione evita che un'osservazione successiva riscriva l'intento o la decisione originaria.
Uno schema pratico può utilizzare nomi tecnici stabili, preferibilmente indipendenti dalla lingua delle dashboard. Ad esempio, use_case o logical_route possono essere mantenuti come chiavi di sistema, mentre le relative descrizioni sono mostrate tradotte agli utenti interni.
- use_case: finalità operativa, come otp, transactional_alert o consented_marketing.
- criticality: priorità di business o operativa, ad esempio critical, high, standard o low.
- destination_country: paese o territorio derivato dalla struttura della numerazione internazionale; non il numero completo. Non permette necessariamente di inferire in modo affidabile la posizione fisica, l'operatore o la residenza del destinatario.
- sender_type: classificazione del mittente usata nelle operazioni, come alphanumeric, long_number, short_code o altro valore applicabile all'ambiente.
- origin_channel: sistema o canale che ha originato l'invio, ad esempio api, smpp, portal o system_event.
- campaign_class: classe di raggruppamento operativo, come lifecycle, service_notice o consented_promotion; non un nome libero contenente informazioni sui clienti.
- logical_route: profilo, politica o decisione logica di instradamento sotto il controllo delle operazioni.
- capacity_source_ref: riferimento interno pseudonimizzato alla capacità o all'entità selezionata logicamente. Non prova il percorso fisico effettivo, l'operatore finale, la proprietà dell'infrastruttura, la qualità garantita o la copertura in una destinazione. Deve avere uno scopo documentato, valori stabili e accesso limitato ai team autorizzati; le modifiche devono essere tracciate con data di efficacia.
Distinguere le decisioni preventive dai risultati osservati
Un tag relativo a una decisione preventiva descrive il contesto disponibile prima della trasmissione del messaggio. Ad esempio, use_case=otp, criticality=critical, logical_route=priority_policy e template_version=otp_v3 indicano come l'invio è stato classificato o trattato al momento della creazione.
Un risultato osservato viene generato dopo: acceptance_state, DLR o stato riportato, failure_class e timestamp. Non è opportuno registrare un risultato come se fosse una caratteristica permanente del messaggio, né utilizzare un tag preventivo per presumere un risultato successivo.
Questa distinzione è decisiva nell'investigazione. Se un segmento mostra cambiamenti negli stati di consegna, deve essere possibile verificare se sono cambiati la politica di instradamento, la versione del modello, la composizione delle destinazioni o del traffico prima di attribuire il cambiamento a una sola causa.
- Prima dell'invio: use_case, criticality, destination_country, sender_type, origin_channel, campaign_class, logical_route, capacity_source_ref, template_version e taxonomy_version.
- Dopo l'invio: acceptance_state, delivery_state o DLR, failure_class, event_timestamp e timestamp necessari per calcolare la latenza.
- Derivato analiticamente: finestre di latenza, rapporti per segmento e classificazione dei risultati incerti.
- Non riscrivere la classificazione originale con informazioni acquisite dopo l'invio; aggiungere eventi o campi osservati con la relativa data.
Valori controllati, nomi stabili e gerarchie utili
Un tag è utile soltanto se lo stesso valore mantiene lo stesso significato nel tempo. Valori liberi, abbreviazioni incoerenti e modifiche alla definizione senza storico riducono la capacità di confrontare i periodi e indeboliscono l'evidenza durante un incidente.
Definire un dizionario per ciascun campo: finalità, proprietario, valori consentiti, significato, fonte, data di introduzione, data di ritiro e regole di transizione. La nomenclatura deve essere leggibile sia dalle macchine sia dalle persone, ma non dipendere da nomi temporanei, campagne specifiche o accordi commerciali variabili.
Le gerarchie aiutano a mantenere il dettaglio senza sacrificare la comparabilità. Ad esempio, use_case può avere una famiglia di primo livello e un sottotipo controllato. Se il dettaglio non modifica una decisione analitica, non merita una nuova dimensione.
- Utilizzare valori in un formato coerente, come lettere minuscole e separatori stabili: transactional_alert o consented_marketing.
- Evitare sinonimi paralleli: non mescolare otp, one_time_password e verification_code per lo stesso significato.
- Conservare un valore unknown o unclassified solo quando esiste una politica chiara per investigarlo e ridurlo.
- Aggiungere nuovi valori tramite una richiesta documentata; non riutilizzare un valore ritirato con un significato diverso.
- Versionare lo schema con taxonomy_version per interpretare correttamente i dati storici.
Esempio di schema per OTP, avvisi e campagne basate sul consenso
L'esempio seguente mostra una classificazione orientata alle operazioni. Non intende definire categorie universali né sostituisce requisiti normativi, contrattuali o di consenso applicabili a ogni organizzazione e destinazione.
Il punto chiave è che i tag riflettano fatti di configurazione o classificazione noti al mittente, non supposizioni sul destinatario né affermazioni non verificate sulla rete.
- OTP: use_case=otp; criticality=critical; campaign_class=authentication; template_version=otp_v3; origin_channel=api.
- Avviso transazionale: use_case=transactional_alert; criticality=high; campaign_class=service_notice; template_version=alert_v2; origin_channel=system_event.
- Campagna basata sul consenso: use_case=marketing; criticality=standard; campaign_class=consented_promotion; template_version=promo_v5; origin_channel=portal o api.
- In tutti i casi: destination_country con valore normalizzato, sender_type applicabile, logical_route secondo la politica selezionata, capacity_source_ref secondo il riferimento interno e taxonomy_version conforme allo schema vigente.
Come analizzare accettazione, DLR, latenza e risultati incerti
I tag consentono di segmentare le metriche, ma non cambiano il significato dell'evidenza. Un'accettazione può indicare che una piattaforma o un segmento ha ammesso una richiesta; un DLR di rete rappresenta un report all'interno del ciclo tecnico di trasferimento SMS. Uno stato riportato da un fornitore deve essere interpretato secondo la relativa definizione, e non equivale necessariamente a un DLR di rete. Né uno stato riportato né un DLR dimostrano, da soli, lettura umana, conversione o azione del destinatario. La ricezione sul terminale verificata in modo indipendente è un'evidenza distinta.
Per l'analisi, confrontare sempre segmenti omogenei. Un calo dei DLR per OTP a criticità critica verso un paese specifico e sotto lo stesso percorso logico è più investigabile di una media globale che mescola campagne, destinazioni, tipi di mittente e politiche differenti.
La latenza richiede una definizione esplicita. Documentare quali timestamp vengono sottratti, in quale fuso orario vengono normalizzati, quali eventi sono idonei e come vengono trattati i messaggi privi di un evento successivo nella finestra definita. I risultati senza DLR o con informazioni incomplete devono rimanere incerti, non essere riclassificati automaticamente come consegna o errore definitivo.
- Analizzare acceptance_state per use_case, destination_country, logical_route e sender_type.
- Analizzare DLR o delivery_state per coorti con lo stesso modello, versione e periodo.
- Calcolare la latenza solo quando i timestamp necessari sono comparabili e presenti.
- Separare failure_class dagli stati sconosciuti o in sospeso.
- Conservare denominatori, finestra di osservazione e versione della tassonomia in ogni report.
Segmentazione degli incidenti con evidenza riproducibile
Una tassonomia ben progettata trasforma un incidente generico in una sequenza di domande verificabili. Invece di chiedere soltanto perché i risultati siano diminuiti, il team può isolare quando è iniziato il cambiamento, quali popolazioni sono state interessate e quali configurazioni condividevano.
La segmentazione non dimostra da sola la causalità. Riduce però lo spazio d'indagine, permette di confrontare ipotesi con eventi, modifiche documentate e dati di configurazione e aiuta a evitare attribuzioni basate su medie troppo ampie.
L'evidenza deve conservare il periodo di analisi, i filtri applicati, la versione dello schema, le definizioni delle metriche e la fonte di ciascun evento. In questo modo, un altro team può ripetere la query e valutare la stessa conclusione.
- Il cambiamento riguarda solo un paese o territorio, oppure più paesi o territori?
- Si concentra in un caso d'uso, una criticità o una classe di campagna?
- Coincide con una modifica di logical_route, capacity_source_ref o template_version?
- È una variazione dell'accettazione, dei DLR, della latenza o della proporzione di risultati incerti?
- La composizione del traffico è cambiata, alterando il confronto rispetto al periodo precedente?
- È presente una causa di errore predominante documentata negli eventi disponibili?
Domande frequenti
Che cos'è una tassonomia di tag A2P SMS?
È un insieme documentato di campi e valori controllati che classifica gli invii A2P SMS per analizzarli in modo coerente. Può includere caso d'uso, criticità, paese o territorio di destinazione, canale di origine, percorso logico e versione del modello, tra altri dati operativi.
Un DLR positivo dimostra che il destinatario ha letto l'SMS?
No. Un DLR di rete è un report o stato all'interno dell'architettura di trasferimento SMS. Anche uno stato riportato da un fornitore deve essere interpretato secondo la sua definizione. Nessuno dei due dimostra, da solo, lettura umana, interazione, conversione o altri risultati commerciali successivi; la ricezione sul terminale verificata in modo indipendente è un'evidenza distinta.
Devo includere il numero di telefono nei tag?
No, non come tag analitico. Un MSISDN completo può costituire un dato personale quando consente di identificare o rendere identificabile una persona e deve essere trattato secondo la normativa applicabile. Non deve essere duplicato nei tag, nei nomi delle campagne o nei log ad ampio accesso. Quando è necessaria la correlazione, utilizzare identificatori interni protetti e controlli di accesso adeguati alla finalità.
Qual è la differenza tra un percorso logico e un percorso fisico?
Il percorso logico rappresenta una decisione sotto il controllo delle operazioni, come un profilo o una politica di selezione. Non deve essere usato per affermare un percorso fisico specifico né un operatore finale quando tali informazioni non sono osservate o verificabili.
Come si evita che la tassonomia si deteriori nel tempo?
Assegnare un proprietario, mantenere un dizionario dati, controllare i valori consentiti, versionare lo schema, registrare le modifiche e ritirare i valori obsoleti senza riutilizzarli con un significato diverso.
Quanti tag deve avere un invio?
Quelli sufficienti per supportare decisioni operative rilevanti, ma non così tanti da frammentare il traffico in segmenti senza volume o da generare una combinazione impossibile da mantenere. Iniziare dai campi che spiegano differenze di utilizzo, priorità, destinazione, origine, decisione logica e versione del contenuto.
Fonti consultate
- 3GPP TS 23.040 — realización técnica del SMS (Release 16)ETSI / 3GPP
- Portal de especificaciones 3GPP — TS 23.0403GPP
- Recomendación E.164 — plan internacional de numeración públicaInternational Telecommunication Union
- NIST SP 800-92 — Guide to Computer Security Log ManagementNational Institute of Standards and Technology
- NIST SP 800-92 Rev. 1 — Cybersecurity Log Management Planning Guide (borrador público)National Institute of Standards and Technology
- Data minimisationInformation Commissioner's Office
- System and network security — evaluación de la información registrada en logsInformation Commissioner's Office