Etiquetas de tráfico A2P SMS: cómo diseñar una taxonomía útil para analizar calidad, costes e incidencias
Una taxonomía de etiquetas A2P SMS permite separar la intención de envío de los resultados observados, comparar segmentos de forma consistente y proteger los datos personales en la operación.
Por qué los estados de entrega no bastan
Los estados de entrega son una parte relevante de la evidencia operativa, pero no describen por sí solos el contexto de un envío. En SMS, los reportes de estado, los intentos de transferencia, determinadas causas de error y los reintentos relacionados con la disponibilidad del terminal forman parte de un ciclo técnico con varios resultados posibles.
Un mismo estado agregado puede tener implicaciones operativas distintas según el caso de uso, la criticidad, el país de destino, el tipo de remitente, la política de enrutamiento aplicada o la versión del contenido. Sin esas dimensiones, una variación en aceptación, DLR o latencia puede ser visible, pero difícil de atribuir y de investigar.
Una taxonomía de etiquetas A2P SMS aporta ese contexto de forma estructurada. Su objetivo no es sustituir los eventos técnicos ni los identificadores de correlación, sino permitir segmentarlos con categorías estables, comparables y auditables.
- Separar tráfico OTP, alertas transaccionales y campañas consentidas.
- Distinguir los mensajes críticos de los no críticos para priorizar la respuesta operativa.
- Comparar resultados por país o territorio, política lógica de enrutamiento y versión de plantilla.
- Evitar que una caída agregada o una mejora aparente oculten comportamientos divergentes entre segmentos.
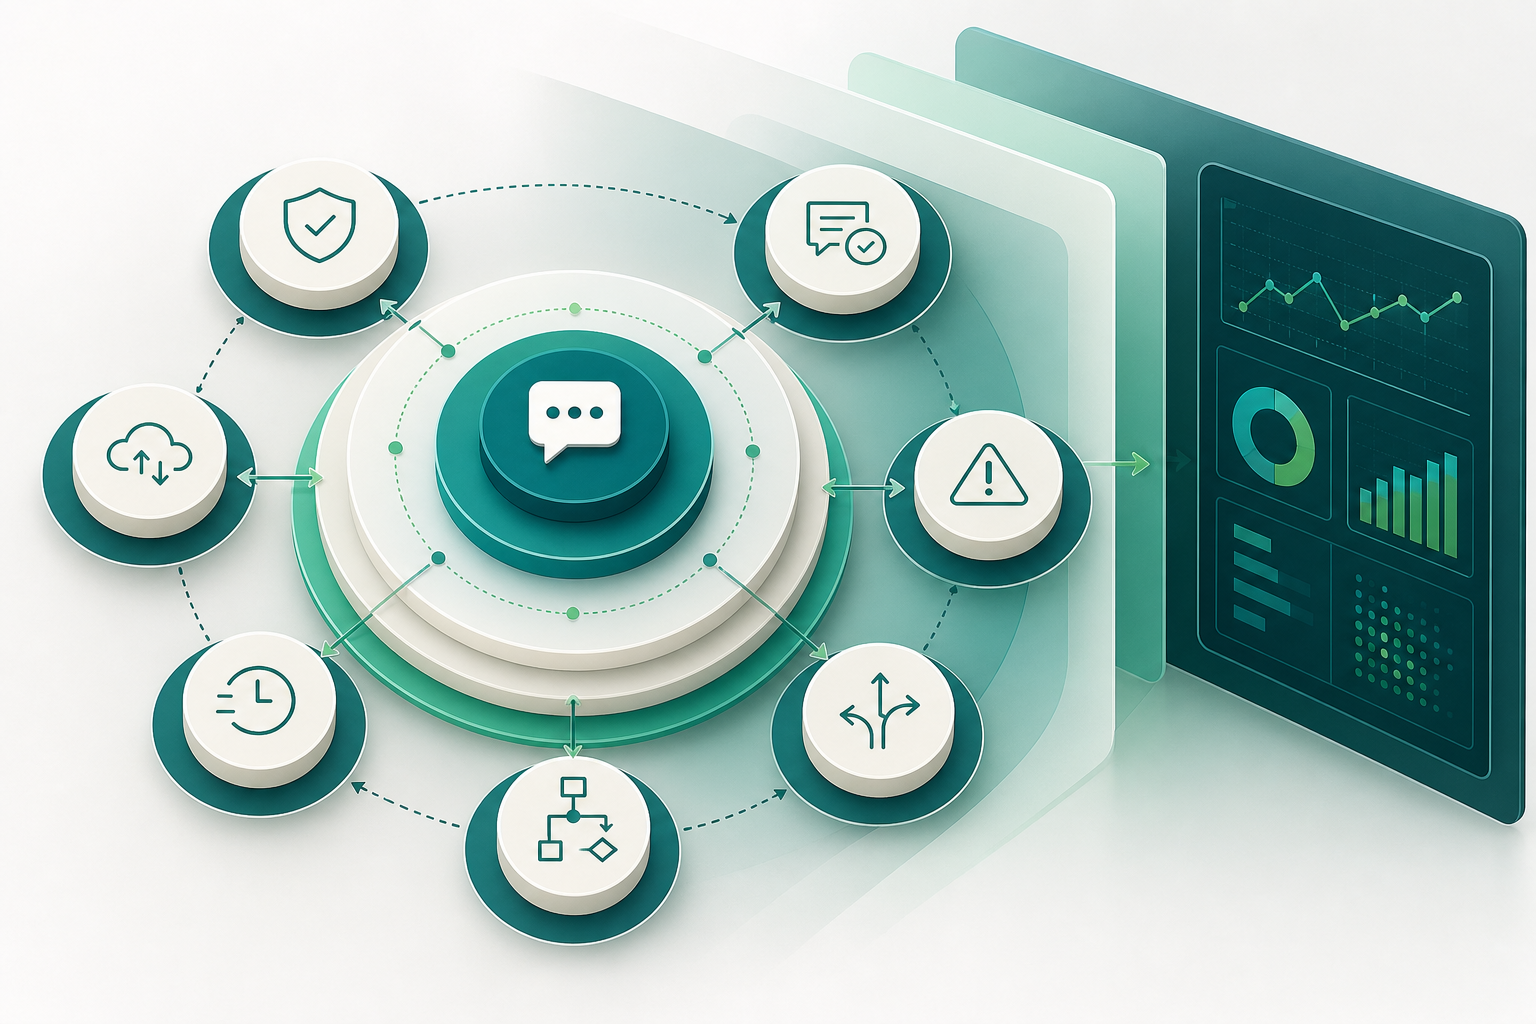
Principio de diseño: identidad técnica, clasificación operativa y datos personales son capas distintas
El primer principio es separar tres categorías que suelen mezclarse: la identidad técnica para correlacionar eventos, la clasificación operativa para analizar el tráfico y los datos personales o contenidos sensibles que deben minimizarse.
La arquitectura SMS utiliza identificadores y reportes para asociar mensajes y eventos técnicos. Estos identificadores son útiles para reconstruir una secuencia concreta, pero no deben convertirse en la taxonomía analítica. Del mismo modo, las categorías de negocio no forman parte necesariamente de los identificadores de red y deben gestionarse como metadatos propios de la plataforma.
La clasificación operativa debe responder a preguntas repetibles: qué se pretendía enviar, bajo qué política se decidió enviarlo y en qué segmento debe compararse. Los datos personales, por el contrario, no deben introducirse en etiquetas por comodidad analítica.
- Identidad técnica: identificador interno de mensaje, identificador de correlación y referencias de evento protegidas.
- Clasificación previa: caso de uso, criticidad, país de destino, tipo de remitente, canal de origen, campaña, ruta lógica y versión de plantilla.
- Resultado observado: aceptación, estado o DLR, causa de fallo, marcas temporales y latencia calculada.
- Datos a evitar: MSISDN completo, texto del SMS, OTP, nombre de persona, dirección e identificadores de cuenta reconocibles.
Campos mínimos de una taxonomía operativa
El conjunto exacto depende del modelo de operación, pero una taxonomía mínima debe aportar capacidad de segmentación sin crear una combinatoria inmanejable. Cada campo debe tener una finalidad concreta de análisis, una fuente definida y valores controlados.
Conviene conservar las etiquetas de clasificación junto al registro del envío, y almacenar los resultados observados como eventos separados o como campos de estado con marcas temporales. Esta separación evita que una observación posterior reescriba la intención o decisión original.
Un esquema práctico puede utilizar nombres técnicos estables, preferiblemente independientes del idioma de los paneles. Por ejemplo, use_case o logical_route pueden mantenerse como claves de sistema, mientras que sus descripciones se muestran traducidas a usuarios internos.
- use_case: finalidad operativa, como otp, transactional_alert o consented_marketing.
- criticality: prioridad de negocio u operación, por ejemplo critical, high, standard o low.
- destination_country: país o territorio derivado de la estructura de numeración internacional; no el número completo.
- sender_type: clasificación del remitente usada por la operación, como alphanumeric, long_number, short_code u otro valor aplicable al entorno.
- origin_channel: sistema o canal que originó el envío, por ejemplo api, smpp, portal o system_event.
- campaign_class: clase de agrupación operativa, como lifecycle, service_notice o consented_promotion; no un nombre libre con información de clientes.
- logical_route: perfil, política o decisión lógica de enrutamiento bajo control de la operación.
- provider_logical: referencia interna al proveedor o capacidad lógica, sin afirmar un trayecto físico no observado ni verificable. No use un nombre comercial si no es necesario para el análisis autorizado. Además, puede emplearse un identificador interno estable y protegido por controles de acceso adecuados para la finalidad operativa correspondiente. El valor debe representar la entidad o capacidad seleccionada lógicamente y no una garantía sobre el trayecto real que seguirá el mensaje en todos los tramos de red. Debe documentarse su alcance analítico y conservarse estable mientras esté vigente. Si cambia el proveedor o la configuración subyacente, debe tratarse como un cambio de configuración con fecha efectiva y trazabilidad suficiente. Así se evita que series históricas mezclen decisiones distintas bajo el mismo valor de etiqueta y se preserve la capacidad de comparar resultados de forma reproducible a lo largo del tiempo operativo. La documentación debe indicar el propósito y limitaciones de cada código interno utilizado por la organización. Solo deben acceder a la correspondencia entre el código y la entidad real los equipos que lo necesiten para operar, comprar capacidad, investigar incidencias o cumplir obligaciones aplicables, de acuerdo con los controles internos establecidos. La etiqueta no debe contener credenciales, condiciones comerciales, información contractual o datos personales de contactos. Tampoco debe utilizarse para inferir propiedad de infraestructura de red, calidad garantizada o cobertura efectiva en un destino concreto. Es una referencia analítica de la decisión lógica y debe interpretarse junto con los eventos observados, las marcas temporales y el resto del contexto del envío para formular conclusiones prudentes. Los cambios deben quedar registrados con responsables claros y evidencia documental disponible para revisiones autorizadas. Esto facilita auditorías y reduce discrepancias entre equipos que consultan los mismos datos a lo largo de cada periodo de análisis y operación interna documentada. La definición debe revisarse antes de ampliar su uso a nuevos sistemas.
Distinguir decisiones previas de resultados observados
Una etiqueta de decisión previa describe el contexto disponible antes de transmitir el mensaje. Por ejemplo, use_case=otp, criticality=critical, logical_route=priority_policy y template_version=otp_v3 indican cómo se clasificó o trató el envío al crearse.
Un resultado observado se genera después: acceptance_state, DLR o estado reportado, failure_class y timestamps. No conviene registrar un resultado como si fuera una característica permanente del mensaje, ni usar una etiqueta previa para dar por supuesto un resultado posterior.
Esta distinción es decisiva para la investigación. Si un segmento presenta cambios en estados de entrega, se debe poder comprobar si cambió la política de ruta, la versión de plantilla, la mezcla de destinos o la composición del tráfico antes de atribuir el cambio a una sola causa.
- Previo al envío: use_case, criticality, destination_country, sender_type, origin_channel, campaign_class, logical_route, provider_logical, template_version y taxonomy_version.
- Posterior al envío: acceptance_state, delivery_state o DLR, failure_class, event_timestamp y timestamps necesarios para calcular latencia.
- Derivado analíticamente: ventanas de latencia, ratios por segmento y clasificación de resultados inciertos.
- No reescribir la clasificación original con conocimiento adquirido después del envío; añadir eventos o campos observados con su propia fecha.
Valores controlados, nombres estables y jerarquías útiles
Una etiqueta solo es útil si el mismo valor significa lo mismo a lo largo del tiempo. Los valores libres, las abreviaturas inconsistentes y los cambios de definición sin historial reducen la capacidad de comparar periodos y debilitan la evidencia durante una incidencia.
Defina un diccionario para cada campo: finalidad, propietario, valores permitidos, significado, fuente, fecha de alta, fecha de retirada y reglas de transición. La nomenclatura debe ser legible por máquinas y personas, pero no depender de nombres temporales, campañas concretas o acuerdos comerciales cambiantes.
Las jerarquías ayudan a mantener el detalle sin sacrificar comparabilidad. Por ejemplo, use_case puede tener una familia de primer nivel y un subtipo controlado. Si el detalle no altera una decisión analítica, no merece una nueva dimensión.
- Use valores en formato consistente, como minúsculas y separadores estables: transactional_alert o consented_marketing.
- Evite sinónimos paralelos: no mezclar otp, one_time_password y verification_code para el mismo significado.
- Conserve un valor unknown o unclassified solo cuando exista una política clara para investigarlo y reducirlo.
- Añada valores nuevos mediante una solicitud documentada; no reutilice un valor retirado con otro significado.
- Versione el esquema con taxonomy_version para interpretar correctamente datos históricos.
Ejemplo de esquema para OTP, alertas y campañas consentidas
El siguiente ejemplo muestra una clasificación orientada a operación. No pretende definir categorías universales ni sustituye requisitos regulatorios, contractuales o de consentimiento aplicables a cada organización y destino.
La clave es que las etiquetas reflejen hechos de configuración o clasificación conocidos por el emisor, no supuestos sobre el destinatario ni afirmaciones no verificadas sobre la red.
- OTP: use_case=otp; criticality=critical; campaign_class=authentication; template_version=otp_v3; origin_channel=api.
- Alerta transaccional: use_case=transactional_alert; criticality=high; campaign_class=service_notice; template_version=alert_v2; origin_channel=system_event.
- Campaña consentida: use_case=marketing; criticality=standard; campaign_class=consented_promotion; template_version=promo_v5; origin_channel=portal o api.
- En todos los casos: destination_country con valor normalizado, sender_type aplicable, logical_route según la política elegida, provider_logical según referencia interna y taxonomy_version conforme al esquema vigente.
Cómo analizar aceptación, DLR, latencia y resultados inciertos
Las etiquetas permiten segmentar las métricas, pero no cambian el significado de la evidencia. Una aceptación puede indicar que una plataforma o tramo ha admitido una solicitud; un DLR o estado de entrega representa un reporte dentro del ciclo técnico de transferencia SMS. Ninguno debe presentarse, por sí solo, como prueba de lectura humana, conversión o acción del destinatario.
Para el análisis, compare siempre segmentos homogéneos. Una caída de DLR en otp de criticidad crítica hacia un país concreto y bajo una misma ruta lógica es más investigable que una media global que mezcla campañas, destinos, tipos de remitente y políticas distintas.
La latencia necesita una definición explícita. Documente qué marcas temporales se restan, en qué zona horaria se normalizan, qué eventos son elegibles y cómo se tratan los mensajes que no tienen un evento posterior dentro de la ventana definida. Los resultados sin DLR o con información incompleta deben mantenerse como inciertos, no reclasificarse automáticamente como entrega o fallo definitivo.
- Analice acceptance_state por use_case, destination_country, logical_route y sender_type.
- Analice DLR o delivery_state por cohortes con la misma plantilla, versión y periodo.
- Calcule latencia solo cuando las marcas temporales necesarias sean comparables y estén presentes.
- Separe failure_class de los estados desconocidos o pendientes.
- Conserve denominadores, ventana de observación y versión de taxonomía en cada informe.
Segmentación de incidentes con evidencia reproducible
Una taxonomía bien diseñada convierte una incidencia genérica en una secuencia de preguntas verificables. En vez de preguntar solo por qué han bajado los resultados, el equipo puede aislar cuándo comenzó el cambio, qué poblaciones se vieron afectadas y qué configuraciones compartían.
La segmentación no prueba causalidad por sí misma. Sí reduce el espacio de investigación, permite contrastar hipótesis con eventos, cambios documentados y datos de configuración, y ayuda a evitar atribuciones basadas en promedios demasiado amplios.
La evidencia debe conservar el periodo de análisis, los filtros aplicados, la versión del esquema, las definiciones métricas y la fuente de cada evento. De ese modo, otro equipo puede repetir la consulta y evaluar la misma conclusión.
- ¿El cambio afecta solo a un país o territorio, o a varios?
- ¿Se concentra en un caso de uso, una criticidad o una clase de campaña?
- ¿Coincide con una modificación de logical_route, provider_logical o template_version?
- ¿Es una variación de aceptación, de DLR, de latencia o de la proporción de resultados inciertos?
- ¿La composición de tráfico cambió y alteró la comparación frente al periodo anterior?
- ¿Hay una causa de fallo predominante documentada en los eventos disponibles?
Preguntas frecuentes
¿Qué es una taxonomía de etiquetas A2P SMS?
Es un conjunto documentado de campos y valores controlados que clasifica los envíos A2P SMS para analizarlos de forma consistente. Puede incluir caso de uso, criticidad, país de destino, canal de origen, ruta lógica y versión de plantilla, entre otros datos operativos.
¿Un DLR positivo demuestra que el destinatario leyó el SMS?
No. Un DLR es un reporte o estado dentro de la arquitectura de transferencia SMS. No demuestra lectura humana, interacción, conversión ni otro resultado comercial posterior.
¿Debo incluir el número de teléfono en las etiquetas?
No como etiqueta analítica. El MSISDN completo es dato personal y no debe duplicarse en etiquetas, nombres de campaña o logs de amplio acceso. Cuando sea necesaria correlación, use identificadores internos protegidos y controles de acceso acordes con la finalidad.
¿Qué diferencia hay entre una ruta lógica y una ruta física?
La ruta lógica representa una decisión bajo control de la operación, como un perfil o política de selección. No debe utilizarse para afirmar un trayecto físico concreto ni un operador final cuando esa información no se observa o no puede verificarse.
¿Cómo se evita que la taxonomía se deteriore con el tiempo?
Asigne un propietario, mantenga un diccionario de datos, controle los valores permitidos, versione el esquema, registre los cambios y retire valores obsoletos sin reutilizarlos con otro significado.
¿Cuántas etiquetas debe tener un envío?
Las suficientes para responder decisiones operativas relevantes, pero no tantas que fragmenten el tráfico en segmentos sin volumen o generen una combinación imposible de mantener. Empiece por los campos que explican diferencias de uso, prioridad, destino, origen, decisión lógica y versión de contenido.
Fuentes consultadas
- 3GPP TS 23.040 — realización técnica del SMS (Release 16)ETSI / 3GPP
- Portal de especificaciones 3GPP — TS 23.0403GPP
- Recomendación E.164 — plan internacional de numeración públicaInternational Telecommunication Union
- NIST SP 800-92 — Guide to Computer Security Log ManagementNational Institute of Standards and Technology
- NIST SP 800-92 Rev. 1 — Cybersecurity Log Management Planning Guide (borrador público)National Institute of Standards and Technology
- Data minimisationInformation Commissioner's Office
- System and network security — evaluación de la información registrada en logsInformation Commissioner's Office