Overflow del traffico A2P SMS: guida operativa
Come valutare una route alternativa in caso di carenza temporanea di capacità, limitare il traffico deviato e registrare le decisioni senza confondere un DLR con la ricezione confermata sul terminale.
Cosa risolve l’overflow e cosa no
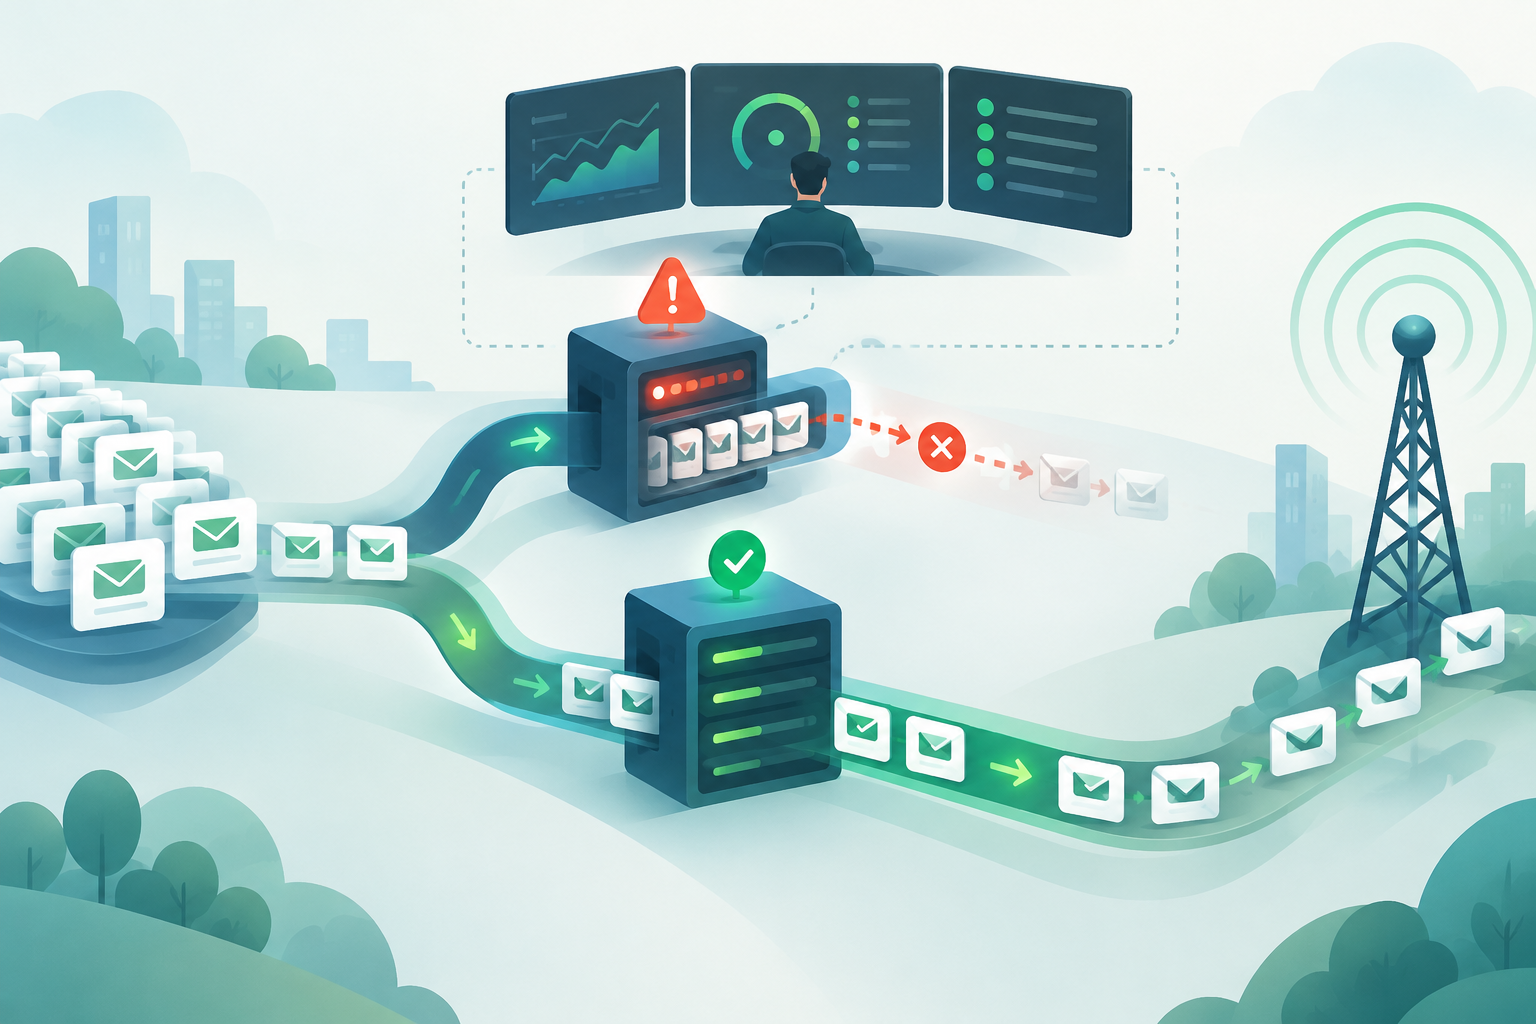
L’overflow è una policy che distribuisce o ammette parte del traffico su una route alternativa quando la capacità disponibile sulla route primaria è insufficiente. Serve a gestire una carenza temporanea; non rende automaticamente equivalente la route alternativa né dimostra che il messaggio sia arrivato al terminale.
È utile distinguerlo da altri meccanismi. Il failover indica in genere il passaggio a un’altra route quando una route non è disponibile. Il fallback consiste nell’usare un’opzione alternativa quando fallisce un’operazione o una condizione definita. Il backpressure limita o trattiene i messaggi in ingresso per non sovraccaricare un sistema. La pianificazione dei TPS mira a dimensionare in anticipo domanda e capacità. In un’implementazione questi termini possono sovrapporsi: il team dovrebbe quindi documentare quale condizione attiva ciascuna azione.
- Prima di deviare il traffico, stabilite se la causa è una capacità insufficiente, l’indisponibilità, un problema di connettività o un altro errore.
- Non considerate tutti i rifiuti come segnali di saturazione: interpretate i codici o i messaggi di errore secondo la documentazione concordata per ciascuna connessione.
- L’overflow non risolve problemi relativi a permessi, mittente, contenuto, destinazione o configurazione.
Verificare il segnale prima di deviare il traffico
Le informazioni disponibili non definiscono un elenco universale di codici di rifiuto che consenta di distinguere la saturazione da altri problemi. Il primo compito operativo è quindi concordare con ciascun provider o connessione come vengono indicati i rifiuti dovuti alla capacità e quali altri errori possono essere simili.
Esaminate il segnale insieme al contesto: volume offerto, risposte della connessione, dimensione ed evoluzione delle code, disponibilità osservata e conferma della capacità sulla route alternativa. Una coda in crescita può indicare pressione, ma da sola non dimostra che la causa sia la route. Se la causa resta ambigua, limitate o sospendete l’invio secondo la vostra policy interna, anziché presumere che la deviazione risolva il problema.
- Conservate la risposta originale e il relativo timestamp; non riducetela a una categoria generica senza salvarne i dettagli.
- Prima di ammettere traffico, verificate che la capacità della route alternativa sia confermata per la destinazione e il tipo di traffico interessati.
- Quando la documentazione della connessione lo consente, distinguete i problemi di capacità dagli errori di formato, autorizzazione, mittente, connettività e destinazione.
Definire l’idoneità prima di attivare la route
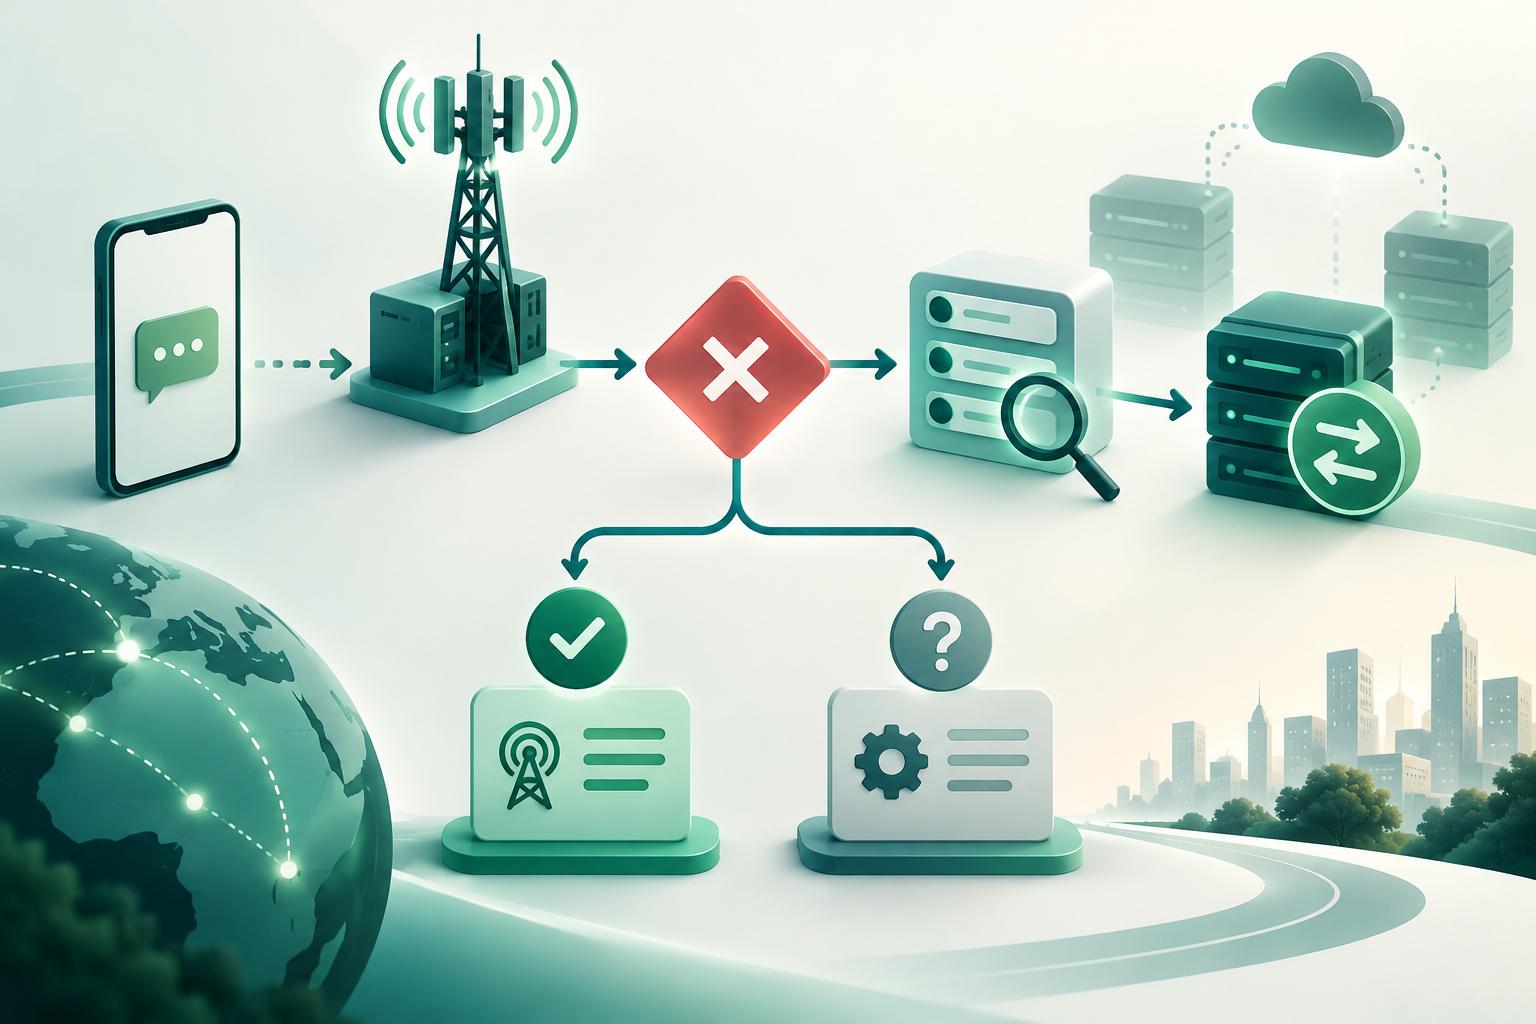
La route alternativa deve essere autorizzata per il traffico specifico. Prima di utilizzarla, verificate la destinazione, il mittente, il contenuto e la classe del messaggio secondo gli accordi applicabili e le regole vigenti. Non presumete che una route disponibile per un paese, un operatore o un tipo di traffico ammetta automaticamente anche gli altri.
La disponibilità tecnica non dimostra che il messaggio sia consentito né che esista il consenso. L’overflow deve mantenere i controlli di conformità, consenso e preferenze applicati sulla route primaria.
- Documentate le destinazioni e i mittenti ammessi da ciascuna alternativa sulla base di informazioni contrattuali o tecniche aggiornate.
- Verificate che contenuto e classe di traffico siano compatibili con la connessione e le regole applicabili.
- Se mancano elementi per confermare l’idoneità, escludete quel traffico dalla policy di overflow finché non è stato verificato.
Progettare soglie e limiti senza inventare valori standard
Qui non è indicata alcuna soglia universale per attivare l’overflow. I valori vanno definiti sulla base dei dati interni, della capacità concordata e degli obiettivi operativi. Stabilite quale metrica attiva la decisione — per esempio, rifiuti dovuti alla capacità confermati o andamento della coda —, su quale finestra viene valutata e chi può modificare la policy.
L’isteresi aiuta a evitare passaggi ripetuti da una route all’altra quando una metrica oscilla vicino alla soglia: si possono definire una condizione di ingresso e una condizione distinta per interrompere la deviazione. È un principio di progettazione, non un valore prescritto. Occorrono anche limiti di volume o velocità per evitare che la route alternativa riceva più traffico di quanto sia stato confermato che possa gestire.
- Scegliete le finestre di osservazione in base al comportamento misurato e alla latenza dei segnali disponibili.
- Stabilite limiti espliciti per ogni route e, quando opportuno, per destinazione o classe di traffico; non superate la capacità confermata.
- Definite condizioni distinte per attivare e interrompere la deviazione, oltre a una persona o a un team responsabile della decisione.
- Rivedete i limiti dopo modifiche alla capacità, alla configurazione o agli accordi; non presentate parametri interni come standard di settore.
Evitare duplicati quando l’esito è incerto
Se l’invio sulla route primaria ha un esito incerto, ritentarlo su un’altra route può causare una seconda consegna. Le informazioni fornite non consentono di affermare che esista una regola universale per evitare i duplicati o che tutte le connessioni attribuiscano lo stesso significato agli stati.
Definite una policy esplicita per gli stati ambigui, basandovi sulla documentazione delle connessioni. Prima di riprovare, registrate ciò che è noto e ciò che non lo è. Non interpretate l’assenza di un DLR come prova che il messaggio non sia stato consegnato e non presumete che l’accettazione da parte della connessione equivalga alla consegna.
- Quando l’interfaccia lo consente, distinguete tra messaggio rifiutato, accettato dalla connessione, in attesa ed esito sconosciuto.
- Prima di automatizzare tentativi o deviazioni, concordate con i responsabili delle route come gestire ciascuno stato.
- Se non potete determinare l’esito del tentativo precedente, applicate una policy prudente che eviti nuovi invii automatici non giustificati.
Monitorare la route alternativa e interpretare con cautela i DLR
Durante l’overflow, confrontate il volume offerto con quello accettato da ciascuna connessione e osservate rifiuti, code, latenza disponibile e stati segnalati. Esaminate i risultati per destinazione e classe di traffico, così da rilevare eventuali problemi concentrati ed evitare che un dato aggregato nasconda un guasto specifico.
Un DLR è uno stato comunicato dalla catena di consegna. Da solo non va considerato una prova indipendente della ricezione del messaggio sul terminale. Conservate la definizione dello stato fornita dalla connessione e distinguete ciò che il sistema segnala da ciò che può essere verificato in modo indipendente.
- Per ciascuna route, registrate i volumi offerti, accettati e rifiutati, insieme agli stati e ai timestamp disponibili.
- Monitorate la latenza e la disponibilità osservate senza trasformare una singola misurazione in una garanzia futura.
- Confrontate la route primaria e quella alternativa usando criteri coerenti e, quando i dati lo consentono, suddivisi per destinazione.
Interrompere la deviazione, tornare alla route primaria e fare escalation
Anche l’interruzione dell’overflow va definita in anticipo. Stabilite quali elementi indicano che la route primaria ha recuperato capacità, per quanto tempo tale condizione deve persistere in base alla finestra di osservazione e come evitare un ritorno prematuro. Per questi parametri non sono forniti valori universali.
Interrompete o riducete la deviazione se la route alternativa raggiunge il proprio limite, mostra segnali di degrado o non è più idonea per il traffico. Fate escalation quando non è possibile confermare la causa, la capacità o lo stato dei messaggi e mantenete il traffico entro i controlli operativi e di conformità esistenti.
- Usate condizioni di uscita diverse da quelle di ingresso per ridurre le oscillazioni tra route.
- Assicuratevi che il ritorno alla route primaria sia graduale o controllato, in funzione della capacità confermata e della progettazione del sistema.
- Effettuate l’escalation secondo responsabilità e accordi definiti in precedenza; non presumete che cambiare route risolva un problema di origine sconosciuta.
Mantenere un registro verificabile
Un registro utile permette di ricostruire che cosa è stato osservato, perché è stata presa una decisione e che cosa è successo dopo. Le informazioni disponibili non stabiliscono campi obbligatori: ogni organizzazione dovrebbe quindi definirli in base alle proprie esigenze operative, di conformità e conservazione.
Come base pratica, collegate la decisione all’intervallo osservato, alla route interessata, alla destinazione o al gruppo di traffico pertinente, ai segnali esaminati, al limite applicato, alla persona o al sistema che ha autorizzato l’azione e agli orari di attivazione e interruzione. Salvate anche le risposte e gli stati disponibili, distinguendo i dati segnalati dai fatti verificati.
- Conservate la causa assegnata e gli elementi che la supportano, inclusa, quando possibile, la risposta tecnica originale.
- Registrate quanto traffico è stato deviato e i risultati osservati, senza trasformarli in una garanzia di consegna.
- Annotate le modifiche manuali, le eccezioni, le escalation e la motivazione per riprovare o non reinviare messaggi dall’esito incerto.
- Dopo l’incidente, rivedete il registro per adeguare la policy sulla base dei vostri dati e della capacità confermata.
Domande frequenti
Quando conviene attivare l’overflow del traffico A2P SMS?
Quando segnali interpretabili supportano l’ipotesi di capacità insufficiente e la capacità e l’idoneità della route alternativa sono confermate. Se la causa del rifiuto è incerta, non classificatelo automaticamente come saturazione.
Quale soglia di overflow si dovrebbe usare?
Qui non è indicato alcun valore universale. Definite la soglia sulla base dei vostri dati, della capacità concordata, delle finestre di osservazione e di una condizione di interruzione distinta; limitate sempre il traffico a quanto è stato confermato per la route alternativa.
Un DLR conferma che l’SMS è arrivato sul telefono?
Da solo non va considerato una prova indipendente della ricezione sul terminale. Interpretate lo stato secondo il significato comunicato dalla connessione e distinguetelo da una verifica indipendente.
È opportuno reinviare su un’altra route un SMS dall’esito incerto?
Non automaticamente e senza una policy concordata: il reinvio può causare duplicati e l’assenza di uno stato conclusivo non dimostra che il primo tentativo non sia stato consegnato. Consultate la semantica della connessione e registrate la decisione.
BulkSMSMarket offre attualmente l’overflow automatico in produzione?
Le informazioni disponibili descrivono una piattaforma in sviluppo per scoprire, confrontare, acquistare, vendere e gestire capacità A2P SMS, oltre a connettività HTTP e SMPP e interrogazioni HLR. Il backend pubblico per l’instradamento live non è ancora disponibile; non si deve presumere che l’overflow automatico sia una funzione attiva.
Fonti consultate
- 3GPP specifications3GPP
- ITU-T E.164International Telecommunication Union
- GSMA resourcesGSMA