Disponibilidad HTTP y SMPP en SMS A2P: qué medir y cómo interpretar fallos
Guía operativa general para separar conectividad, respuestas de interfaz y estados posteriores de SMS A2P. Las comprobaciones e interpretaciones deben contrastarse con el contrato y la implementación de cada interfaz.
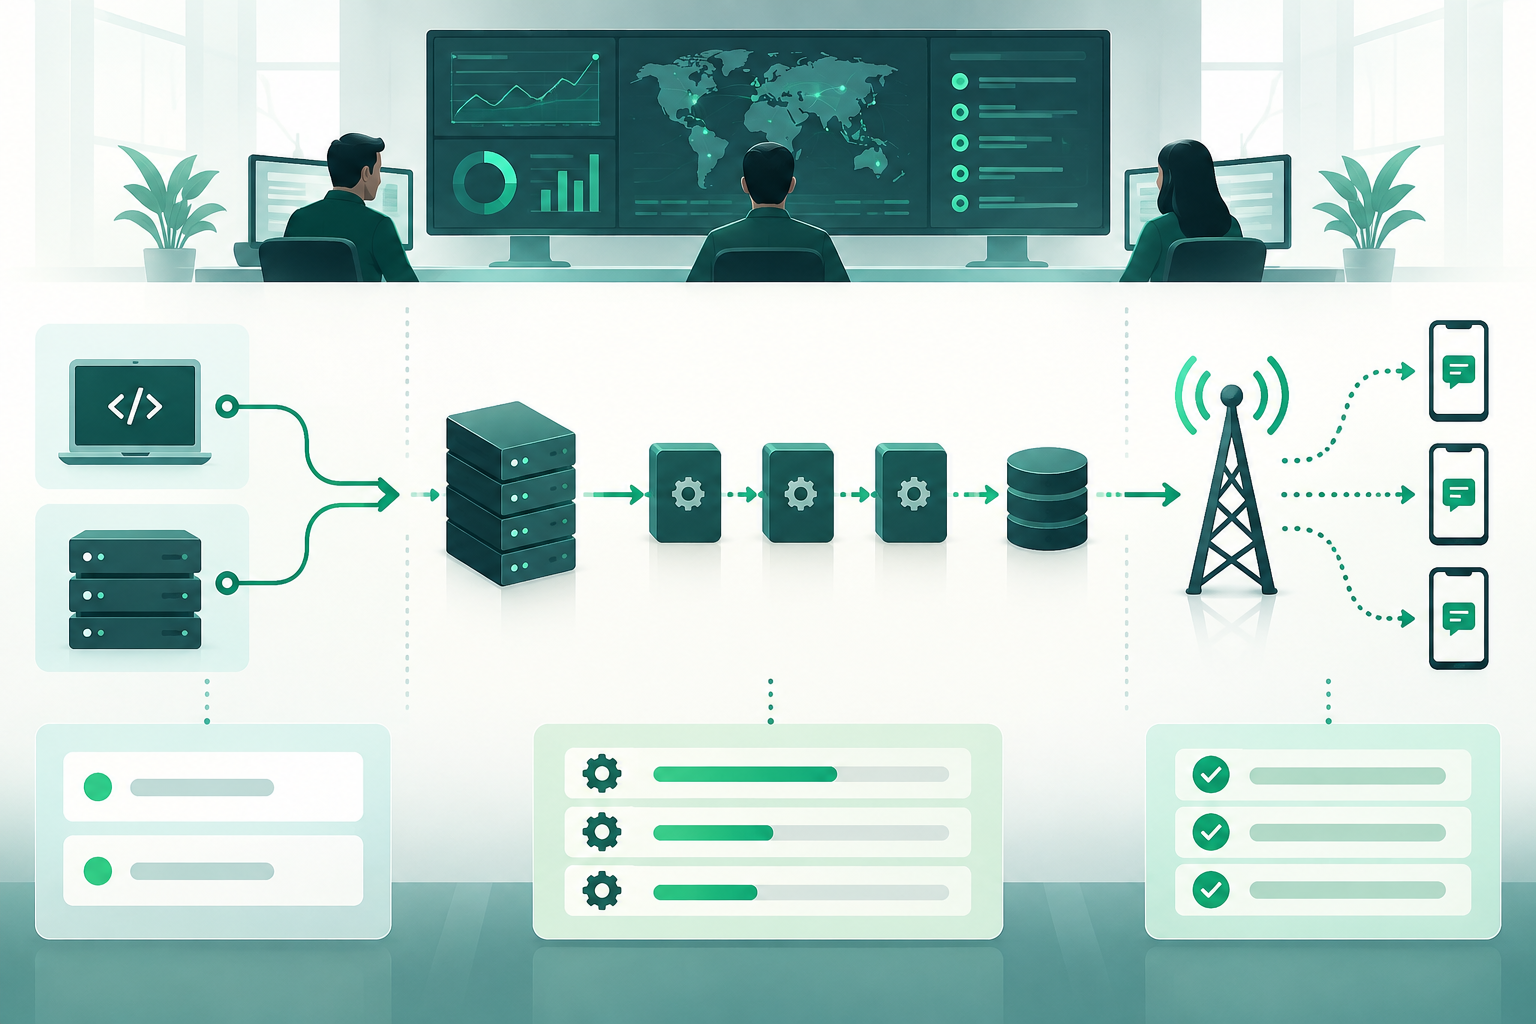
Disponibilidad no equivale a entrega
Esta es una guía operativa general, no una especificación normativa. Las comprobaciones e interpretaciones descritas deben contrastarse con el contrato, la documentación y la implementación de cada interfaz.
Como marco de trabajo, conviene separar tres resultados: conectividad, respuesta de interfaz y estado posterior del mensaje. Una respuesta técnica, por sí sola, no permite concluir que el SMS haya sido procesado, encaminado o recibido en el teléfono.
Registra cada etapa por separado. Si se agrupan en un único indicador de «disponibilidad», puede ser difícil distinguir un problema de conexión de una respuesta funcional o de un resultado posterior.
- Conectividad: ¿se completó la comprobación definida para alcanzar el servicio?
- Interfaz: ¿se recibió una respuesta a la operación comprobada?
- Estado posterior: ¿qué información sobre el mensaje está disponible y cuál es su procedencia?
- No presentes una respuesta HTTP, una respuesta a una solicitud SMPP o una sesión establecida como prueba suficiente de entrega.
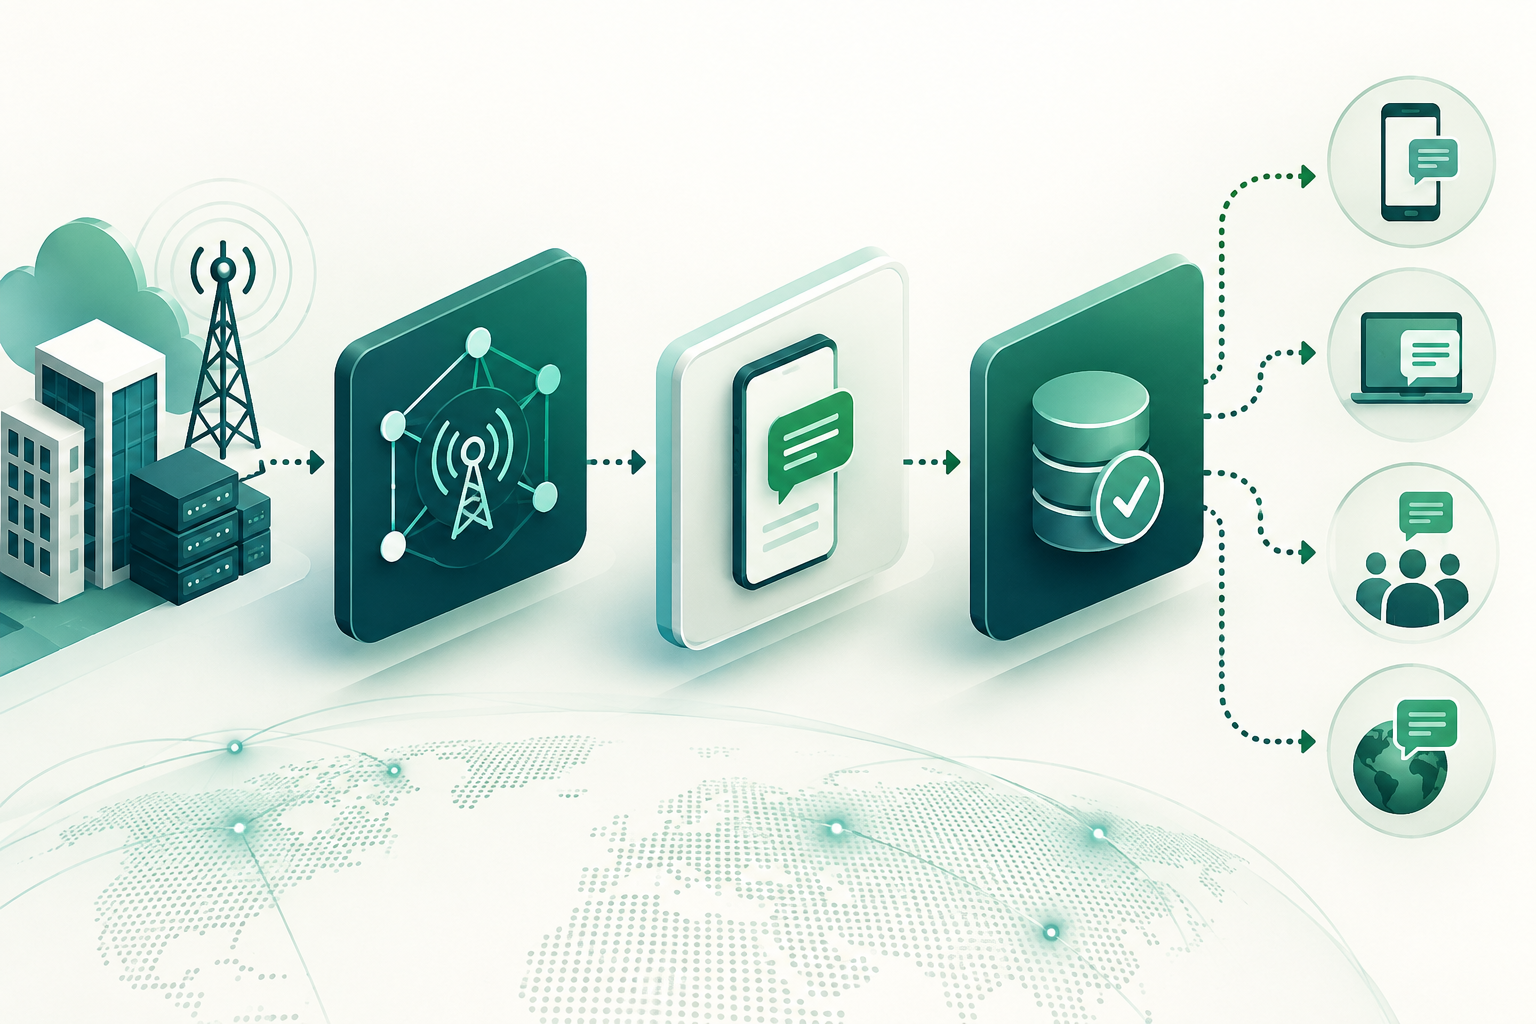
Divide la comprobación en capas
Como práctica sugerida, localiza la última etapa completada antes de atribuir un fallo al proveedor o a la aplicación. Una comprobación puede distinguir resolución de nombre, conectividad de red, establecimiento de comunicación, autenticación, envío de una operación y respuesta de interfaz, cuando esos pasos correspondan a la implementación.
Define previamente qué endpoint, credenciales de prueba, operación y resultado se consideran válidos. Compara la comprobación con una referencia conocida y conserva marcas de tiempo y registros de ambos extremos cuando estén disponibles. Un timeout significa que la comprobación no terminó dentro del límite configurado; por sí solo no identifica la causa.
En un incidente, comprueba si el patrón afecta a todas las conexiones o solo a un cliente, endpoint, operación o destino de prueba. Esa comparación puede orientar la investigación, pero no confirma por sí misma dónde se originó el problema.
- Anota la etapa exacta del fallo, de acuerdo con los pasos aplicables a la interfaz.
- Usa límites de espera definidos y registra el tiempo transcurrido; no presentes una espera agotada como diagnóstico causal.
- Conserva la hora, los identificadores de correlación disponibles y el resultado observado; evita almacenar credenciales o datos personales innecesarios.
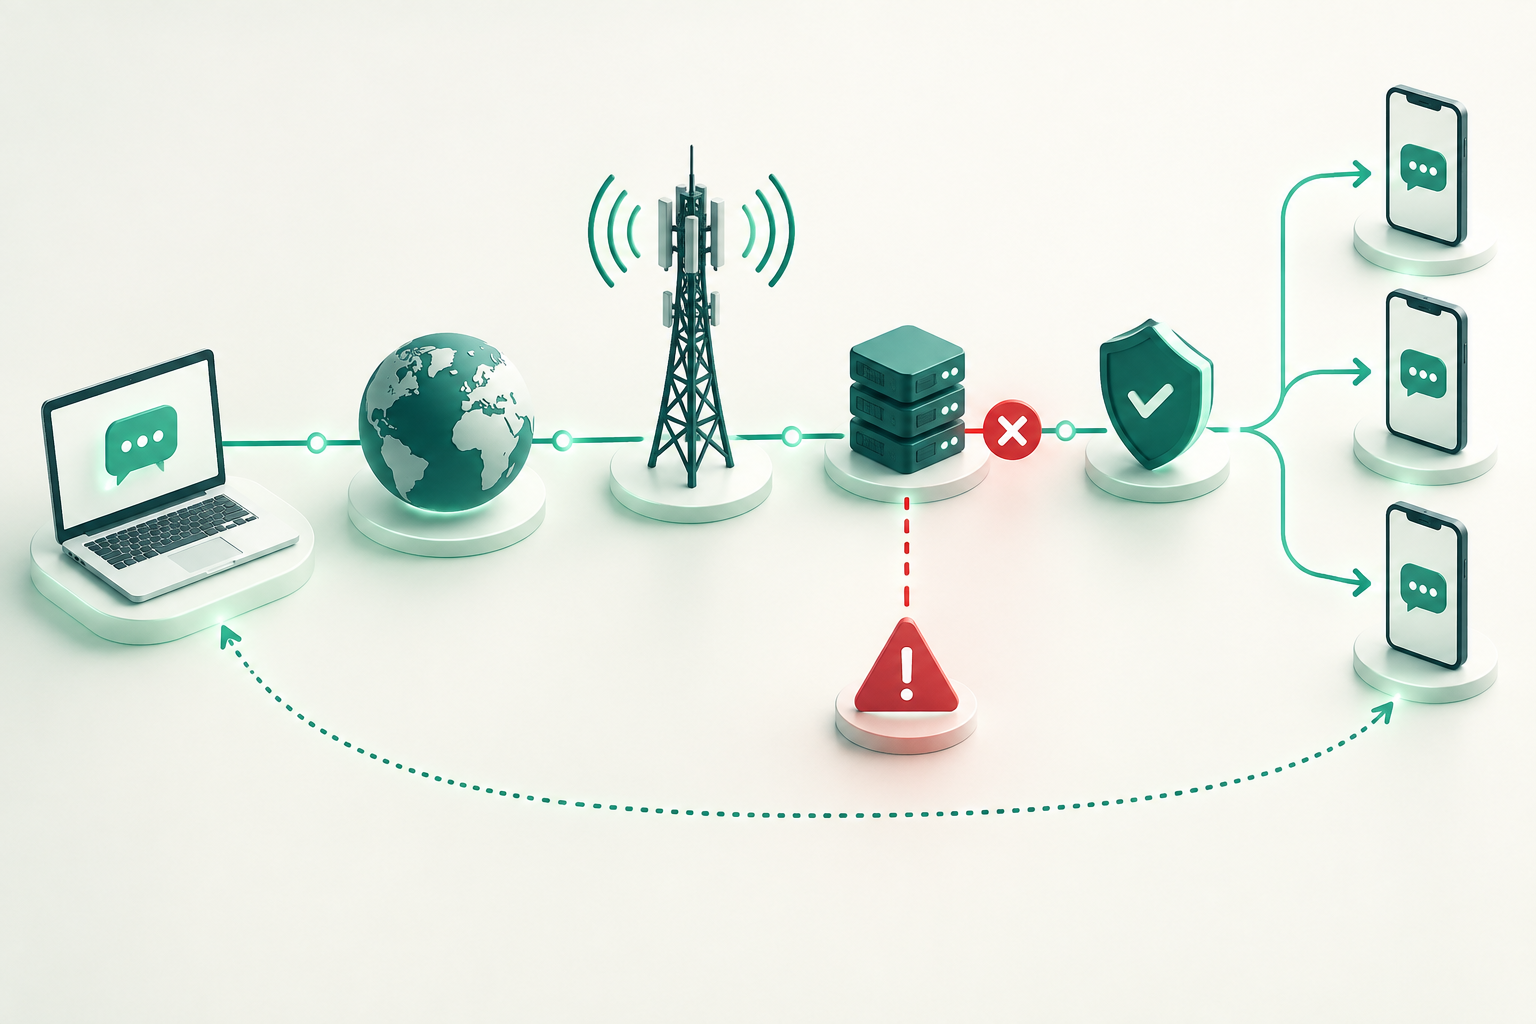
Qué observar en HTTP
Como práctica operativa general, puede ser útil separar el tiempo de conexión del tiempo total hasta recibir una respuesta. Registra el estado HTTP, los tiempos observados, los timeouts y los errores de aplicación que la interfaz exponga. Interpreta el resultado según la documentación y el contrato de la API; esta guía no establece el significado de códigos HTTP concretos.
Distingue una respuesta recibida de un resultado funcional. Una respuesta HTTP no permite determinar por sí sola si la operación fue aceptada, rechazada o quedó pendiente: consulta la semántica documentada para esa interfaz.
Evita reintentar a ciegas cuando se agota el tiempo de espera después de enviar una solicitud. Si la interfaz no permite saber si la operación se procesó, un reintento podría duplicarla. Aclara con el proveedor cómo consultar el resultado o cómo realizar reintentos seguros.
- Como indicadores sugeridos, registra por separado conexión, tiempo de respuesta, estado HTTP y resultado funcional informado por la API.
- Clasifica los resultados según el contrato de la interfaz, sin asumir que un estado tiene el mismo significado en todos los sistemas.
- Consulta la documentación de la API para interpretar respuestas y resolver estados inciertos antes de automatizar reintentos.
Qué observar en SMPP
Como registro operativo general, puede ser útil anotar el resultado del bind, el estado observado de la sesión, las comprobaciones de actividad configuradas, las solicitudes submit_sm y sus respuestas, además de desconexiones y reconexiones. La interpretación de estos eventos depende de la versión, la configuración y la documentación acordadas con el extremo remoto.
No infieras la entrega al destinatario a partir de una respuesta a una solicitud de envío. Del mismo modo, una sesión establecida no demuestra por sí sola que todas las solicitudes futuras vayan a aceptarse ni que sus mensajes tengan un resultado posterior determinado.
Cuando estén disponibles, correlaciona las respuestas de envío con los identificadores devueltos por la interfaz y con los estados posteriores. Trata un DLR como un estado reportado por el sistema correspondiente, no como verificación independiente de que el teléfono mostró el mensaje o de que la persona lo leyó.
- Como observaciones operativas sugeridas, registra sesiones establecidas o perdidas, duración, actividad configurada y reconexiones.
- Anota el resultado de cada solicitud de envío y los identificadores asociados; mantén separada la respuesta de envío del estado posterior.
- Consulta la configuración y documentación acordadas para interpretar eventos, límites y estados; no asumas valores universales.
Diseña pruebas sintéticas seguras y útiles
Como práctica sugerida, una prueba sintética comprueba un recorrido limitado bajo condiciones controladas; no representa automáticamente todo el tráfico, todos los destinos ni todos los operadores. Especifica qué componente evalúa y qué conclusiones quedan fuera de su alcance.
Utiliza cuentas, números y destinos de prueba controlados y autorizados, junto con contenido permitido y acordado. Coordina el método, la frecuencia y los límites con el proveedor y las políticas aplicables. Si no hay un destino controlado o una autorización clara, limita la prueba a las comprobaciones que sí estén autorizadas.
Mantén una frecuencia acordada para evitar tráfico innecesario o interferencias. Identifica las comprobaciones para separar sus resultados del tráfico real. No envíes mensajes a personas que no hayan autorizado la prueba.
- Define qué se quiere comprobar: conectividad, autenticación, respuesta de interfaz o un recorrido de prueba autorizado.
- Acuerda previamente destinos, contenido, frecuencia, volumen y forma de identificar las pruebas.
- Documenta los límites: un resultado satisfactorio en un destino y momento no garantiza disponibilidad general ni resultados futuros.
Relaciona conectividad, respuestas y estados posteriores
Como método de investigación sugerido, sigue una secuencia de evidencias: comprueba si hubo conectividad, si la autenticación y la solicitud se completaron y, por último, qué estados posteriores están disponibles. Esta secuencia ayuda a ordenar la investigación, pero no demuestra por sí sola la causa.
Correlaciona marcas de tiempo, identificadores de solicitud o mensaje, endpoint o sesión, respuesta recibida y eventos de desconexión. Compara los datos del emisor y del receptor cuando ambas partes puedan aportarlos. Si faltan identificadores comunes o los relojes no son comparables, indícalo como límite.
No atribuyas un cambio en los estados posteriores a la conectividad solo porque coincida con un aumento de errores. La correlación puede orientar el diagnóstico, pero hacen falta evidencias de la etapa correspondiente para establecer una causa.
- Conectividad: registra los fallos observados durante las comprobaciones definidas.
- Respuesta de interfaz: registra lo que la respuesta indica según el contrato acordado.
- Estado posterior: anota los estados o informes disponibles, junto con su procedencia y límites.
- Mantén separados los registros de cada categoría en lugar de sumarlos en una única tasa de fallo.
Indicadores y ventanas de observación
Como práctica sugerida, elige indicadores vinculados a decisiones operativas: proporción de comprobaciones completadas, respuestas recibidas dentro del límite configurado, sesiones observadas, respuestas de envío y estados posteriores disponibles. Especifica el denominador, la población, el método de comprobación y la fuente de datos.
No dependas solo de promedios. Un promedio puede ocultar interrupciones breves o diferencias entre endpoints y destinos. Conserva la serie temporal y revisa los eventos individuales relevantes, sin asumir umbrales universales.
Define ventanas de observación y límites de alerta según el servicio y los acuerdos operativos. Registra cambios de configuración y mantenimiento para interpretar variaciones. Si una prueba sintética es poco frecuente, ten presente que podría no detectar fallos entre comprobaciones.
- Presenta por separado conectividad, respuesta de interfaz y estados posteriores.
- Indica la ventana temporal, la población medida y el número de observaciones junto con cada indicador.
- Examina eventos breves y resultados por endpoint o sesión, además del valor agregado.
Alertas y escalamiento con evidencia
Como práctica sugerida, una alerta puede señalar qué comprobación falló, desde dónde, cuándo y durante cuánto tiempo, además de qué etapas anteriores sí se completaron. Establece reglas de escalamiento según el impacto observado y los procedimientos acordados; esta guía no propone umbrales universales.
Antes de escalar, reúne registros pertinentes: marcas de tiempo, endpoint o sesión, operación, resultado observado, identificadores de correlación disponibles y alcance del impacto. Añade el método de comprobación y los pasos completados. No incluyas contraseñas, tokens ni datos personales innecesarios.
Al informar al proveedor o al equipo interno, separa hechos de hipótesis. Por ejemplo, indica que no se recibió respuesta dentro del límite configurado y en qué etapa ocurrió; no afirmes que el proveedor está caído si la causa no se ha aislado.
- Escala según los criterios operativos acordados y el impacto observado.
- Incluye evidencia de conexiones afectadas y no afectadas para acotar el alcance.
- Si la conectividad y la interfaz responden pero el estado del mensaje es incierto, solicita la interpretación del estado y los registros disponibles de la etapa posterior.
Preguntas frecuentes
¿Una respuesta HTTP confirma que el SMS se entregó?
No por sí sola. Confirma que se recibió una respuesta del endpoint. El significado de la operación y los estados posteriores debe consultarse en la documentación y el contrato de esa API.
¿Una respuesta satisfactoria a submit_sm significa que el destinatario recibió el mensaje?
No permite concluirlo por sí sola. Consulta la documentación de la interfaz y los estados posteriores disponibles, teniendo en cuenta su origen y alcance.
¿Una sesión SMPP establecida demuestra disponibilidad de extremo a extremo?
No. Solo informa sobre la sesión observada; no demuestra por sí sola que cada solicitud se procese ni que los mensajes tengan un resultado posterior determinado.
¿Qué debe hacer una prueba sintética cuando no hay un destino controlado?
Limitarse a las comprobaciones de conectividad y respuesta de interfaz que estén autorizadas. No enviar mensajes a destinatarios sin autorización ni inferir un resultado posterior a partir de una comprobación parcial.
¿Qué información conviene compartir al escalar una incidencia?
Incluye hora, endpoint o sesión, operación, etapa del fallo, resultado observado, identificadores disponibles y alcance. Separa hechos de hipótesis y excluye credenciales y datos personales innecesarios.
Fuentes consultadas
- HTTP Semantics (RFC 9110)IETF
- SMPP Protocol Specification v3.4SMPP Developers Forum
- SMPP specificationOVHcloud