Gestione delle code di uscita A2P SMS: ammissione, smaltimento e ripristino
Una guida operativa per definire quali messaggi ammettere in coda, come classificarli in caso di errore, quando scadono e come ripristinare il flusso senza confondere l’accettazione a valle con la consegna al destinatario.
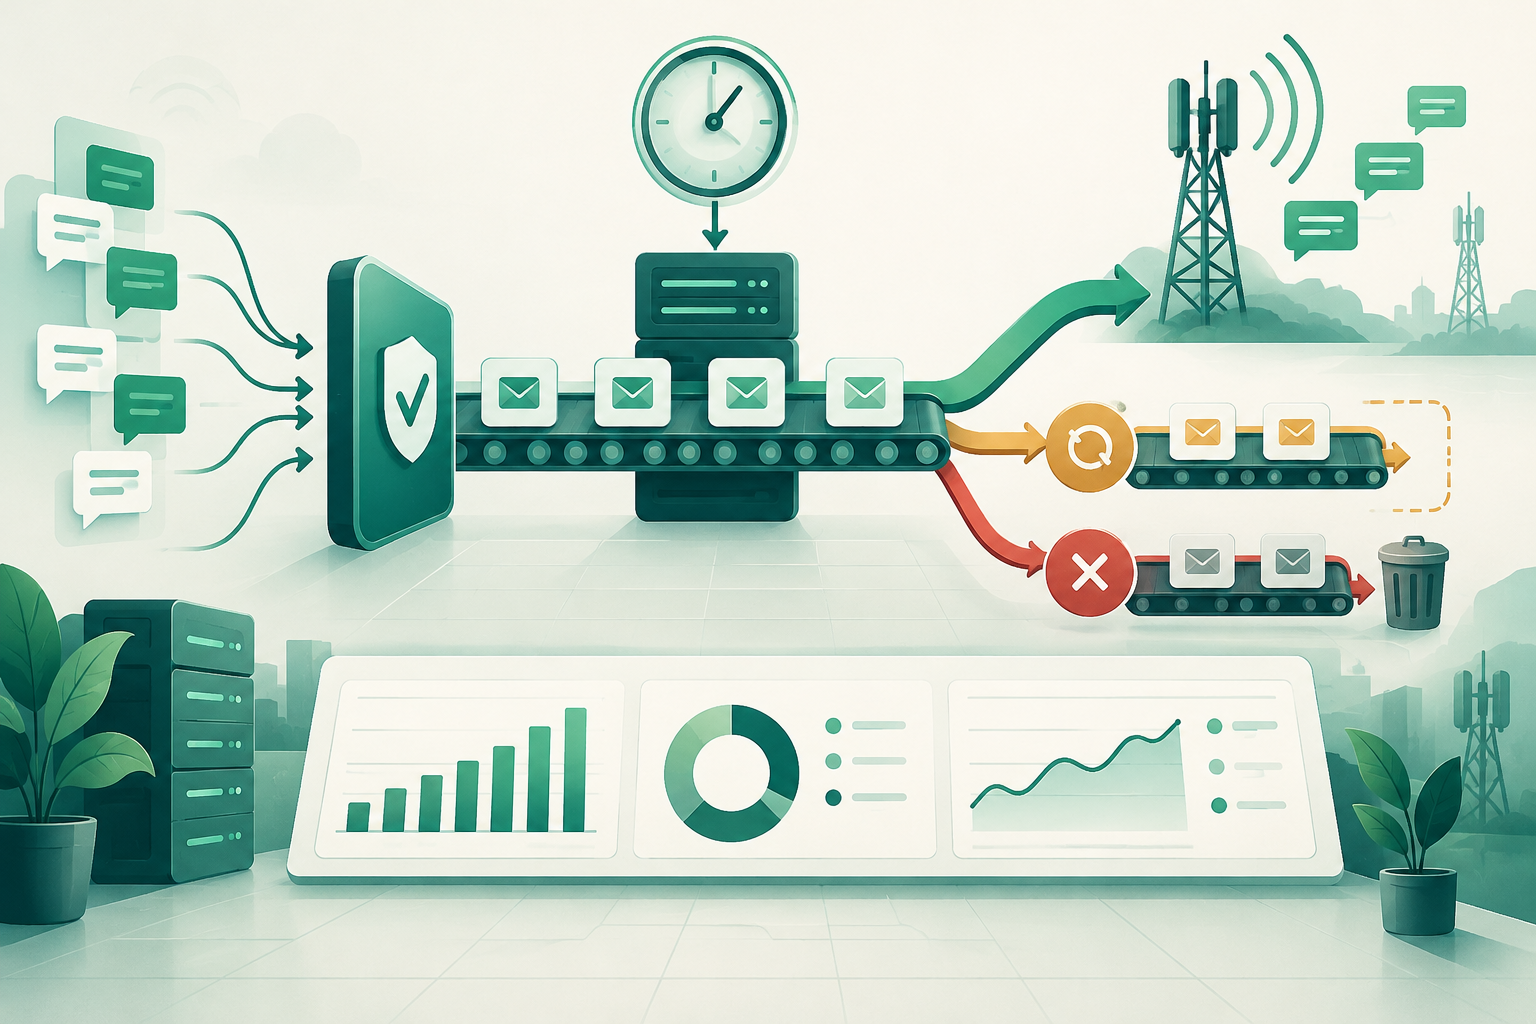
La coda inizia dove un sistema trattiene il messaggio
In una catena A2P possono esserci diverse code: nell’applicazione mittente, nella piattaforma di messaggistica, in una connessione o presso un intermediario e nei sistemi successivi. Per operare con chiarezza, individua la coda che stai misurando e chi è responsabile di ogni passaggio.
Un messaggio «in coda» non equivale ancora a un messaggio accettato dal sistema successivo; inoltre, l’accettazione da parte di quel sistema non dimostra che il messaggio sia arrivato al telefono. Definisci esplicitamente il confine di responsabilità: per esempio, messaggio ricevuto dalla piattaforma, tentativo di invio, risposta di accettazione del sistema successivo ed eventuale esito della consegna, se disponibile.
- Assegna a ogni messaggio un identificativo che possa essere correlato tra i sistemi sotto il tuo controllo.
- Registra quando il messaggio entra in coda, quando viene elaborato e quale esito restituisce il sistema successivo.
- Tieni separati gli stati interni e quelli comunicati da interfacce o report esterni.
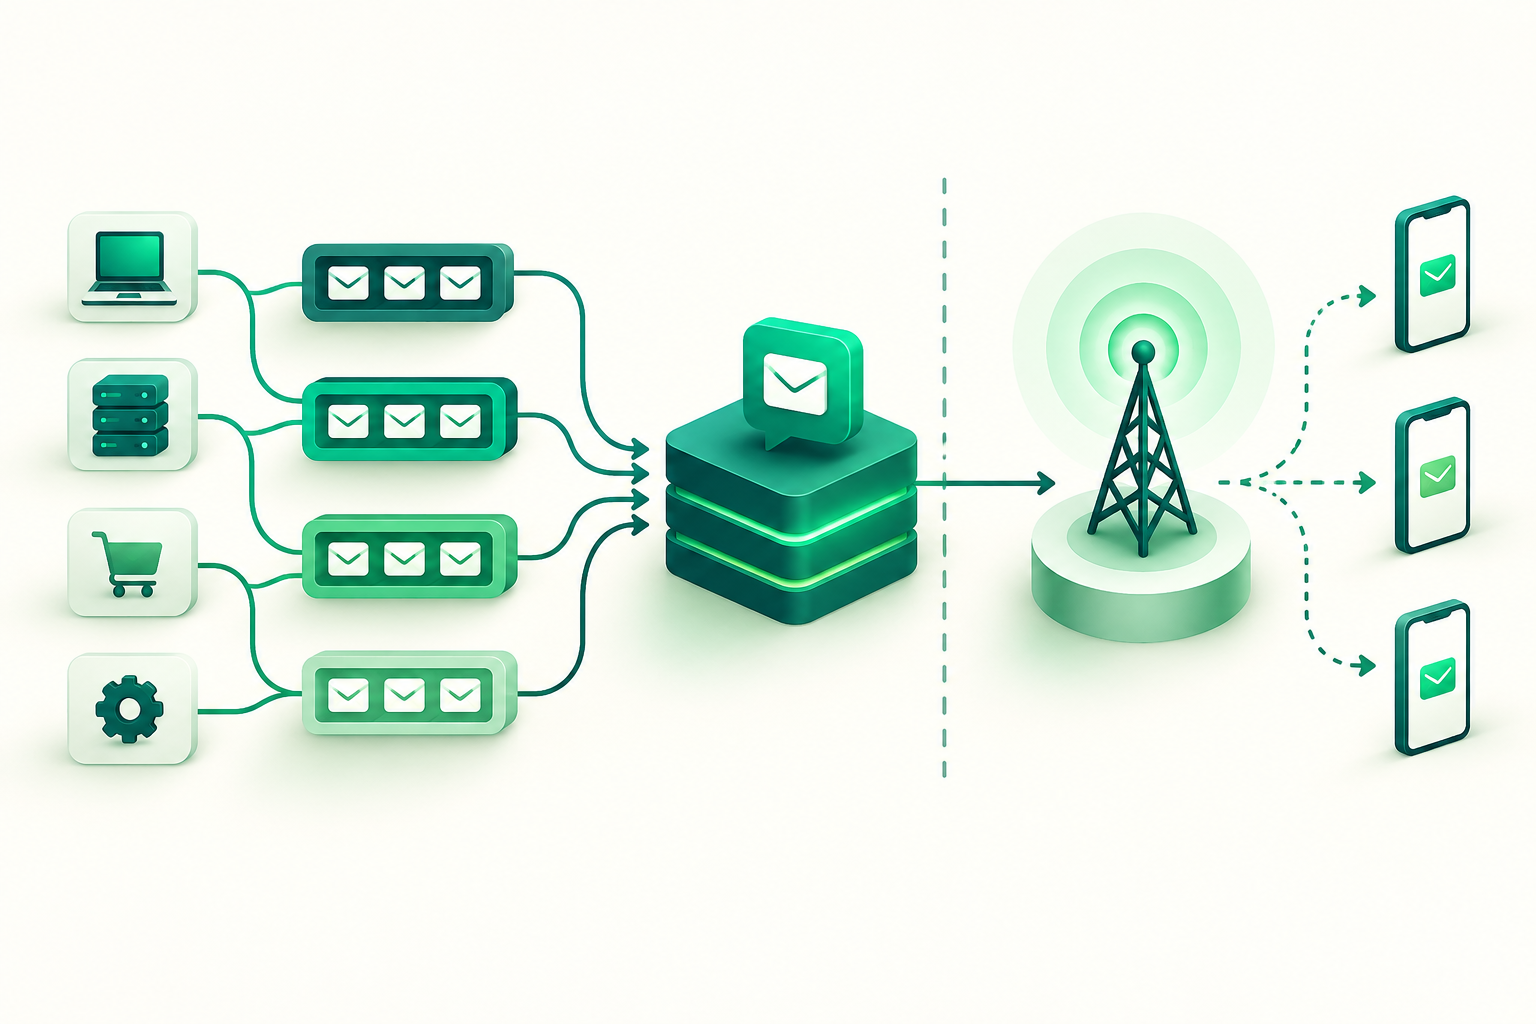
Definisci stati che spieghino cosa è successo
Un modello interno utile distingue il lavoro in attesa da quello in corso e da quello che ha già ricevuto una risposta dal sistema successivo. Deve inoltre rappresentare i messaggi rinviati, scaduti o messi da parte per una verifica. Si tratta di categorie operative: non vanno presentate come un elenco normativo di stati SMPP né confuse automaticamente con i codici di un’interfaccia.
Documenta le transizioni consentite, l’evento che le attiva e il sistema che fornisce le evidenze. Per esempio, una risposta di accettazione a valle può chiudere la responsabilità della coda locale, ma non deve essere indicata come consegna finale al destinatario, a meno che non vi siano evidenze adeguate a sostenerlo.
- In attesa: accettato dalla piattaforma, senza un tentativo attivo in corso.
- In elaborazione: un worker sta gestendo l’invio.
- Accettato a valle: il sistema successivo ha confermato di accettare il messaggio; non implica che sia stato ricevuto dal dispositivo.
- Rinviato: l’elaborazione è posticipata secondo una policy definita.
- Scaduto: il messaggio ha perso la sua utilità nel tempo e non deve essere inviato come se fosse ancora valido.
- In verifica: serve una decisione operativa prima di riprendere o chiudere il caso.
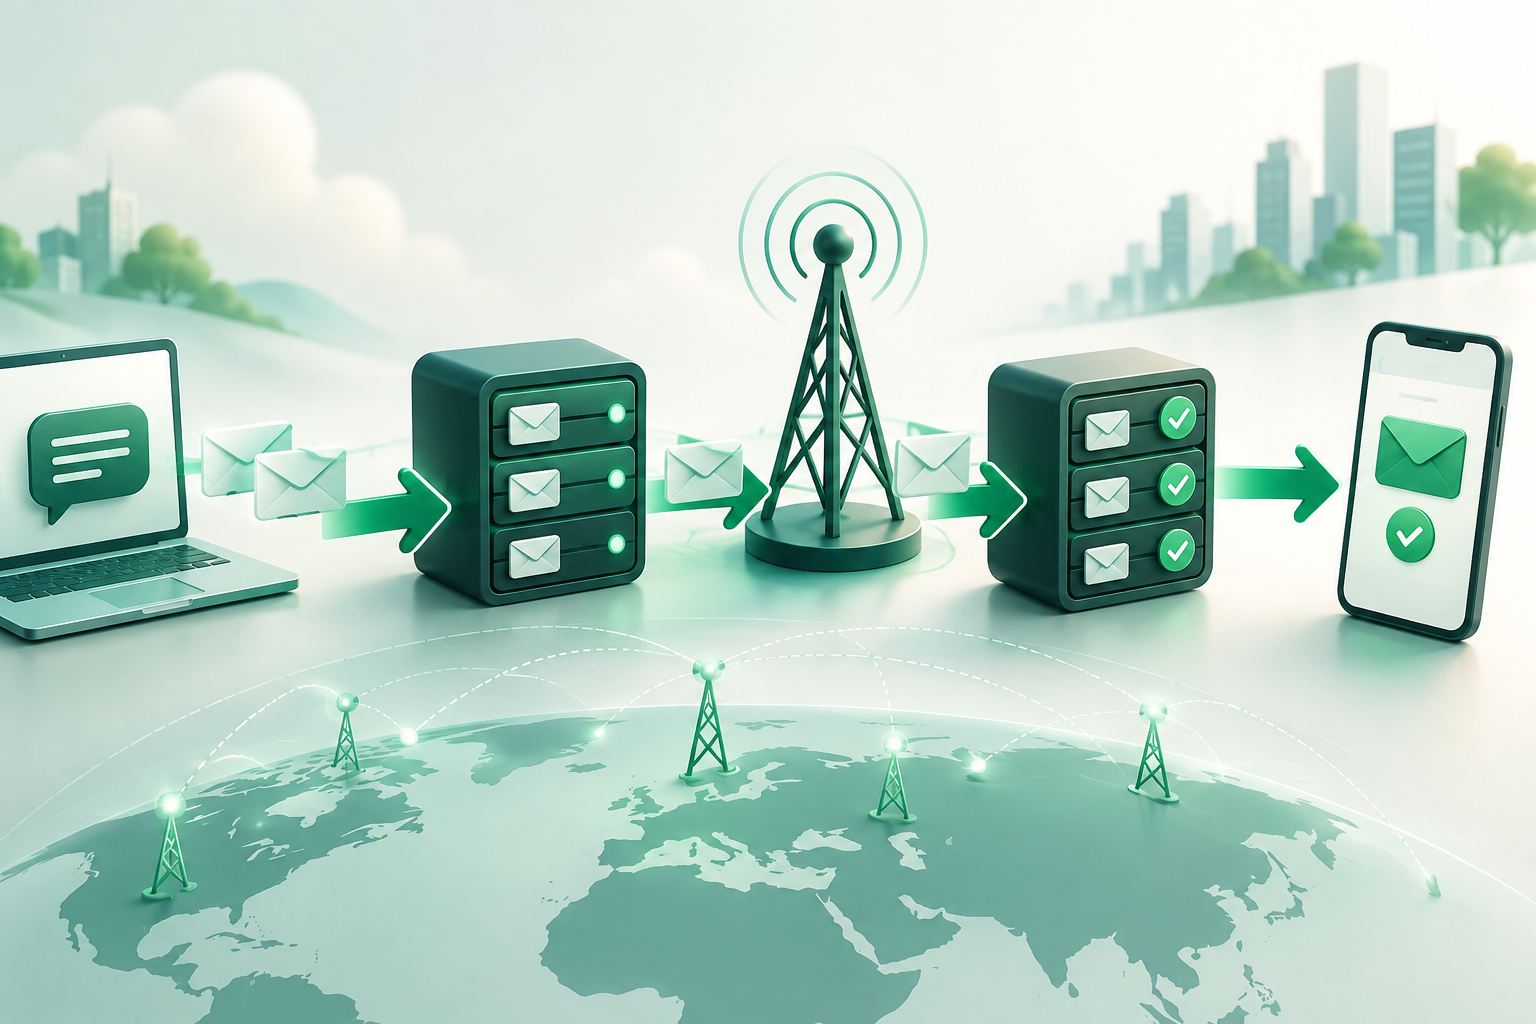
Ammetti il traffico in modo da proteggere la capacità
Una coda non dovrebbe crescere senza un limite operativo. Definisci i limiti di ammissione e capacità in base alle risorse che controlli davvero: spazio di archiviazione, worker disponibili, connessioni e capacità configurata per le destinazioni o le classi di traffico. Non esiste una soglia universale che si possa fissare senza conoscere l’architettura, gli accordi e il comportamento osservato.
La segmentazione per destinazione o classe può aiutare a evitare che un flusso problematico assorba tutte le risorse degli altri flussi. La segmentazione comporta anche maggiore complessità: definisci cosa succede al raggiungimento di un limite, come viene comunicato l’esito al mittente e chi può modificare la policy. Evita di accettare un messaggio se il sistema non è in grado di conservarlo in modo affidabile fino all’elaborazione o di rifiutarlo chiaramente.
- Imposta limiti per ogni coda e per i segmenti con comportamenti o requisiti diversi.
- Definisci un’azione esplicita al raggiungimento della capacità: rifiutare, rinviare o applicare un’altra policy documentata.
- Assicurati che l’applicazione mittente possa distinguere un’ammissione da un rifiuto e gestire i propri nuovi tentativi senza duplicare gli invii.
- Rivedi i limiti sulla base dei dati di ingresso, uscita, anzianità e risorse, non di valori generici.
Classifica l’errore prima di riprovare
Non tutti gli errori richiedono lo stesso trattamento. Una saturazione temporanea, un’indisponibilità, un rifiuto potenzialmente transitorio e un errore che richiede la correzione del messaggio o della configurazione hanno implicazioni diverse. Classifica l’errore usando la risposta concreta dell’interfaccia o del sistema collegato e la documentazione pertinente; non inventare corrispondenze tra codici.
Per ogni classe di errore, documenta se il messaggio va ritentato, rinviato, rifiutato o sottoposto a verifica. I nuovi tentativi devono essere limitati e coordinati tra mittente e piattaforma: se entrambi ripetono l’invio senza coordinarsi, possono aumentare il carico e creare duplicati. Conserva l’esito originale per facilitare la diagnosi.
- Saturazione: proteggi le risorse e applica la policy di ammissione o rinvio definita.
- Indisponibilità: stabilisci se è opportuno attendere e riprovare, con limiti e registrazione del motivo.
- Rifiuto potenzialmente recuperabile: verifica quale condizione deve cambiare prima di un nuovo tentativo.
- Errore permanente o non correggibile automaticamente: evita cicli di nuovi tentativi e avvia la chiusura o la verifica del caso.
- In ogni caso, registra la risposta osservata e la decisione applicata.
Ordine e priorità senza blocchi indefiniti
FIFO, ovvero primo a entrare, primo a uscire, è una scelta semplice quando i messaggi di una coda condividono requisiti di urgenza e non c’è una ragione operativa per modificarne l’ordine. Se le classi hanno validità o priorità diverse, può essere più adatta una policy esplicita, che deve però garantire la tracciabilità ed evitare che il traffico a priorità inferiore resti bloccato a tempo indeterminato.
Prima di introdurre priorità, definisci quali messaggi possono appartenere a ciascuna classe, chi determina la classificazione e come verificare che la policy funzioni. Non basare le priorità su contenuti sensibili e non usarle per aggirare i controlli sul consenso o sulla conformità.
- Usa FIFO se l’ordine è un requisito e la classe è omogenea.
- Separa le classi solo in presenza di un’esigenza operativa giustificata e verificabile.
- Misura i tempi di attesa per classe e verifica che una priorità non causi il blocco indefinito delle altre.
- Documenta il comportamento per i messaggi con pari priorità e in caso di cambiamento di classe.
Allinea la validità all’utilità del messaggio
La validità indica per quanto tempo è ancora utile inviare un messaggio. Un codice monouso, una notifica transazionale e una campagna autorizzata possono avere esigenze temporali diverse: non presumere che condividano una scadenza appropriata. Il responsabile del messaggio deve definirne l’utilità e la piattaforma deve applicare una policy coerente.
Quando un messaggio scade, non inviarlo senza segnalarlo come se fosse ancora valido. Registra la scadenza e comunica l’esito in modo che il sistema mittente possa decidere cosa fare. Se si valuta un nuovo invio, questo deve essere trattato come una nuova decisione aziendale, non come una ripetizione automatica di contenuti obsoleti.
- Definisci la validità per ciascun caso d’uso insieme al responsabile del messaggio.
- Quando previsto dalla policy, verifica l’anzianità prima di ogni nuovo tentativo.
- Distingui la scadenza dal rifiuto o dalla mancata consegna.
- Evita di riattivare automaticamente i messaggi scaduti senza una decisione esplicita.
Ripristina il servizio con uno smaltimento controllato
Dopo un’interruzione, il ripristino non consiste semplicemente nel riprendere l’invio di tutti i messaggi in attesa. Verifica prima che la causa dell’accumulo sia stata risolta e che il sistema successivo sia in grado di accettare traffico. Poi rilascia il lavoro gradualmente, in base alla capacità disponibile e con limiti di concorrenza definiti dalla configurazione e dagli accordi applicabili.
Durante lo smaltimento, controlla se aumentano di nuovo l’anzianità o la profondità della coda, se crescono i rifiuti e se gli esiti restano quelli previsti. Una coda che si riduce non basta a dimostrare che il servizio è ripristinato se i messaggi scadono, vengono rifiutati o passano in verifica senza che il team se ne accorga.
- Individua e risolvi la causa dell’interruzione prima di accelerare gli invii.
- Riprendi con limiti controllati, senza scaricare in modo illimitato i messaggi accumulati.
- Verifica separatamente l’accettazione a valle e gli esiti successivi.
- Mantieni una procedura per sospendere di nuovo il flusso se l’accumulo ricompare o gli esiti peggiorano.
Monitora lo stato della coda, non solo la sua dimensione
La profondità indica quanti messaggi sono in attesa, ma da sola non chiarisce se la situazione stia migliorando. Aggiungi l’anzianità del messaggio più vecchio, il tasso di ingresso e quello di uscita, oltre agli esiti suddivisi per destinazione e classe. Interpreta queste metriche insieme agli eventi di ammissione, rifiuto, rinvio e scadenza.
L’accettazione da parte del sistema successivo va presentata come accettazione, non come consegna finale. Se si ricevono report di consegna, il loro significato dipende dalla fonte e dal livello di verifica: un DLR ricevuto non equivale necessariamente a una ricezione sul terminale verificata in modo indipendente. Documenta questa incertezza nei pannelli e nei report.
- Profondità della coda e anzianità del messaggio più vecchio.
- Tassi di ingresso e uscita su intervalli coerenti con l’operatività.
- Accettazioni, rifiuti, rinvii, scadenze e messaggi sottoposti a verifica.
- Esiti suddivisi per destinazione e classe, con definizioni coerenti.
- Avvisi legati a soglie operative proprie, riviste sulla base di dati reali.
Domande frequenti
L’accettazione di un messaggio a valle significa che è stato consegnato?
No. Indica che il sistema successivo ha accettato il messaggio in base alla risposta osservata. Da sola non dimostra che il telefono lo abbia ricevuto. Anche i report di consegna vanno interpretati in base alla fonte e al livello di verifica.
Quale dovrebbe essere la dimensione massima di una coda di uscita?
Non esiste un valore universale valido per tutte le piattaforme. Il limite dipende dalle risorse, dalle destinazioni, dalle classi di traffico, dagli accordi e dal comportamento osservato. Definiscilo sulla base dei dati operativi e prevedi un’azione esplicita al suo raggiungimento.
È opportuno riprovare l’invio di ogni messaggio rifiutato?
No. Per prima cosa stabilisci se la causa è temporanea, correggibile o permanente, usando la risposta e la documentazione dell’interfaccia collegata. Limita i nuovi tentativi, evita che mittente e piattaforma ripetano gli invii senza coordinarsi e non ritentare automaticamente contenuti scaduti.
Bisogna usare sempre FIFO?
FIFO è una scelta ragionevole quando è importante preservare l’ordine e i messaggi hanno requisiti simili. Se servono priorità, definisci classi e regole esplicite e controlla che una classe non lasci le altre in attesa a tempo indeterminato.
Fonti consultate
- SMPP v3.4, Issue 1.2SMPP Developers Forum
- HTTP Semantics (RFC 9110)IETF
- 3GPP specifications by series3GPP
- ITU-T Recommendation E.164International Telecommunication Union
- GSMA networks resourcesGSMA